
Điều gì thực sự diễn ra khi một bức ảnh học cách nói
Bên trong, hầu hết công cụ tạo ảnh biết nói AI đều chạy một phiên bản của cùng một quy trình. Trong một chủ đề trên r/generativeAI, người dùng mô tả nó qua hai giai đoạn: đầu tiên một mô hình tái hiện khuôn mặt tạo chuyển động tự nhiên cho ảnh tĩnh, sau đó một mô hình đồng bộ môi điều khiển bằng âm thanh định hình lại khuôn miệng theo từng âm trong đoạn giọng nói. Những cái tên mã nguồn mở xuất hiện nhiều nhất là SadTalker và LivePortrait cho chuyển động, Wav2Lip cho khuôn miệng, còn D-ID và HeyGen gói các bước tương tự thành sản phẩm.
Vì sao khuôn miệng là phần khó nhất
Các nhà nghiên cứu đứng sau MuseTalk, một mô hình đồng bộ môi được mô tả trong một bài báo trên arXiv, xem vấn đề này như một thế khó ba chiều. Các phương pháp dựa trên khuếch tán cho hình ảnh rất đẹp nhưng tốn kém khi chạy. Các phương pháp GAN nhanh hơn thường hy sinh độ chính xác của môi hoặc "chi tiết răng", cách nói lịch sự trong giới học thuật rằng răng bị nhòe. MuseTalk làm việc trong một không gian ẩn được nén để có cả tốc độ lẫn chi tiết, và cho biết đạt 30 khung hình mỗi giây ở độ phân giải 256 x 256 điểm ảnh trên một card đồ họa NVIDIA V100.
Con số độ phân giải đó đáng ghi nhớ. Mô hình chỉ vẽ lại một vùng nhỏ quanh khuôn miệng rồi hòa nó trở lại vào bức ảnh kích thước đầy đủ của bạn. Khi khuôn mặt nhỏ, quay đi hoặc thiếu sáng, sẽ có ít chi tiết thật hơn để xử lý, và đó thường là lúc ảo giác bị phá vỡ.
Nên nhìn vào đâu khi đánh giá
Một nhà sáng tạo nội dung đã so sánh HeyGen với một công cụ rẻ hơn trong một bài thử đặt cạnh nhau trên YouTube và đưa ra danh sách hữu ích: quan sát khóe miệng, để ý cái đầu làm gì khi câu kết thúc, và lắng nghe các phụ âm mạnh như P và B, vì đó "thường là chỗ các công cụ đồng bộ môi rẻ tiền hỏng hoàn toàn".
Bức ảnh bạn tải lên quyết định phần lớn kết quả
Nền tảng nào cũng chỉ có thể tạo chuyển động cho những gì có trong ảnh, nên bức ảnh đầu vào đáng được chăm chút hơn phần cài đặt. Lời khuyên từ những người làm loại video này mỗi tuần khá giống nhau.
- Nhìn thẳng vào máy ảnh. Một video hướng dẫn Hedra từ tháng 2 năm 2026 khuyên dùng ảnh rõ nét, khuôn mặt nhìn thẳng vào ống kính, đủ sáng, và tránh ảnh chụp nghiêng hay ảnh mờ. Video cũng lưu ý rằng Hedra từ chối ảnh nhỏ hơn 300 điểm ảnh.
- Bắt đầu với nét mặt trung tính. Cùng video đó gợi ý dùng biểu cảm trung tính nếu kết quả trông cứng, cùng với ánh sáng tốt hơn và âm thanh sạch, vì âm thanh rõ ràng "cải thiện độ chính xác của đồng bộ môi".
- Giữ clip ngắn. "Clip ngắn hơn trông chân thực hơn", video viết. Hãy chia một kịch bản dài thành nhiều video ngắn thay vì một cảnh quay dài.
- Làm dịu chuyển động. Một nhà sáng tạo dựng avatar từ một bức ảnh duy nhất trong video hướng dẫn HeyGen của cô thêm một câu lệnh chuyển động riêng, yêu cầu vẻ tự nhiên, ít lộ răng và không có tay, vì thiết lập mặc định có thể khiến nhân vật biểu cảm quá đà.
- Cung cấp nhiều hơn một ảnh nếu có thể. HeyGen gợi ý tải thêm vài ảnh của bạn để mô hình nắm bắt được nhiều chi tiết hơn.
Giọng nói quan trọng không kém khuôn mặt. Một đoạn giọng đều đều, vội vàng sẽ khiến ngay cả khuôn miệng hoàn hảo cũng trông sai. Hãy viết kịch bản để nói, đọc to một lần và cắt bỏ mọi câu khiến bạn vấp trước khi tạo bất cứ thứ gì.
BIGVU, HeyGen và Hedra: mỗi bên mang lại gì
Cả ba đều biến một bức ảnh thành avatar biết nói, nhưng được xây dựng cho những nhóm người mua khác nhau. Đây là những gì mỗi nhà cung cấp đang hiển thị trên trang của chính họ.
BIGVU AI Talking Photo
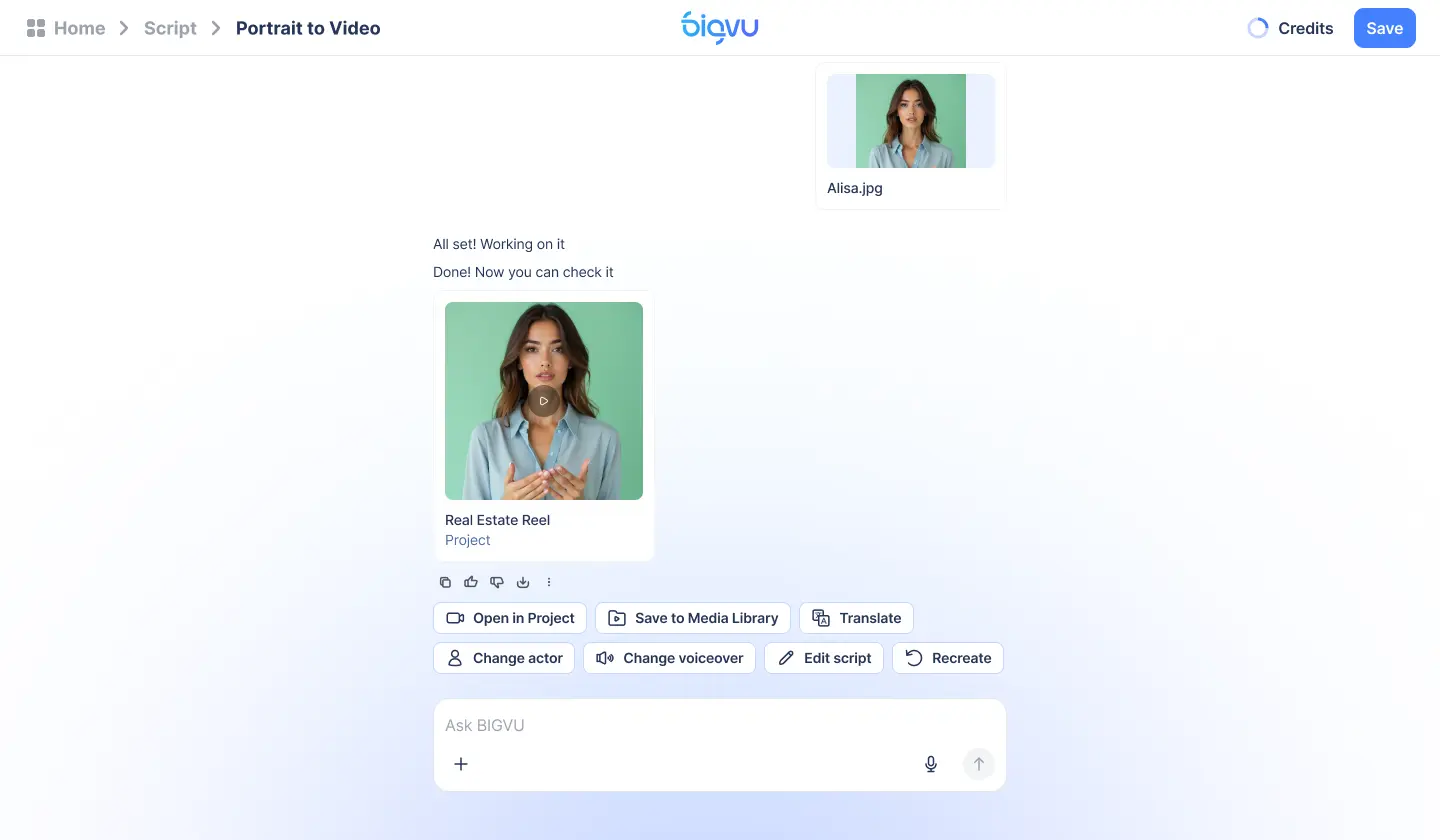
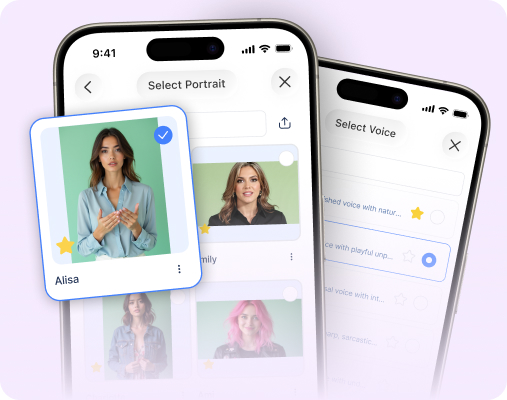
AI Talking Photo của BIGVU hoạt động theo ba bước: tải lên ảnh chân dung, thêm kịch bản và giọng nói, sau đó tạo video và đăng. Bạn có thể tự viết kịch bản hoặc soạn nháp bằng AI Script Generator, rồi chọn một giọng trong thư viện của BIGVU hoặc nhân bản giọng của chính bạn. Video đồng bộ môi sau đó ở lại trong cùng ứng dụng để thêm phụ đề, bộ nhận diện thương hiệu và đăng tải, và bạn có thể làm việc trên web, iPhone hoặc Android. Các tính năng AI dùng tín dụng hằng tháng, và trang bảng giá quy đổi chúng ra thời lượng video: 500 tín dụng của gói miễn phí đủ cho một video chân dung khoảng 10 giây, còn 3.000 tín dụng của AI Pro đủ cho khoảng một phút.
HeyGen Photo Avatar
Trang avatar từ ảnh của HeyGen quảng bá ảnh biết nói bằng hơn 175 ngôn ngữ và phương ngữ, câu lệnh văn bản và các gói phong cách giúp đổi trang phục hoặc phông nền, cùng công cụ Avatar IV có thể biến một bức ảnh thành video với giọng nói đồng bộ và cử chỉ tay. Trên trang bảng giá, gói miễn phí cho 3 video mỗi tháng có hình mờ, mỗi video tối đa 1 phút, gói Creator giá 29 đô la mỗi tháng với 600 tín dụng và gói Pro giá 49 đô la mỗi tháng với 1.000 tín dụng và video dài tối đa 30 phút.
Hedra
Bảng giá của Hedra chi tiết nhất trong ba bên. Với API, việc tạo avatar và đồng bộ môi bắt đầu từ 2,5 xu mỗi giây, trừ vào số dư đô la trả trước, không cần gói thuê bao, và nhân bản giọng nói miễn phí. Nếu bạn thích ứng dụng Studio, các gói đi từ Basic giá 20 đô la mỗi tháng cho 2.000 tín dụng, Pro giá 50 đô la cho 7.200 tín dụng, đến Ultra giá 100 đô la cho 18.000 tín dụng.
Tốt nhất hay đáng tiền nhất
Người làm bài thử đặt cạnh nhau nói thẳng: HeyGen thắng về độ chân thực, "thậm chí không có cửa so sánh", vậy mà anh lại dùng công cụ rẻ hơn thường xuyên hơn, vì avatar của anh chỉ mở đầu video trong 60 đến 80 giây trước khi các đoạn quay màn hình tiếp quản. Quy tắc của anh áp dụng cho bất kỳ công cụ video AI nào. Nếu khuôn mặt là sản phẩm, hãy trả tiền cho lựa chọn chân thực nhất. Nếu khuôn mặt chỉ là phần giới thiệu ngắn, đủ tốt là được.
Ảnh biết nói phát huy giá trị ở đâu, và ở đâu thì không
Ảnh biết nói tỏa sáng với những thông điệp lặp lại cần một gương mặt nhưng không cần đoàn quay phim. BIGVU liệt kê cập nhật thị trường, tin mới về bất động sản đang rao bán, giới thiệu khu dân cư, câu hỏi thường gặp, khuyến mãi, thông báo nội bộ và giải thích sản phẩm là những cách dùng điển hình, và điểm chung là sự lặp lại. Chỉ với một ảnh chân dung đã được duyệt, bạn có thể làm bản cập nhật thứ năm trong tháng mà không cần đặt lịch với ai.
Cách dùng phù hợp
- Phần mở đầu ngắn và cập nhật định kỳ. Một gương mặt quen thuộc trong phút đầu tiên, sau đó là slide, bản demo hoặc cảnh quay căn nhà.
- Tiếp thị qua email bằng video. Một lời chào cá nhân ở đầu email chăm sóc khách hàng nghe ấm áp hơn chỉ có chữ. Công cụ video email của BIGVU cho phép bạn gửi nó từ cùng một tài khoản.
- Tin rao không cần buổi quay. Môi giới bất động sản có thể kết hợp phần mở đầu bằng ảnh biết nói với Fototale, công cụ biến những bức ảnh sẵn có của căn nhà thành video với chuyển động lia, phóng to và hiệu ứng chuyển cảnh.
Cách dùng kém hiệu quả
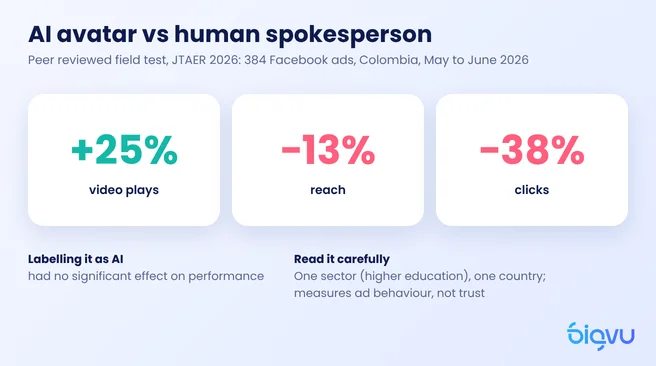
Hãy cẩn thận ở những nơi mà niềm tin là tất cả. Một thử nghiệm thực địa được bình duyệt với 384 quảng cáo Facebook, công bố năm 2026 trên Journal of Theoretical and Applied Electronic Commerce Research, cho thấy avatar AI có lượt phát video cao hơn 25% so với người phát ngôn thật, nhưng phạm vi tiếp cận thấp hơn 13% và số lượt nhấp ít hơn 38%. Nghiên cứu này xem xét quảng cáo giáo dục đại học ở Colombia, vì vậy hãy coi đây là một điểm dữ liệu, không phải định luật. Dù vậy, nó khớp với lời khuyên của nhà sáng tạo YouTube đã trích ở trên: với công việc cho khách hàng, một thương hiệu gắn với gương mặt cố định, hoặc bất cứ thứ gì mà khách hàng trả tiền sẽ soi từng khung hình, anh khuyên dùng công cụ chân thực nhất bạn có thể chi trả, hoặc quay thật.
Công khai, sự đồng ý và các quy định mới
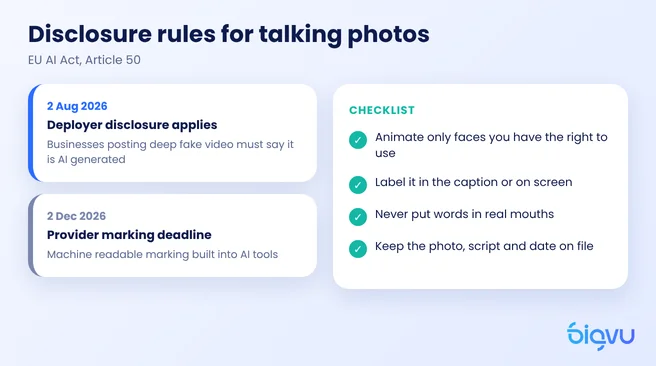
Đạo đức của ảnh biết nói từng chỉ là chuyện phép lịch sự. Ở Liên minh châu Âu, giờ đây đó còn là nghĩa vụ pháp lý. Điều 50 của Đạo luật AI của EU quy định rằng bên triển khai một hệ thống AI tạo ra hoặc chỉnh sửa video cấu thành deepfake phải công khai rằng nội dung đã được tạo ra hoặc chỉnh sửa một cách nhân tạo, và điều này phải rõ ràng chậm nhất vào lúc người xem nhìn thấy lần đầu. Như Morgan Lewis giải thích, các nghĩa vụ minh bạch này bắt đầu áp dụng từ ngày 2 tháng 8 năm 2026. Một giai đoạn chuyển tiếp riêng kéo dài bốn tháng, đến ngày 2 tháng 12, chỉ áp dụng cho việc đánh dấu mà máy có thể đọc được do nhà cung cấp tích hợp, và không hoãn nghĩa vụ của các doanh nghiệp đăng video.
Danh sách kiểm tra đơn giản
- Chỉ tạo chuyển động cho những gương mặt bạn có quyền dùng. Của chính bạn, hoặc của người đã cho phép rõ ràng. Không bao giờ dùng gương mặt của khách hàng, đối thủ hay người nổi tiếng khi chưa có sự đồng ý.
- Gắn nhãn. Một dòng ngắn trong chú thích hoặc trên màn hình, như "Video này sử dụng ảnh biết nói AI", đáp ứng nghĩa vụ cơ bản và hầu như không tốn gì.
- Đừng đặt lời vào miệng người thật. Một bức ảnh biết nói của chính bạn đọc kịch bản của bạn là một chuyện. Khiến ai đó trông như đang ủng hộ điều họ chưa từng nói là chuyện hoàn toàn khác.
- Lưu hồ sơ. Giữ lại ảnh gốc, kịch bản và ngày thực hiện, phòng khi có người hỏi video được làm như thế nào.
Nếu bạn lo rằng nhãn sẽ làm giảm kết quả, chính nghiên cứu quảng cáo Facebook đó lại khiến bạn yên tâm: cho người xem biết quảng cáo được làm bằng AI không có ảnh hưởng đáng kể đến hiệu quả. Ở đây, trung thực không tốn đồng nào.