Bắt đầu từ người nghe, không phải từ thương hiệu
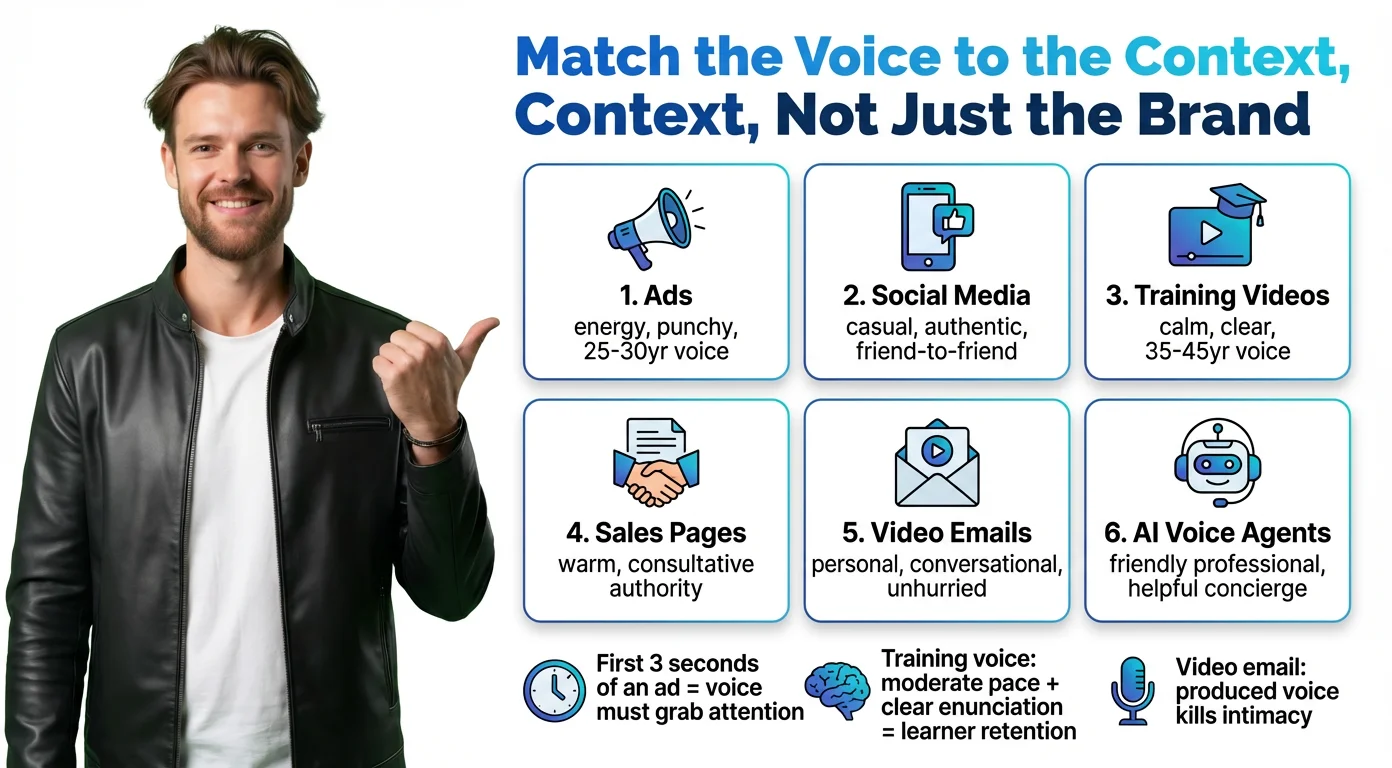
Sai lầm đầu tiên là coi giọng nói như màu thương hiệu: chọn một cái rồi dùng khắp nơi. Giọng tạo được niềm tin trên trang bán hàng có thể nghe cứng nhắc trong một clip mạng xã hội, và giọng quảng cáo hụt hơi sẽ gây mệt sau mười phút tài liệu đào tạo.
Đây là cách tôi sẽ điều chỉnh giọng theo từng trường hợp.
Quảng cáo và nội dung khuyến mãi
Bạn chỉ có khoảng ba giây để thu hút sự chú ý, nên giọng cần năng lượng và đà tiến. Nhân vật từ giữa 20 đến đầu 30 tuổi hợp với sản phẩm tiêu dùng. Giọng trầm và ổn định hơn hợp với B2B hoặc thương hiệu cao cấp. Hãy yêu cầu nhịp độ sôi nổi và cách đọc dứt khoát.
Video mạng xã hội
Mạng xã hội ưu ái cảm giác một người thật đang nói với bạn bè. Thoải mái, thẳng thắn, hơi hào hứng. Bất cứ thứ gì nghe như được dàn dựng đều phá hỏng không khí. Hãy yêu cầu giọng trò chuyện, gần gũi, nhịp tự nhiên.
Video đào tạo và giải thích
Người xem theo dõi lâu hơn, nên sự rõ ràng quan trọng hơn cá tính. Bình tĩnh và điềm đạm mà không đều đều. Nhân vật từ giữa 30 đến giữa 40 tuổi mang lại uy tín mà không xa cách. Hãy yêu cầu phát âm rõ, nhịp vừa phải, ấm áp nhưng mang tính hướng dẫn.
Trang bán hàng và landing page
Ở đây nhiệm vụ là xây dựng niềm tin. Giọng nên nghe như một cố vấn am hiểu, tự tin và ấm áp, không gây áp lực. Tránh mọi thứ nghe như diễn. Hãy yêu cầu giọng tư vấn, âm sắc mượt, uy tín trong trò chuyện.
Email video
Điều cốt lõi của email video là cảm giác cá nhân, và một giọng làm quá công phu phá hỏng điều đó chỉ trong một câu. Hãy nhắm tới cuộc trò chuyện riêng: ấm áp, không vội vã, có quãng nghỉ tự nhiên.
Tác nhân giọng nói AI (website và landing page video)
Giọng này thường là điểm chạm thương hiệu đầu tiên mà khách truy cập nghe thấy. Nó nên thân thiện và hữu ích: bớt giống kịch bản tổng đài, giống đồng nghiệp am hiểu hơn.
Độ tuổi gắn kết tất cả. Giọng 22 tuổi đọc mô đun tuân thủ nghe sai sai, còn giọng 55 tuổi trong quảng cáo TikTok nghe lạc quẻ. Đó là một trong những đòn bẩy bị bỏ quên nhiều nhất của thiết kế giọng nói.
Yếu tố "giống người" có thật sự quan trọng với người mua không? Một nghiên cứu của nhà cung cấp cho thấy khoảng cách nhỏ. Azerion, một công ty quảng cáo âm thanh của Anh, đã thử nghiệm quảng cáo với 3.000 thính giả vào tháng 3 và tháng 4 năm 2026. Chỉ 29% số người nghe bản AI nhận ra đúng là nhân tạo, và 78% đồng ý giọng AI nghe tự nhiên, so với 75% cho giọng người. Hãy xem đây là kết quả của nhà cung cấp cho hai thương hiệu quen thuộc, không phải quy tắc chung. Dù vậy, nó cho thấy người nghe đánh giá cách thể hiện trước tiên.

Cấu trúc của một câu lệnh giọng nói thực sự hiệu quả
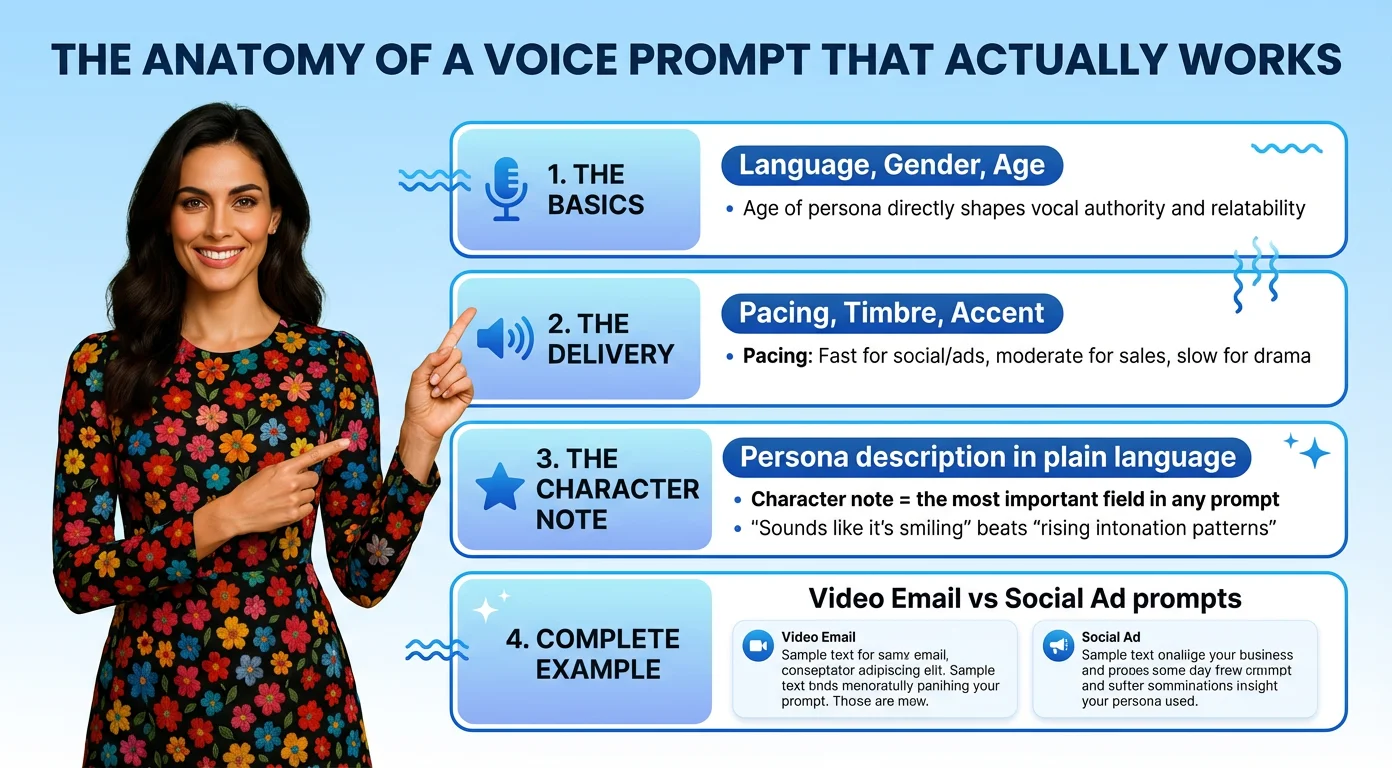
Câu lệnh giọng nói không phải danh sách tính từ. Nó là mô tả một nhân vật, đủ cụ thể để hai người đọc khác nhau hình dung cùng một người nói.
Câu lệnh mạnh có ba lớp.
Nền tảng: ngôn ngữ, giới tính và độ tuổi
Chúng đặt ra giới hạn bên ngoài. "Nữ, đầu 30, tiếng Anh Mỹ" tốt hơn hẳn "nữ". Độ tuổi định hình chất giọng, năng lượng và uy tín, nên đừng để mơ hồ.
Cách thể hiện: nhịp độ, âm sắc và giọng vùng
Nhịp độ điều khiển năng lượng: nhanh cho mạng xã hội và quảng cáo, vừa cho bán hàng và đào tạo, chậm cho kịch tính. Âm sắc là chất liệu của giọng: ấm, sáng, trầm, khàn, mượt. Giọng vùng thêm cá tính và bản địa hóa, và có thể quyết định giọng nghe bản xứ với khán giả của bạn hay hơi lạ tai.
Ghi chú tính cách: ô quan trọng nhất
Đây là nơi giọng chuyển từ chung chung sang cụ thể. Hãy mô tả con người, không phải âm học. "Nghe như đang mỉm cười khi nói chuyện với bạn" cho kết quả tốt hơn "mẫu ngữ điệu đi lên với độ gần phía trước".
Một số ghi chú tính cách thường hiệu quả:
- Ngôi sao radio: sáng, nhiều năng lượng, chỉn chu. Quảng cáo và khuyến mãi.
- Người dẫn chuyện điện ảnh: trầm, chậm rãi, kịch tính. Kể chuyện thương hiệu.
- Người dẫn podcast: thoải mái, ấm áp, tò mò. Bài giải thích và quan điểm chuyên gia.
- Huấn luyện viên thân thiện: rõ ràng, khích lệ, kiên nhẫn. Đào tạo và hội nhập.
- DJ đêm khuya: mượt, trầm, thân mật. Nội dung sang trọng và giàu không khí.
- Người đọc bản tin: dứt khoát, trung lập, có uy. Báo cáo và cập nhật.
Hai ví dụ hoàn chỉnh
Cho email video: "Giọng nữ ấm áp, thân thiện, đầu 30, tiếng Anh Mỹ, nhịp vừa phải. Trò chuyện và dễ gần, như một đồng nghiệp chia sẻ lời khuyên hữu ích bên tách cà phê. Một nụ cười nhẹ trong cách đọc. Chuyên nghiệp nhưng không bao giờ cứng nhắc."
Cho quảng cáo mạng xã hội: "Giọng nam tràn năng lượng, giữa 20, giọng Mỹ trung tính, nhịp nhanh. Tự tin và hào hứng, như người vừa tìm được thứ tuyệt vời và nóng lòng kể cho bạn. Âm sắc sáng, cách đọc dứt khoát."
Điều phân biệt các câu lệnh này với một câu lệnh yếu không phải độ dài. Chúng mô tả một cá tính, không chỉ các tham số.
Cách BIGVU biến câu lệnh thành giọng thương hiệu trong chưa đầy 2 phút
Viết câu lệnh là phần việc chiến lược. Tạo giọng nên trơn tru, và đó là điều công cụ Voice Design của BIGVU được xây dựng để làm.
Quy trình nằm trong Brand Kit, mục Branded Media. Nó chạy qua bốn bước.
Bước 1: đặt tham số
Chọn ngôn ngữ, giọng vùng, giới tính, nhịp độ, độ tuổi và âm sắc trong giao diện Voice Design. Đây là đầu vào kỹ thuật của bạn, khung mà AI làm việc bên trong.
Bước 2: viết ghi chú tính cách
Đây là ô câu lệnh quan trọng. BIGVU gọi nó là "ghi chú bổ sung", nhưng hãy coi nó như bản brief tuyển diễn viên. "Năng lượng ngôi sao radio", "điện ảnh và chậm rãi", "ấm áp và hài hước như người dẫn chương trình buổi sáng". Hãy viết nhân vật, không viết thông số.
Bước 3: tạo ba biến thể và chọn
BIGVU tạo ra ba cách diễn giải khác nhau từ câu lệnh của bạn. Nghe thử từng bản với kịch bản mẫu, so sánh cảm nhận và chọn một. Bạn cũng thấy mô tả bằng ngôn ngữ đơn giản về những gì đã được tạo, nên biết mình giữ lại gì.
Bước 4: đặt tên và lưu
Đặt tên cho giọng (BIGVU có thể gợi ý dựa trên ngôn ngữ và bối cảnh văn hóa), kiểm tra mô tả rồi lưu. Giọng được thêm ngay vào Content Bank của bạn, kèm ảnh chân dung do AI tạo (cận mặt, nửa người, toàn thân) sẵn sàng cho sản xuất video.
Toàn bộ quá trình mất chưa đến hai phút. Không casting, không studio, không diễn viên lồng tiếng. Giọng là của bạn, được lưu và dùng lại cho mọi video.
Cùng một quy trình áp dụng cho mọi ngôn ngữ. Giọng Bồ Đào Nha ấm áp cho Brazil, giọng Nhật chuyên nghiệp cho Tokyo, giọng Tây Ban Nha nhanh cho mạng xã hội Mỹ Latin: đổi ngôn ngữ, giọng vùng và ghi chú văn hóa, kết quả sẽ thích nghi.

Chỉ đạo cách đọc: thẻ âm thanh, quãng nghỉ và chính kịch bản
Một giọng hay là một nửa công việc. Nửa còn lại là cách câu thoại được thể hiện, và ở đây các công cụ khác nhau nhiều hơn những gì tiếp thị của họ thừa nhận.
Thẻ âm thanh trong ElevenLabs v4
ElevenLabs cho biết Eleven v4 và Eleven v3 hỗ trợ thẻ âm thanh: một chỉ dẫn ngắn trong ngoặc vuông, đặt ở chỗ cách thể hiện cần thay đổi. Trung tâm trợ giúp của họ liệt kê ví dụ như [curious], [whispers], [laughs] và [clears throat]. Một chi tiết thực tế từ tài liệu: Eleven v4 và v3 không hỗ trợ thẻ ngắt SSML, nên quãng nghỉ đến từ các thẻ như [pause] và [long pause], hoặc từ dấu câu. Trong ví dụ của chính ElevenLabs, cùng một câu ngắn kéo dài bốn giây khi không có thẻ [pause] và sáu giây khi có.
Một video hướng dẫn trên kênh chính thức của ElevenLabs bổ sung một quy trình hữu ích. Xếp chồng thẻ trên một dòng, ví dụ mở đầu lo lắng, một tiếng hắng giọng, rồi thì thầm ở một từ. Với kịch bản dài, nút Auto tag quét văn bản và thêm thẻ theo ngữ cảnh. Nếu thẻ vẫn trượt, hãy tự thu âm câu đó và dùng Voice Changer, vì "bạn càng tiến gần cách thể hiện mong muốn trong bản thu của mình, bạn càng tiến gần kết quả" (bản dịch của trích dẫn tiếng Anh).
Chỉ dẫn bằng ngôn ngữ thường ở công cụ khác
Các công cụ khác chọn lối đi khác. Hướng dẫn chuyển văn bản thành giọng nói của OpenAI dùng một trường chỉ dẫn, với ví dụ như "Speak in a cheerful and positive tone." Tuy vậy hãy kiểm tra ngày tháng trước khi dựa vào đó. Tài liệu của OpenAI nói các mô hình tts 1, tts 1 hd và gpt 4o mini tts "đã bị loại bỏ và sẽ ngừng hoạt động vào ngày 6 tháng 1 năm 2027" (bản dịch từ tiếng Anh). Google cho biết tính năng chuyển văn bản thành giọng nói của Gemini 3.8 cho phép bạn tự viết chỉ dẫn sân khấu và thêm tín hiệu như |mhm| để tạo chất trò chuyện. Hướng dẫn Octave của Hume nêu một điểm đúng ở mọi nơi: dùng văn bản đầu vào giàu biểu cảm để có giọng đọc giàu biểu cảm hơn, và viết hoa một từ để nhấn mạnh mạnh hơn.
Kịch bản quan trọng hơn bạn nghĩ
Nhà sáng tạo Isaac, người có video YouTube hơn 735.000 lượt xem, tóm giọng AI nghe như người thật vào bốn điều: thay đổi giọng điệu, quãng nghỉ, nhấn mạnh, và một kịch bản không bị đổ thẳng từ ChatGPT ra. Anh cũng tạo từng vài câu một thay vì cả kịch bản. Đó là lời khuyên dùng được với mọi công cụ giọng nói và không tốn gì.
Phản biện trung thực: thẻ không đáng tin tuyệt đối
Đừng mong thẻ lúc nào cũng nghe lời. Người đánh giá Janine Heinrichs của Unite.AI viết vào tháng 9 năm 2026 rằng "điểm yếu lớn nhất là việc tuân thủ thẻ biểu diễn không nhất quán" (bản dịch từ tiếng Anh). Isaac nhận thấy khi thêm thẻ v3 vào bản sao giọng của chính mình, "nó làm thay đổi nhẹ chính giọng nói", nên anh quay lại v2 với độ ổn định thấp hơn. Video của anh có trước v4, vì vậy lời phàn nàn đó có thể không còn đúng. Câu trả lời thực tế: dùng ít thẻ, đặt ngay trước những từ cần tác động, và nghe lại từng lần thu.
Thêm một lưu ý về các tuyên bố hiệu năng. ElevenLabs cho biết Eleven v4 được Artificial Analysis xếp số một và được khoảng 75% người nghe ưa chuộng trong các bài kiểm tra mù. Đó là con số của chính ElevenLabs, và Google cũng tự tuyên bố vị trí số một cho Gemini 3.8 trên một bộ đánh giá khác. Hãy thử với kịch bản của riêng bạn.
Lỗi viết câu lệnh thường gặp, và vì sao nghe giống người không có nghĩa là giấu giếm
Phần lớn giọng đọc không đạt thất bại vì cùng một vài lý do.
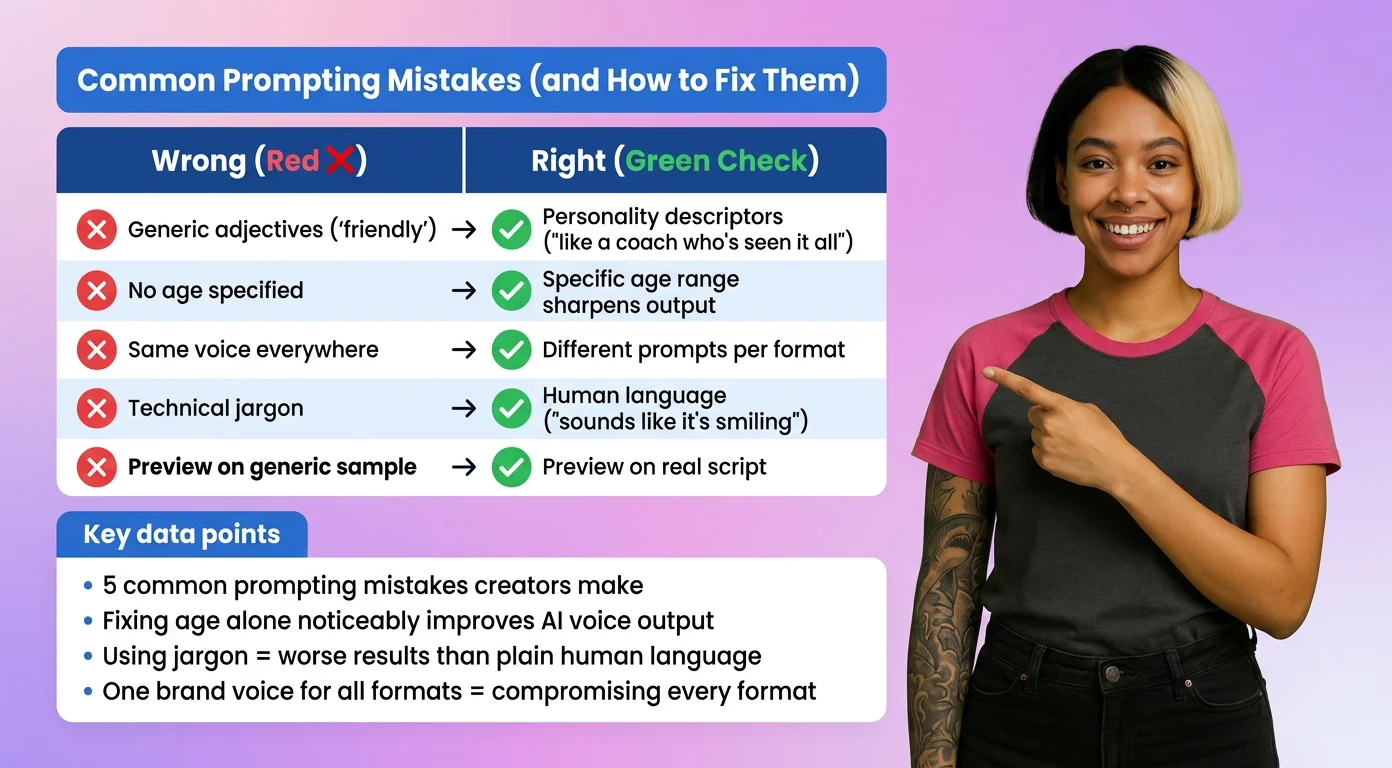
Chỉ dùng tính từ chung chung
"Chuyên nghiệp", "thân thiện", "rõ ràng". Giọng nào tử tế cũng thế, nên những từ này gần như không cho AI gì cả. Hãy thay bằng cá tính: "như một huấn luyện viên dày dạn đã thấy đủ chuyện nhưng vẫn hào hứng giúp đỡ".
Bỏ qua độ tuổi
Không có mốc tuổi, giọng sẽ rơi vào mức trung bình, thường ổn và hiếm khi hay. Nêu rõ khoảng tuổi và kết quả sẽ sắc nét hơn.
Dùng một giọng cho mọi nơi
Một giọng thương hiệu cho mọi định dạng không phục vụ tốt định dạng nào. Trang bán hàng, clip mạng xã hội và video hội nhập của bạn có nhiệm vụ khác nhau. Hãy cho chúng các biến thể câu lệnh khác nhau.
Viết thuật ngữ thay vì mô tả
"Biến thiên ngữ điệu" và "vocal fry" có thể chính xác, nhưng mô hình phản hồi tốt hơn với ngôn ngữ đời thường. Hãy mô tả trải nghiệm khi nghe. "Nghe như đang mỉm cười" thắng "cao độ tăng với điều biến đi lên".
Bỏ qua bước nghe thử với kịch bản thật
Một giọng có thể tỏa sáng với câu mẫu và đuối với nội dung thật của bạn. Hãy nghe thử một hai dòng từ kịch bản mà nó sẽ đọc.
Cố gắng giả làm người thật
Đây là vấn đề đạo đức cũng như thực tế. Chính sách sử dụng của OpenAI "yêu cầu bạn thông báo rõ ràng cho người dùng cuối rằng giọng TTS họ đang nghe do AI tạo ra" (bản dịch từ tiếng Anh). Khảo sát của Adobe năm 2026 với 850 người tiêu dùng Mỹ cho thấy 88% từng nghe một giọng và tự hỏi liệu đó có phải AI, trong khi 77% vẫn tin giọng người nhất. Adobe bán công cụ âm thanh AI, nên hãy đọc đây là nghiên cứu của nhà cung cấp. Cách hiểu hợp lý về "nghe giống người" là cách thể hiện tự nhiên, ấm áp, nhịp tốt, chứ không phải che giấu việc một cỗ máy đang nói.
Bản sao giọng nâng mức đặt cược. Một nghiên cứu PLOS One năm 2025 cho thấy người nghe không thể phân biệt đáng tin giữa bản sao giọng và giọng người thật, nhưng nhận ra được giọng AI phổ thông. Mẫu nhỏ, 50 người tham gia mỗi thí nghiệm, nhưng bài học rõ ràng: nếu giọng của bạn có thể đánh lừa người ta, hãy nói rõ.