
Wat gebeurt er eigenlijk als een foto leert praten?
Onder de motorkap draaien de meeste AI-sprekende fototools een versie van dezelfde pijplijn. In een overzicht van r/generativeAI hebben gebruikers het in twee fasen beschreven: eerst geeft een gezichtsheropvoeringsmodel het stilstaande beeld natuurlijke beweging, vervolgens hervormt een audiogestuurd lipsynchronisatiemodel de mond zodat deze bij elk geluid in de stemtrack past. De open source-namen die steeds weer opduiken zijn SadTalker en LivePortrait voor beweging en Wav2Lip voor de mond, terwijl D-ID en HeyGen soortgelijke stappen in een product verpakken.
Waarom de mond het moeilijkste deel is
Onderzoekers achter MuseTalk, een lipsynchronisatiemodel beschreven in een artikel over arXiv , omschrijven het probleem als een trilemma. Op diffusie gebaseerde methoden zien er geweldig uit, maar zijn duur in het gebruik. Snellere op GAN gebaseerde methoden hebben de neiging om de nauwkeurigheid van de lipsynchronisatie of 'tandheelkundige details' op te offeren, wat de beleefde academische manier is om te zeggen dat de tanden papperig worden. MuseTalk werkt in een gecomprimeerde latente ruimte om zowel snelheid als detail te verkrijgen, en rapporteert 30 frames per seconde bij 256 bij 256 pixels op een enkele NVIDIA V100 grafische kaart.
Dat resolutiecijfer is het onthouden waard. Het model tekent slechts een klein gebied rond de mond opnieuw en voegt dit vervolgens weer samen in uw afbeelding op volledige grootte. Als het gezicht klein is, afgewend of slecht belicht, zijn er minder echte details om mee te werken, en dat is meestal waar de illusie doorbreekt.
Waar moet je kijken als je er een beoordeelt?
Een maker die HeyGen in een side-by-side test op YouTube vergeleek met een goedkoper hulpmiddel, gaf een handige checklist: let op de mondhoeken, kijk wat het hoofd doet als een zin eindigt, en luister naar harde medeklinkers zoals P en B, want dat is "meestal waar goedkopere lipsynchronisatietools volledig uit elkaar vallen."
De foto die u uploadt, bepaalt het grootste deel van het resultaat
Elk platform kan alleen animeren wat er in beeld staat, dus de invoer verdient meer zorg dan de instellingen. De adviezen van mensen die deze video's wekelijks maken, komen nauw overeen.
- Kijk naar de camera. Een Hedra-tutorial uit februari 2026 beveelt een duidelijke foto aan waarbij het gezicht recht in de lens kijkt, goed verlicht, en waarschuwt voor zijprofielen en wazige opnamen. Het wijst er ook op dat Hedra afbeeldingen kleiner dan 300 pixels afwijst.
- Begin neutraal. Dezelfde tutorial suggereert een neutrale uitdrukking als het resultaat er stijf uitziet, plus betere verlichting en zuiver geluid, aangezien heldere audio "de nauwkeurigheid van de lipsynchronisatie verbetert".
- Houd clips kort. "Korte clips zien er realistischer uit", merkt de tutorial op. Splits een lang script op in meerdere korte video's in plaats van één lange take.
- Kalmeer de beweging. Een maker die avatars bouwt op basis van een enkele afbeelding in haar HeyGen-walkthrough, voegt een aangepaste bewegingsprompt toe waarin wordt gevraagd om een natuurlijke uitstraling, weinig zichtbare tanden en geen handen, omdat de standaard karakters overdreven expressief kan maken.
- Geef het meer dan één kans als je kunt. HeyGen stelt voor om een paar extra foto's van jezelf te uploaden, zodat het model meer details kan vastleggen.
De stem is net zo belangrijk als het gezicht. Een vlakke, gehaaste stemtrack zorgt ervoor dat zelfs een perfecte mond er verkeerd uitziet. Schrijf het script voor het spreken, lees het een keer hardop en knip elke zin waar je over struikelt af voordat je iets genereert.
BIGVU versus HeyGen versus Hedra: wat elk je geeft
Alle drie veranderen ze een foto in een pratende avatar , maar ze zijn gebouwd voor verschillende kopers. Dit is wat elke leverancier momenteel op zijn eigen pagina's laat zien.
BIGVU AI pratende foto
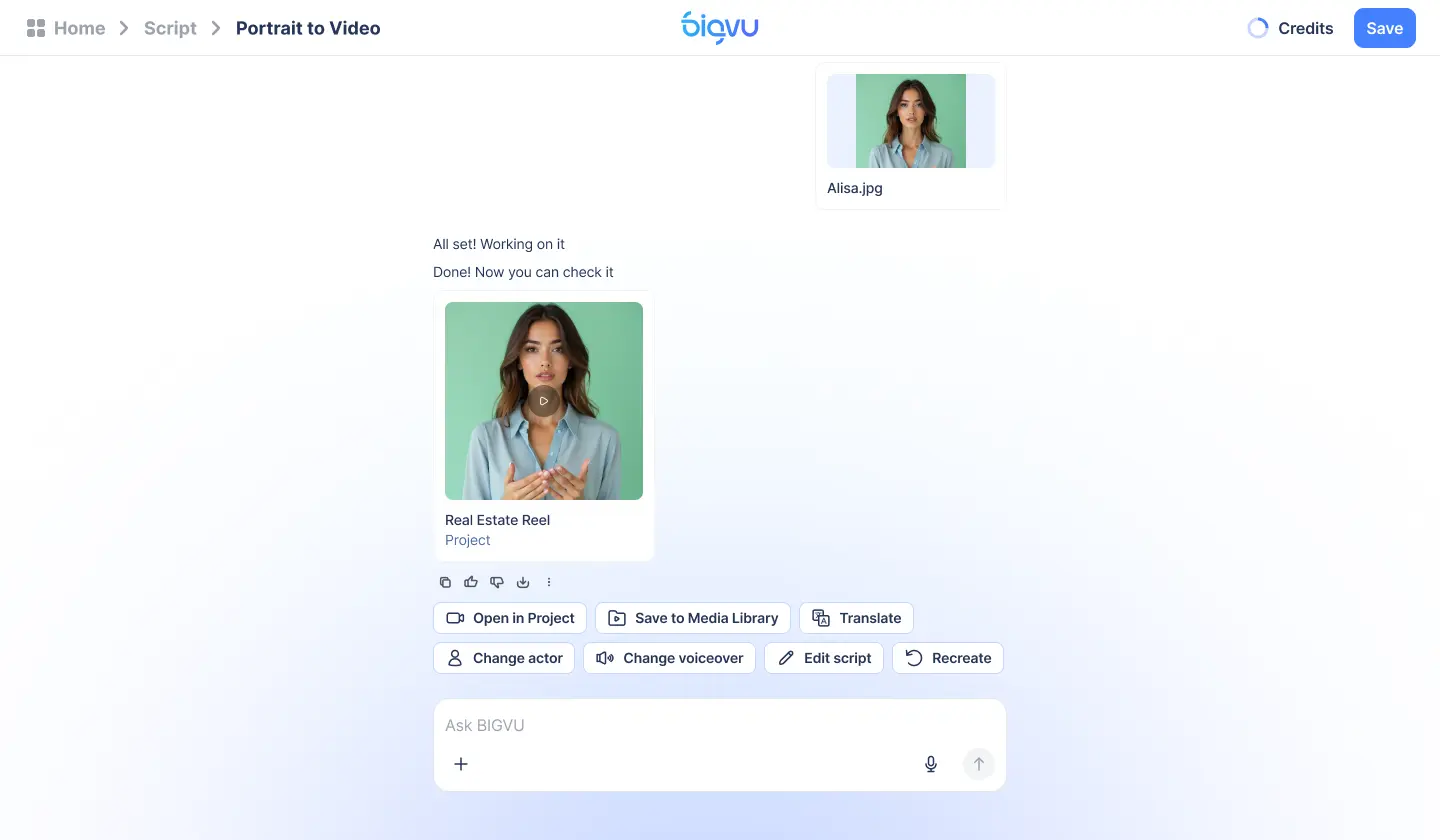
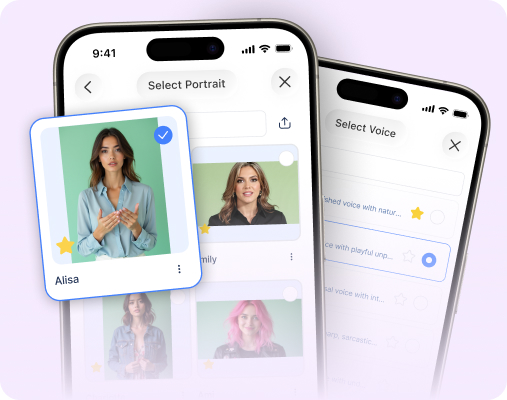
BIGVU's AI Talking Photo werkt in drie stappen: upload een portret, voeg uw script en stem toe, genereer en publiceer vervolgens. Je kunt het script zelf schrijven of opstellen met de AI Script Generator , en een stem uit de BIGVU-bibliotheek kiezen of je eigen stem klonen . De lipgesynchroniseerde video blijft dan in dezelfde app voor ondertiteling, uw merkkit en publicatie, en u kunt werken vanaf internet, iPhone of Android. AI-functies zijn gebaseerd op maandelijkse credits, en de prijspagina vertaalt deze in videotijd: de 500 credits van het gratis abonnement dekken ongeveer een portretvideo van 10 seconden, de 3.000 credits van AI Pro ongeveer één minuut.
HeyGen-foto-avatar
De fotoavatarpagina van HeyGen maakt reclame voor pratende foto's in meer dan 175 talen en dialecten, tekstprompts en lookpakketten die je outfit of achtergrond veranderen, en de Avatar IV-engine, die een enkele afbeelding omzet in een video met stemsynchronisatie en handgebaren. Op de prijspagina , gecontroleerd op 1 november 2026, geeft het gratis abonnement je 3 video's met watermerk per maand van elk maximaal 1 minuut, Creator kost $ 29 per maand met 600 credits, en Pro kost $ 49 per maand met 1.000 credits en video's van maximaal 30 minuten. Houd er rekening mee dat HeyGen zegt dat credits vervallen als je annuleert, en in onze gratis account waren downloads beperkt tot 720p.
Hedra
Hedra's openbare prijspagina toont niet langer maandabonnementen. Het rekent per output af van een prepaid dollarsaldo: het genereren van avatar en lipsynchronisatie vanaf 2,5 cent per seconde, opschalen met 2,14 cent per seconde, bewerken met 7 cent per seconde en opnieuw belichten met 20 cent per seconde, zonder abonnement.
Wat er gebeurde toen we er een maakten over Hedra
We zijn begonnen met het gratis abonnement van Hedra, dat 100 credits bevatte. Het maken van de startafbeelding kostte 7 credits en duurde ongeveer een halve minuut. Voor het spreekgedeelte kozen we voor Hedra Avatar, typten een script van zeven seconden en hielden de standaardstem op 720p. Op de knop Genereer stond 85 credits. Het saldo daalde met 40 en het resultaat was een clip van 6 seconden, 1280 x 720 met een watermerk, klaar in ongeveer twee minuten. De modelkiezer liet ook zien hoe breed de kosten kunnen variëren: MiniMax H3 Max werd met 50 tot 240 credits per generatie als beste waarde bestempeld, terwijl Seedance 2.5 met 84 tot 3.322 credits als hoogste kwaliteit werd bestempeld.
Er viel nog één ding op. Op geen enkel moment vertoonde de stroom een AI-openbaarmakingslabel, een toestemmingscontrole of een vraag of we de rechten op de foto hadden. Het watermerk was de enige markering. Dat legt de verantwoordelijkheid voor openbaarmaking volledig bij u, wat van belang is voor de onderstaande regels.
Beste versus de moeite waard
De maker achter de side-by-side-test hierboven was bot: HeyGen won op realisme, "het komt niet eens in de buurt", maar hij gebruikt de goedkopere tool vaker, omdat zijn avatar een video slechts 60 tot 80 seconden opent voordat schermopnamen het overnemen. Zijn regel geldt voor al deze AI-videotools . Als het gezicht het product is, betaal dan voor de meest realistische optie. Als het gezicht een korte introductie is, is goed genoeg goed genoeg.
Waar pratende foto's hun brood verdienen, en waar niet
Sprekende foto's schijnen op terugkerende berichten die een gezicht nodig hebben, maar geen filmploeg. BIGVU somt marktupdates, lijstupdates, buurtspots, veelgestelde vragen, promo's, interne aankondigingen en productuitleggers op als typische toepassingen, en de rode draad is herhaling. Zodra u één goedgekeurd portret heeft, kunt u de vijfde update van de maand maken zonder iemands tijd te reserveren.
Goede pasvormen
- Korte intro's en terugkerende updates. De eerste minuut een bekend gezicht, daarna dia's, demo's of opnames.
- Video-e-mailmarketing. Een persoonlijke begroeting bovenaan een vervolgmail voelt warmer aan dan gewone tekst. Met de video-e-mailtool van BIGVU kunt u deze vanaf hetzelfde account verzenden.
- Advertenties zonder shoot. Makelaars in onroerend goed kunnen een pratende foto-intro koppelen aan Fototale , waarmee bestaande advertentiefoto's worden omgezet in een video met pannen, zoomlenzen en overgangen.
Zwakke pasvormen
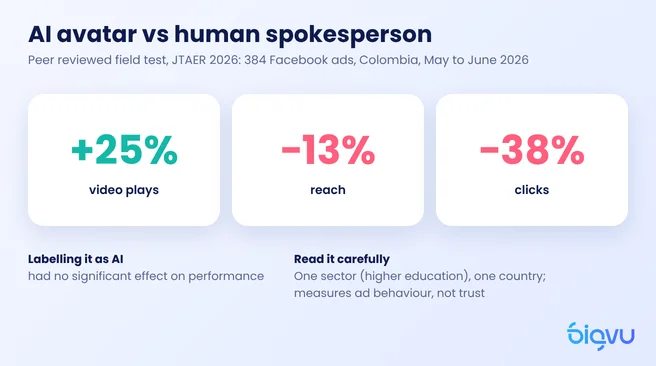
Wees voorzichtig als vertrouwen het hele punt is. Uit een peer-reviewed veldtest van 384 Facebook-advertenties, gepubliceerd in de Journal of Theoretical and Applied Electronic Commerce Research in 2026, bleek dat een AI-avatar 25% meer videoweergaven opleverde dan een menselijke woordvoerder, maar 13% minder bereik en 38% minder klikken. Het onderzoek had betrekking op advertenties voor hoger onderwijs in Colombia, dus behandel dit als één datapunt en niet als een wet. Toch komt het overeen met het eerder aangehaalde advies van de YouTube-maker: voor werk van een klant, een merk van een woordvoerder of wat dan ook dat een betalende klant frame voor frame bestudeert, raadt hij het meest realistische hulpmiddel aan dat je je kunt veroorloven, of een echte opname.
Openbaarmaking, toestemming en de nieuwe regels
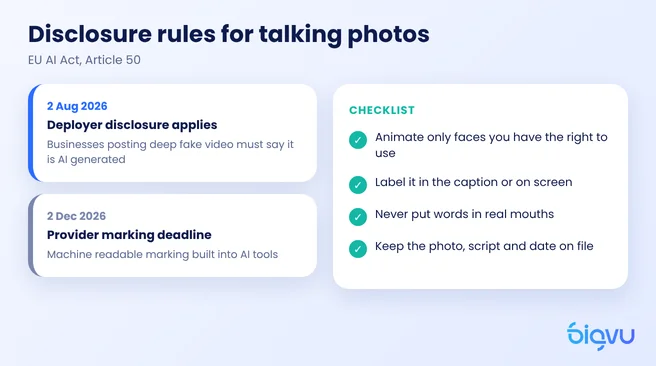
De ethiek van pratende foto's was vroeger een kwestie van goede manieren. In de Europese Unie is het nu ook een wettelijke plicht. Artikel 50 van de EU AI Act zegt dat iedereen die een AI-systeem inzet dat video genereert of manipuleert die een deep fake is, “moet onthullen dat de inhoud kunstmatig is gegenereerd of gemanipuleerd”, en dat dit uiterlijk duidelijk moet zijn wanneer een kijker deze voor het eerst ziet. Zoals Morgan Lewis heeft uitgelegd , zijn deze transparantieverplichtingen van toepassing geworden op 2 augustus 2026. Een afzonderlijke overgang van vier maanden tot 2 december heeft alleen betrekking op de machinaal leesbare markering die providers moeten inbouwen, en stelt de taken van de bedrijven die de video's plaatsen niet uit.
Op 10 juni 2026 publiceerde de Europese Commissie ook een definitieve praktijkcode voor het markeren en labelen van door AI gegenereerde inhoud, met een reeksEU-pictogrammen voor volledig door AI gegenereerde en gedeeltelijk door AI gemodificeerde inhoud. Een sprekende foto van een echte persoon is een schoolvoorbeeld voor dat label.
Een eenvoudige checklist
- Animeer alleen gezichten waarvoor u gebruiksrecht heeft. Die van uzelf, of van iemand die u expliciet toestemming heeft gegeven. Nooit een klant, een concurrent of een beroemdheid zonder toestemming.
- Label het. Een korte regel in het bijschrift of op het scherm, zoals 'Deze video maakt gebruik van een sprekende AI-foto', dekt de basisplicht en kost u heel weinig.
- Leg geen woorden in echte monden. Een pratende foto van jezelf terwijl je je eigen script leest, is één ding. Iemand de indruk geven iets te onderschrijven wat hij nooit heeft gezegd, is iets anders.
- Houd een verslag bij. Bewaar de originele foto, het script en de datum, voor het geval iemand vraagt hoe een video is gemaakt.
Zal een label de resultaten schaden? Het bewijsmateriaal is gemengd. Uit het Facebook-advertentieonderzoek hierboven bleek dat het vertellen aan kijkers dat een advertentie met AI was gemaakt geen significant effect had op de prestaties. Een onderzoek uit 2025 onder 358 consumenten in de Journal of Research in Interactive Marketing ontdekte het tegenovergestelde: openbaarmaking verlaagde hoe waardevol mensen de advertentie vonden en hun intentie om te kopen. Wij zijn van mening dat het label sowieso verplicht is in de EU, dus de betere vraag is hoe je de video de moeite van het bekijken waard kunt maken zodra mensen het weten. Een echt script, een echt aanbod en een stem die klinkt alsof je een heel eind komt.
Als je deze liever niet zelf produceert, kan het SuperAgent -team van BIGVU je maandelijkse video's maken met een TalkingPhoto in je gekloonde stem, met een toegewijde strateeg, bijschriften en thumbnails, 8 video's per maand vanaf $ 299 per maand, maandelijks gefactureerd.