Begin bij de luisteraar, niet bij het merk
De eerste fout is een stem behandelen als een merkkleur: kies er één en gebruik hem overal. Een stem die vertrouwen wekt op een verkooppagina kan stijf klinken in een social clip, en een buiten adem reclamestem is na tien minuten trainingsmateriaal vermoeiend.
Zo zou ik de stem per toepassing aanpassen.
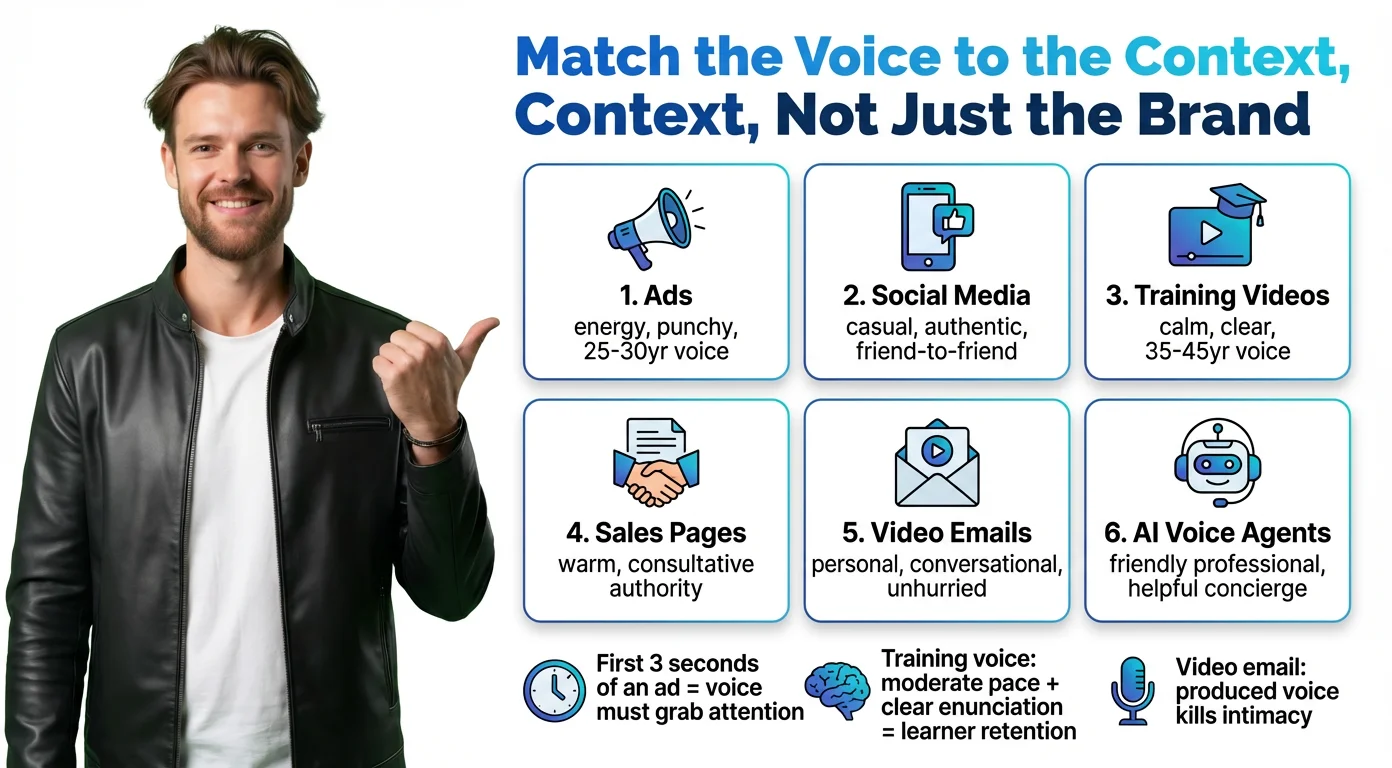
Advertenties en promotiecontent
Je hebt zo'n drie seconden om aandacht te winnen, dus de stem heeft energie en vaart nodig. Een persona van midden twintig tot begin dertig past bij consumentenproducten. Een diepere, rustigere toon past bij B2B of premiummerken. Vraag om levendig tempo en pittige voordracht.
Socialemediavideo's
Social beloont het gevoel dat een echt mens tegen een vriend praat. Ontspannen, direct, een beetje enthousiast. Alles wat geproduceerd klinkt, verbreekt de betovering. Vraag om een gesprekstoon, herkenbaar en natuurlijk tempo.
Trainings en uitlegvideo's
Mensen volgen deze langer, dus duidelijkheid weegt zwaarder dan persoonlijkheid. Kalm en beheerst zonder vlak te worden. Een persona van midden dertig tot midden veertig geeft gezag zonder afstand. Vraag om heldere articulatie, gematigd tempo, warm maar instructief.
Verkoop en landingspagina's
Hier draait het om vertrouwen. De stem moet klinken als een deskundig adviseur, zelfverzekerd en warm, zonder druk. Vermijd alles wat gespeeld voelt. Vraag om een adviserende toon, zacht timbre, gezag in gesprekstoon.
Videomails
Het hele punt van een videomail is dat hij persoonlijk voelt, en een overgeproduceerde stem maakt dat in één zin kapot. Mik op een gesprek onder vier ogen: warm, onhaastig, met natuurlijke pauzes.
AI spraakagenten (website en videolandingspagina's)
Deze stem is vaak het eerste merkcontact dat een bezoeker hoort. Hij moet vriendelijk en behulpzaam zijn: minder callcenterscript, meer deskundige collega.
Leeftijd bindt dit allemaal samen. Een stem van 22 die een compliancemodule inspreekt, voelt verkeerd, en een stem van 55 in een TikTok advertentie voelt losgekoppeld. Het is een van de meest onderbenutte hefbomen in stemontwerp.
Telt het menselijke echt voor kopers? Een leveranciersstudie wijst op een klein verschil. Azerion, een Brits bedrijf voor audioreclame, testte in maart en april 2026 advertenties met 3.000 luisteraars. Slechts 29% van wie de AI versie hoorde, noemde die terecht kunstmatig, en 78% vond de AI stem natuurlijk klinken, tegenover 75% voor de menselijke stem. Zie dit als een leveranciersresultaat voor twee bekende merken, niet als algemene regel. Toch laat het zien dat luisteraars eerst de voordracht beoordelen.

De opbouw van een stemprompt die echt werkt
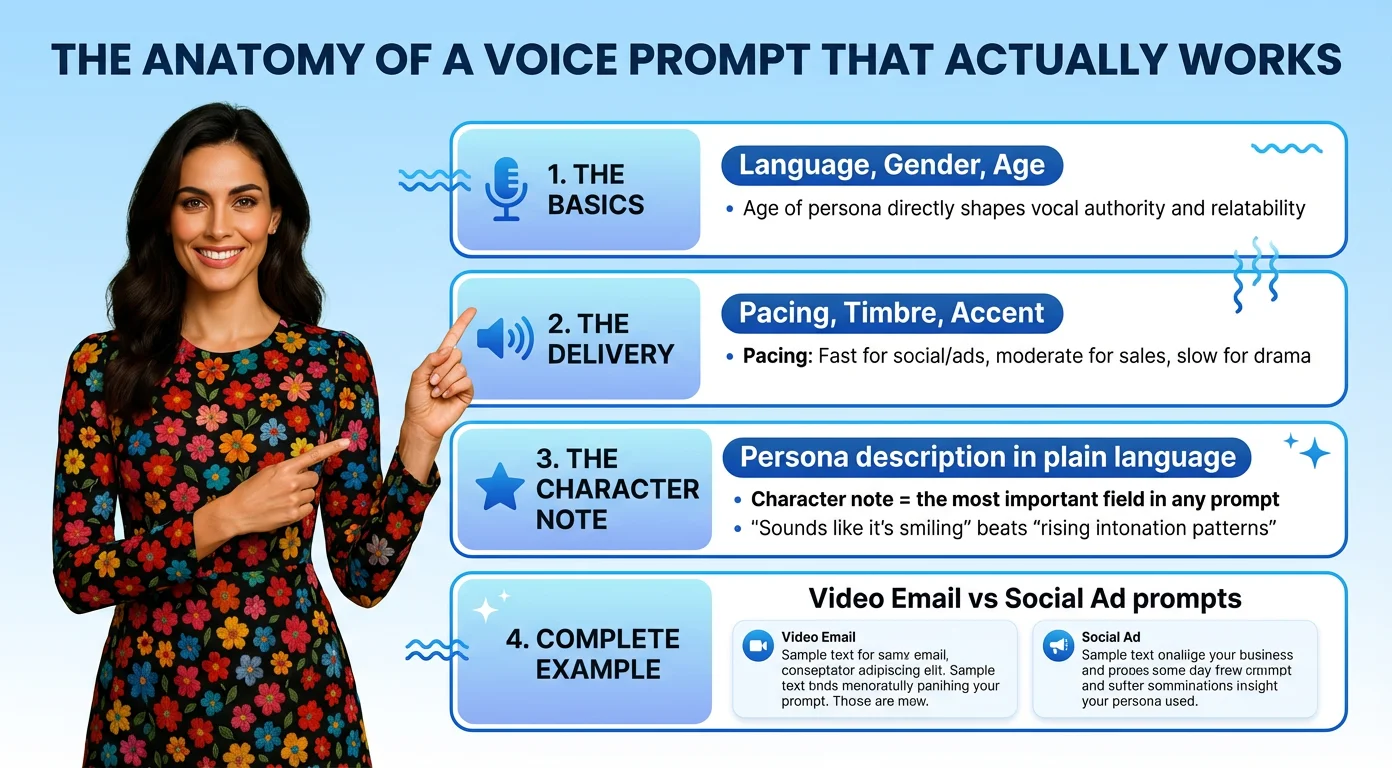
Een stemprompt is geen lijst met bijvoeglijke naamwoorden. Het is een karakterbeschrijving, zo concreet dat twee verschillende lezers zich dezelfde spreker voorstellen.
Sterke prompts hebben drie lagen.
De basis: taal, geslacht en leeftijd
Dit zet de buitengrenzen. "Vrouw, begin dertig, Amerikaans Engels" is veel beter dan "vrouw". Leeftijd bepaalt stemkwaliteit, energie en gezag, dus laat hem niet vaag.
De voordracht: tempo, timbre en accent
Tempo stuurt de energie: snel voor social en advertenties, gematigd voor verkoop en training, traag voor drama. Timbre is de textuur van de stem: warm, helder, diep, hees, zacht. Accent geeft karakter en lokalisatie en kan bepalen of een stem voor jouw publiek vertrouwd of net vreemd klinkt.
De karakternotitie: het belangrijkste veld
Hier wordt een stem van generiek specifiek. Beschrijf de persoon, niet de akoestiek. "Klinkt alsof ze lacht terwijl ze tegen je praat" levert een beter resultaat dan "stijgende intonatiepatronen met frontale nabijheid".
Karakternotities die vaak goed werken:
- Radioster: helder, veel energie, gepolijst. Advertenties en promo's.
- Filmische verteller: diep, bedachtzaam, dramatisch. Merkverhalen.
- Podcastpresentator: ontspannen, warm, nieuwsgierig. Uitleg en thought leadership.
- Vriendelijke coach: helder, bemoedigend, geduldig. Training en onboarding.
- Nacht dj: zacht, laag, intiem. Luxe en sfeercontent.
- Nieuwslezer: scherp, neutraal, gezaghebbend. Rapporten en updates.
Twee complete voorbeelden
Voor een videomail: "Warme, vriendelijke vrouwenstem, begin dertig, Amerikaans Engels, gematigd tempo. Gesprekachtig en benaderbaar, als een collega die onder het genot van koffie een nuttig advies deelt. Een lichte glimlach in de voordracht. Professioneel maar nooit stijf."
Voor een social advertentie: "Energieke mannenstem, midden twintig, neutraal Amerikaans accent, snel tempo. Zelfverzekerd en enthousiast, als iemand die net iets geweldigs heeft gevonden en niet kan wachten het te vertellen. Helder timbre, pittige voordracht."
Wat deze prompts onderscheidt van een zwakke is niet de lengte. Ze beschrijven een persoonlijkheid, niet alleen parameters.
Hoe BIGVU een prompt in minder dan 2 minuten omzet in een merkstem
De prompt schrijven is het strategische werk. De stem genereren moet soepel gaan, en daar is de Voice Design tool van BIGVU voor gebouwd.
De workflow zit in de Brand Kit, onder Branded Media. Het loopt in vier stappen.
Stap 1: stel de parameters in
Kies taal, accent, geslacht, tempo, leeftijd en timbre in de Voice Design interface. Dit zijn je technische invoer, het kader waarbinnen de AI werkt.
Stap 2: schrijf de karakternotitie
Dit is het promptveld dat telt. BIGVU noemt het "extra notities", maar behandel het als een castingbrief. "Radiosterenergie", "filmisch en langzaam opbouwend", "warm en grappig als een ochtendshowpresentator". Schrijf het karakter, niet de specificaties.
Stap 3: genereer drie varianten en kies
BIGVU maakt drie verschillende interpretaties van je prompt. Luister naar elke met een voorbeeldscript, vergelijk hoe ze overkomen en kies er één. Je ziet ook een beschrijving in gewone taal van wat er is gegenereerd, zodat je weet wat je bewaart.
Stap 4: geef een naam en bewaar
Geef de stem een naam (BIGVU kan er een voorstellen op basis van taal en cultuur), controleer de beschrijving en bewaar. De stem komt direct in je Content Bank, met AI gegenereerde portretten (hoofd, bovenlijf, volledig) klaar voor videoproductie.
Het hele proces duurt minder dan twee minuten. Geen casting, geen studio, geen stemacteur. De stem is van jou, opgeslagen en herbruikbaar in al je video's.
Dezelfde workflow geldt in elke taal. Een warme Portugese stem voor Brazilië, een professionele Japanse stem voor Tokio, een snelle Spaanse stem voor social in Latijns Amerika: pas taal, accent en culturele notities aan en het resultaat past zich aan.

De voordracht regisseren: audiotags, pauzes en het script zelf
Een goede stem is het halve werk. De andere helft is hoe de zin wordt gebracht, en daar verschillen de tools meer dan hun marketing toegeeft.
Audiotags in ElevenLabs v4
ElevenLabs zegt dat Eleven v4 en Eleven v3 audiotags ondersteunen: een korte instructie tussen vierkante haken, geplaatst waar de voordracht moet veranderen. Het helpcentrum noemt voorbeelden als [curious], [whispers], [laughs] en [clears throat]. Een praktisch detail uit de documentatie: Eleven v4 en v3 ondersteunen geen SSML pauzetags, dus pauzes komen van tags als [pause] en [long pause], of van interpunctie. In een voorbeeld van ElevenLabs zelf duurde dezelfde korte zin vier seconden zonder [pause] en zes seconden met.
Een tutorial op het officiële ElevenLabs kanaal voegt een nuttige werkwijze toe. Stapel tags op één regel, zoals een nerveuze opening, een kuch en dan een fluistering op één woord. Bij lange scripts scant een Auto tag knop de tekst en voegt tags toe op basis van context. Missen tags nog steeds, spreek de zin dan zelf in en gebruik Voice Changer, want "hoe dichter je in je opname bij de gewenste voordracht komt, hoe dichter je bij het resultaat komt" (vertaling van het Engelse citaat).
Instructies in gewone taal elders
Andere tools kiezen een andere route. De text to speech gids van OpenAI gebruikt een instructieveld, met voorbeelden als "Speak in a cheerful and positive tone." Check wel de datum voordat je erop bouwt. De documentatie van OpenAI zegt dat de modellen tts 1, tts 1 hd en gpt 4o mini tts "verouderd zijn en op 6 januari 2027 worden uitgeschakeld" (vertaling uit het Engels). Google zegt dat de Gemini 3.8 tekst naar spraak je eigen regieaanwijzingen laat schrijven en signalen als |mhm| laat toevoegen voor gesprekstextuur. De Octave gids van Hume noemt een punt dat overal geldt: gebruik expressieve invoertekst voor expressievere spraak, en schrijf een woord in hoofdletters voor meer nadruk.
Het script doet meer dan je denkt
Maker Isaac, wiens YouTube video meer dan 735.000 weergaven heeft, brengt menselijk klinkende AI stem terug tot vier dingen: toonwisselingen, pauzes, nadruk en een script dat niet rechtstreeks uit ChatGPT komt. Hij genereert ook een paar zinnen per keer in plaats van het hele script. Het is advies dat bij elke stemtool werkt en niets kost.
Het eerlijke tegenargument: tags zijn niet betrouwbaar
Verwacht niet dat tags elke keer gehoorzamen. Recensent Janine Heinrichs van Unite.AI schreef in september 2026 dat "de grootste zwakte de wisselende naleving van prestatietags was" (vertaling uit het Engels). Isaac merkte dat v3 tags bij zijn eigen kloon "de stem zelf een beetje veranderen", waarna hij met lagere stabiliteit terugging naar v2. Zijn video dateert van voor v4, dus die klacht hoeft niet meer te gelden. Het praktische antwoord: weinig tags, vlak voor de woorden die ze moeten beïnvloeden, en elke opname beluisteren.
Nog een voorzichtigheid bij prestatieclaims. ElevenLabs zegt dat Eleven v4 door Artificial Analysis op nummer één werd gezet en in blindtests door ongeveer 75% van de luisteraars werd verkozen. Dat zijn eigen cijfers van ElevenLabs, en Google maakt voor Gemini 3.8 een eigen nummer één claim op een andere benchmark. Test met je eigen script.
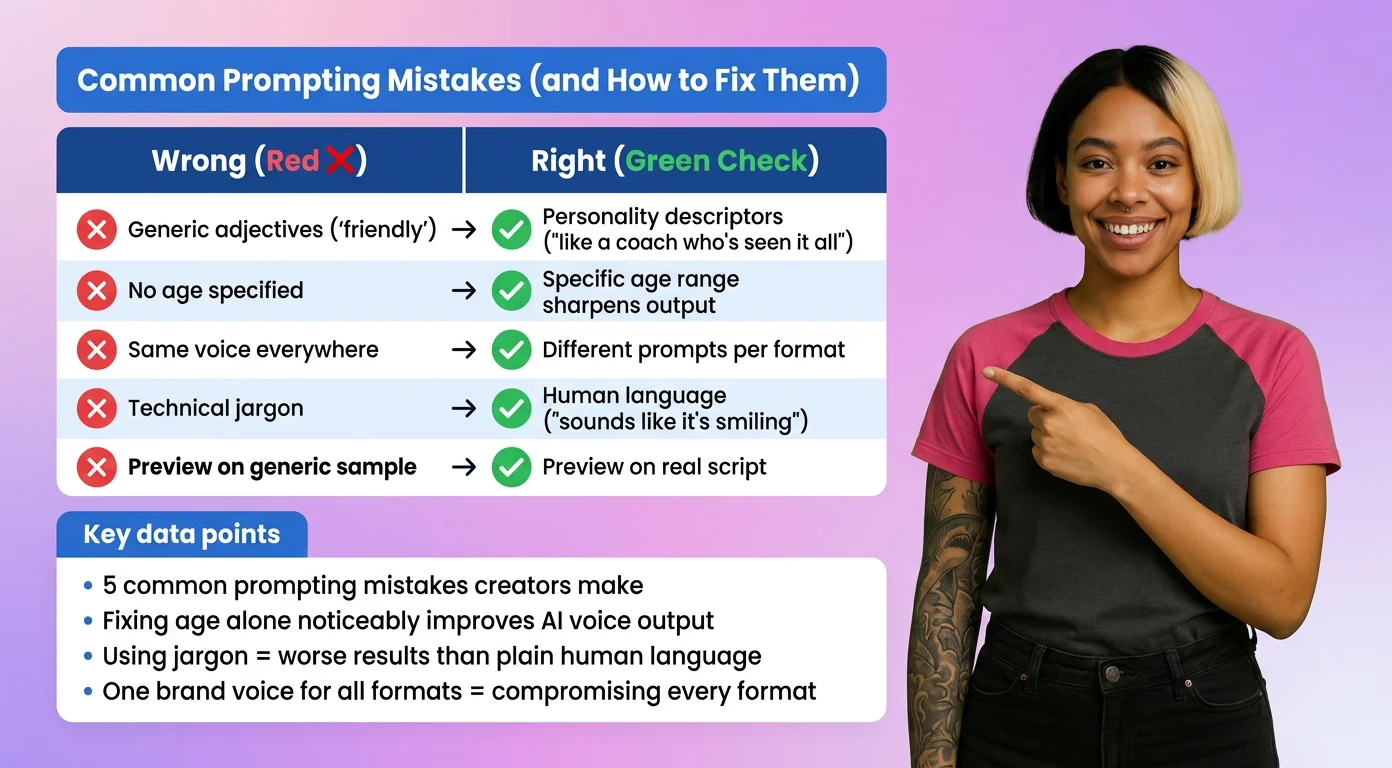
Veelgemaakte promptfouten, en waarom menselijk niet verborgen betekent
De meeste stemmen die missen, falen om dezelfde paar redenen.
Alleen generieke bijvoeglijke naamwoorden gebruiken
"Professioneel", "vriendelijk", "helder". Elke degelijke stem is dat, dus die woorden geven de AI bijna niets. Vervang ze door persoonlijkheid: "als een ervaren coach die alles al heeft gezien maar nog steeds graag helpt".
De leeftijd overslaan
Zonder leeftijdsanker valt de stem terug op het midden, meestal prima en zelden geweldig. Noem de bandbreedte en het resultaat wordt scherper.
Overal dezelfde stem gebruiken
Eén merkstem voor elk formaat dient geen enkel formaat goed. Je verkooppagina, je socialclips en je onboardingvideo's hebben verschillende taken. Geef ze verschillende promptvarianten.
Jargon schrijven in plaats van beschrijven
"Prosodische variatie" en "vocal fry" kunnen kloppen, maar modellen reageren beter op menselijke taal. Beschrijf de luisterervaring. "Klinkt alsof ze lacht" wint van "verhoogde toonhoogte met opwaartse modulatie".
De preview met echt script overslaan
Een stem kan schitteren op een voorbeeldzin en tegenvallen op je echte tekst. Luister naar een regel of twee uit het script dat hij moet inspreken.
Doorgaan voor een mens
Dit is net zo goed ethisch als praktisch. Het gebruiksbeleid van OpenAI "vereist dat je eindgebruikers duidelijk laat weten dat de TTS stem die ze horen AI gegenereerd is" (vertaling uit het Engels). Het Adobe onderzoek uit 2026 onder 850 Amerikaanse consumenten vond dat 88% een stem had gehoord en zich afvroeg of het AI was, terwijl 77% menselijke stemmen nog steeds het meest vertrouwt. Adobe verkoopt AI audiotools, dus lees het als leveranciersstudie. De verstandige lezing van "menselijk klinken" is natuurlijke, warme, goed getimede voordracht, niet verbergen dat een machine praat.
Klonen verhogen de inzet. Een PLOS One studie uit 2025 vond dat luisteraars stemklonen niet betrouwbaar van echte menselijke stemmen konden onderscheiden, maar generieke AI stemmen wel herkenden. De steekproeven waren klein, 50 deelnemers per experiment, maar de les is duidelijk: kan je stem mensen misleiden, zeg het dan.