
写真が話すことを学ぶと実際に何が起こるか
ほとんどのAI トーキング写真ツールは、内部的には同じパイプラインのバージョンを実行しています。 r/generativeAI の内訳では、ユーザーはそれを 2 段階で説明しています。まず、顔の再現モデルが静止画像に自然な動きを与え、次にオーディオ主導のリップシンク モデルが音声トラック内のすべての音に一致するように口の形を再形成します。何度も出てくるオープンソースの名前は、モーションに関しては SadTalker と LivePortrait、口に関しては Wav2Lip で、D-ID と HeyGen は同様のステップを製品にパッケージ化しています。
なぜ口が難しい部分なのか
arXiv の論文で説明されている口パク モデルである MuseTalk の背後にある研究者は、問題をトリレンマとして組み立てています。拡散ベースの方法は見栄えは良いですが、実行コストがかかります。より高速な GAN ベースの手法では、リップシンクの精度や、歯がどろどろになることを学術的に丁寧に表現する「歯の詳細」のいずれかが犠牲になる傾向があります。 MuseTalk は圧縮された潜在空間で動作して速度と詳細の両方を実現し、1 枚の NVIDIA V100 グラフィックス カード上で 256 x 256 ピクセルで 1 秒あたり 30 フレームを報告します。
この解像度の数字は覚えておく価値があります。モデルは口の周りの小さな領域のみを再描画し、それをフルサイズの画像にブレンドし直します。顔が小さかったり、顔をそむけていたり、照明が不十分だったりすると、実際に扱うべきディテールが少なくなり、通常はそこで錯覚が壊れてしまいます。
判断するときにどこを見るべきか
YouTube での並列テストで HeyGen と安価なツールを比較したクリエイターは、有益なチェックリストを提供しました。それは、口角に注意し、文が終わるときに頭が何をするかを観察し、P や B などの硬い子音を聞き取ることです。なぜなら、そこが「通常、安価なリップシンク ツールが完全に機能しない箇所」だからです。
アップロードした写真が結果のほとんどを決定します
どのプラットフォームでも画像にあるものしかアニメーション化できないため、設定よりも入力に注意する必要があります。毎週これらのビデオを作成している人々からのアドバイスはほぼ一致しています。
- カメラに向かってください。 2026 年 2 月の Hedra チュートリアルでは、十分に照明が当てられ、顔がレンズをまっすぐに向いている鮮明な写真を推奨し、横顔やぼやけた写真に対して警告しています。また、Hedra は 300 ピクセル未満の画像を拒否することも指摘しています。
- ニュートラルでスタートします。同じチュートリアルでは、結果が硬く見える場合はニュートラルな表現を提案し、加えて、クリアなオーディオは「リップシンクの精度を向上させる」ため、より良い照明とクリーンなオーディオを提案しています。
- クリップは短くしてください。 「クリップが短いほど、よりリアルに見えます」とチュートリアルには記載されています。長いスクリプトを 1 つの長いテイクではなく、いくつかの短いビデオに分割します。
- 動きを落ち着かせます。 HeyGen のウォークスルーで 1 つの画像からアバターを作成するクリエイターは、デフォルトではキャラクターが過度に表情豊かになる可能性があるため、自然な外観、目に見える歯がほとんどなく、手がないことを求めるカスタム モーション プロンプトを追加しました。
- 可能であれば、複数回ショットしてください。 HeyGen は、モデルがより詳細をキャプチャできるように、自分の写真を追加でアップロードすることを提案しています。
顔と同じくらい声も大事です。平坦で急いでいる音声トラックでは、完璧な口さえも間違っているように見えます。話すための台本を書き、それを一度声に出して読み、何かを生み出す前につまずいた文をカットします。
BIGVU vs HeyGen vs Hedra: それぞれが何をもたらすか
3 つとも写真を話すアバターに変換しますが、異なる購入者向けに構築されています。現在、各ベンダーが独自のページに表示している内容は次のとおりです。
BIGVU AI トーキングフォト
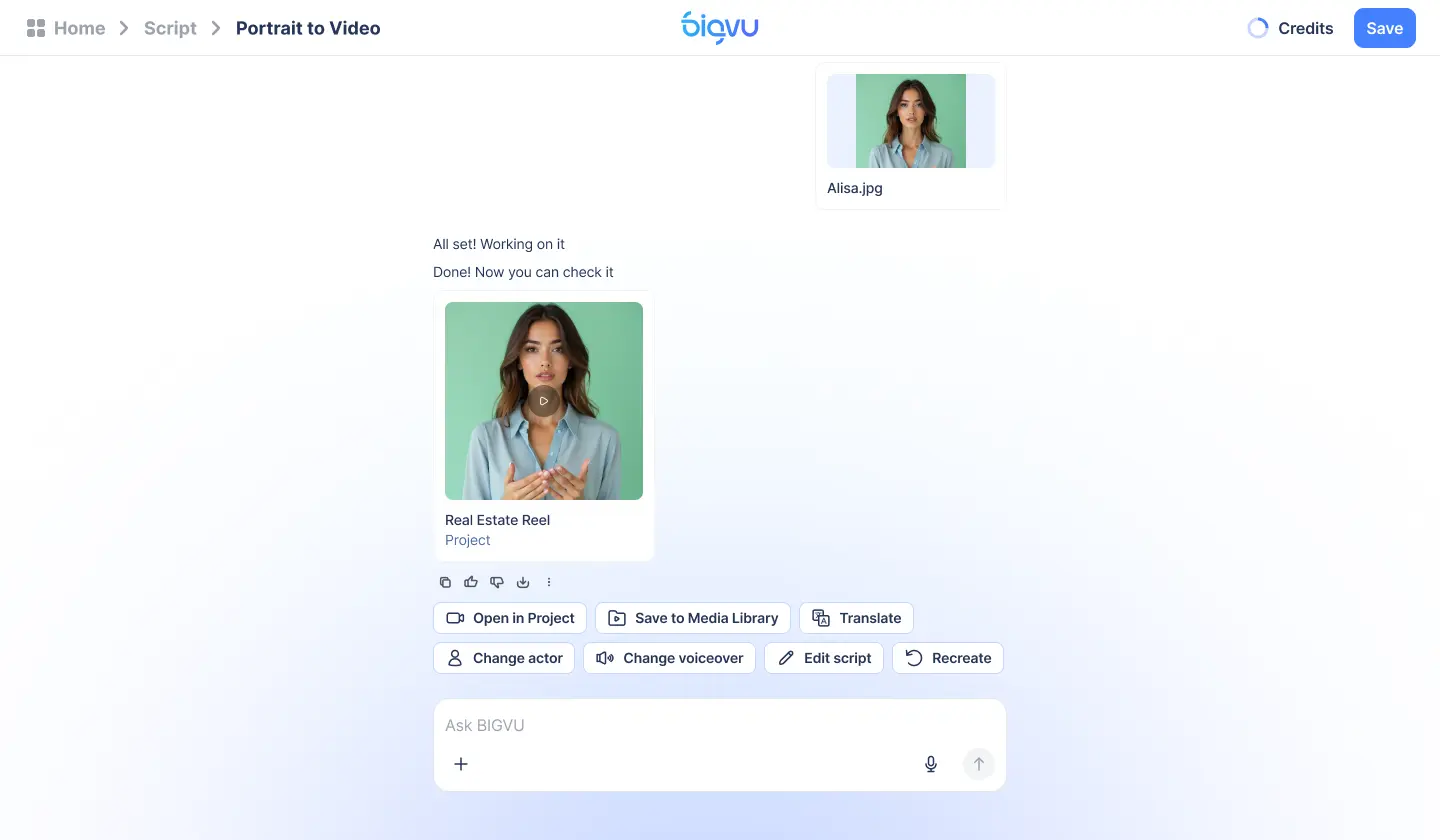
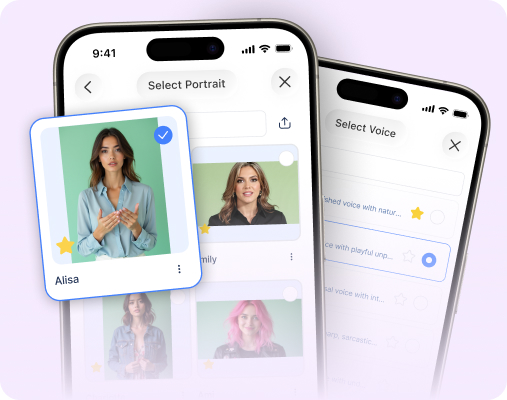
BIGVU の AI Talking Photo は、ポートレートをアップロードし、スクリプトと音声を追加し、生成して公開するという 3 つのステップで機能します。スクリプトを自分で書くか、 AI Script Generatorを使用して下書きし、BIGVU のライブラリから音声を選択するか、独自の音声を複製することができます。リップシンクされたビデオは、キャプション、ブランド キット、公開のために同じアプリ内に留まり、Web、iPhone、または Android から作業できます。 AI 機能は毎月のクレジットを利用し、価格ページではそれをビデオ時間に変換します。無料プランの 500 クレジットは約 10 秒のポートレートビデオをカバーし、AI Pro の 3,000 クレジットは約 1 分をカバーします。
HeyGen フォトアバター
HeyGen の写真アバター ページでは、175 以上の言語と方言で話す写真、服装や背景を変更するテキスト プロンプトとルック パック、および単一の画像を音声同期と手のジェスチャーでビデオに変換するアバター IV エンジンを宣伝しています。価格設定ページ(2026 年 11 月 1 日に確認) では、無料プランではそれぞれ最大 1 分の透かし入り動画を月に 3 本利用でき、クリエイターの料金は月 29 ドルで 600 クレジット、プロの料金は月 49 ドルで 1,000 クレジットと最大 30 分の動画です。 HeyGen によると、キャンセルするとクレジットは失効し、無料アカウントではダウンロードが 720p に制限されていたことに注意してください。
ヘドラ
Hedra の公開価格ページには月額プランが表示されなくなりました。前払いのドル残高から出力ごとに料金がかかります。アバターとリップシンクの生成は 1 秒あたり 2.5 セント、アップスケーリングは 1 秒あたり 2.14 セント、編集は 1 秒あたり 7 セント、再照明は 1 秒あたり 20 セントで、サブスクリプションは必要ありません。
ヘドラで作ったらどうなったのか
私たちは、100 クレジットが付いた Hedra の無料プランから始めました。開始イメージの作成には 7 クレジットが使用され、約 30 分かかりました。会話部分には Hedra Avatar を選択し、7 秒のスクリプトを入力し、デフォルトの音声を 720p に保ちました。 [生成] ボタンには 85 クレジットと表示されました。バランスは 40 低下し、その結果、ウォーターマーク付きの 6 秒の 1280x720 クリップが約 2 分で完成しました。モデル ピッカーは、コストの変動幅も示しました。MiniMax H3 Max は世代あたり 50 ~ 240 クレジットで最高の価値とラベル付けされ、一方、Seedance 2.5 は 84 ~ 3,322 クレジットで最高品質とラベル付けされました。
もう一つ目立ったことがあった。フローには、AI 開示ラベル、同意チェック、または写真に対する権利があるかどうかに関する質問はまったく表示されませんでした。透かしだけが目印でした。これは、開示に対する責任を直接あなたに負わせるものであり、これは以下で説明するルールにとって重要です。
最高のものと価値のあるもの
上記のサイドバイサイドテストの作成者は率直に言いました。HeyGen はリアリズムで勝利し、「それに及ばない」にもかかわらず、より安価なツールを使用しています。なぜなら、彼のアバターは、画面録画が引き継がれるまで 60 ~ 80 秒しかビデオを開かないからです。彼のルールは、これらのAI ビデオ ツールのいずれにも適しています。顔が商品である場合は、最も現実的なオプションにお金を払います。顔についての簡単な紹介であれば、それで十分です。
しゃべる写真が儲かる場所とそうでない場所
話す写真は、顔は必要だが撮影スタッフは不要な繰り返しのメッセージに映えます。 BIGVU では、市場の最新情報、リストの更新情報、近隣のスポットライト、FAQ、プロモーション、社内発表、製品の説明などが典型的な用途として挙げられており、共通するのは繰り返しです。承認されたポートレートを 1 枚取得すると、誰にも時間を予約せずに、月に 5 回目の更新を作成できます。
ぴったりフィット
- 短い紹介と定期的な更新。最初の 1 分はおなじみの顔で、その後はスライド、デモ、またはリスト映像です。
- ビデオメールマーケティング。フォローアップ メールの冒頭にある個人的な挨拶は、プレーン テキストよりも温かみのあるものに感じられます。 BIGVU のビデオメール ツールを使用すると、同じアカウントから送信できます。
- 撮影なしの出品。不動産業者は、トーキング写真イントロとFototaleを組み合わせて、既存の物件写真をパン、ズーム、トランジションを備えたビデオに変えることができます。
弱いフィット感
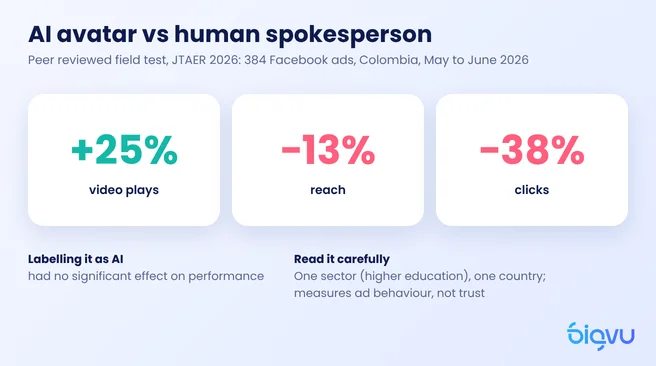
信頼が重要な場合には注意してください。 2026年にJournal of Theoretical and Applied Electronic Commerce Researchに掲載された384のFacebook広告のピアレビューによるフィールドテストでは、AIアバターは人間のスポークスマンよりもビデオ再生数が25%多かったものの、リーチ数は13%、クリック数は38%少なかったことが判明した。この調査ではコロンビアの高等教育広告が対象となっているため、法律ではなく 1 つのデータポイントとして扱ってください。それでも、これは前に引用した YouTube クリエイターのアドバイスと一致しています。クライアントの仕事、ブランドの広報担当者、またはお金を払っている顧客がフレームごとに研究するものについては、購入できる中で最も現実的なツール、または実際の録画を推奨しています。
開示、同意および新しいルール
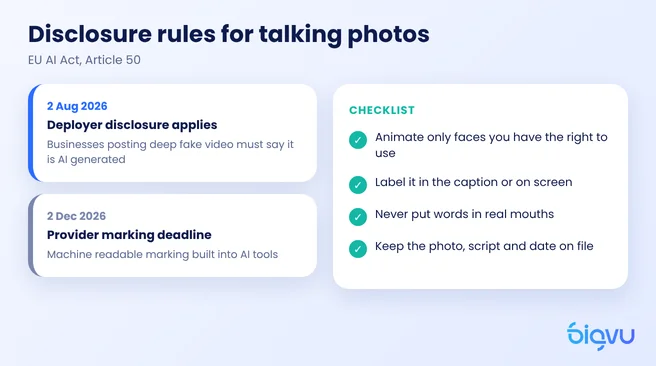
写真を話すことの倫理は、かつては良いマナーの問題でした。欧州連合では現在、これは法的義務でもあります。 EU AI法第50条では、ディープフェイクを構成する動画を生成または操作するAIシステムを導入する者は、「コンテンツが人為的に生成または操作されたものであることを開示するものとする」と定めており、遅くとも視聴者が最初に見た時点ではこのことが明らかでなければならないとしている。 モーガン・ルイス氏が説明したように、これらの透明性義務は2026年8月2日から適用され始めた。12月2日までの別途4か月の移行期間は、プロバイダーが組み込む必要がある機械読み取り可能なマークのみを対象とし、動画を投稿する企業の義務は延期されない。
2026 年 6 月 10 日、欧州委員会は、完全に AI で生成されたコンテンツと部分的に AI が変更されたコンテンツのEU アイコンのセットを含む、AI で生成されたコンテンツのマーキングとラベル付けに関する最終的な実施基準も発表しました。実在の人物のしゃべる写真は、そのレーベルにとって教科書的なケースです。
簡単なチェックリスト
- 使用する権利がある面のみをアニメーション化します。あなた自身、またはあなたに明示的に許可を与えた誰か。同意なしにクライアント、競合他社、有名人になることは決してありません。
- ラベルを付けます。 「このビデオは AI が話す写真を使用しています」などのキャプションまたは画面上の短い行で、基本的な義務はカバーされ、費用はほとんどかかりません。
- 本当の口で言葉を発しないでください。自分の台本を読みながら話している写真もひとつのことです。誰かが決して言っていないことを支持しているかのように見せることは別のことです。
- 記録を残してください。誰かがビデオの作り方を尋ねた場合に備えて、元の写真、スクリプト、日付を保存してください。
ラベルは結果に悪影響を及ぼしますか?証拠はまちまちだ。上記の Facebook 広告調査では、広告が AI で作成されたものであることを視聴者に伝えることは、パフォーマンスに大きな影響を及ぼさないことがわかりました。 Journal of Research in Interactive Marketing に掲載された358 人の消費者を対象とした 2025 年の調査では、逆の結果が判明しました。情報開示により、人々がその広告にどれだけ価値を見出し、購入意欲が低下したのかということです。 EU ではいずれにせよラベルが必要であるというのが私たちの見解です。そのため、より良い問題は、人々が知った後、どのようにしてビデオを視聴する価値のあるものにするかということです。本物の台本、本物のオファー、そして遠くまで進んでいるように聞こえる声。
これらを自分で制作したくない場合は、BIGVU のSuperAgentチームが、専任のストラテジスト、キャプション、サムネイルを使用して、クローン音声で TalkingPhoto を使用して月々 8 本のビデオを月額 299 ドルから作成できます。