
写真が話せるようになるとき、実際に何が起きているのか
内部では、ほとんどのAIトーキングフォトツールが同じ処理の一種を実行しています。r/generativeAIのスレッドでは、ユーザーがこれを2段階で説明しています。まず顔の再現モデルが静止画に自然な動きを与え、次に音声駆動のリップシンクモデルが、音声トラックの一音一音に合わせて口の形を作り直します。オープンソースで最もよく名前が挙がるのは、動きにSadTalkerとLivePortrait、口にWav2Lipで、D-IDやHeyGenは同様の処理を製品としてまとめています。
なぜ口がいちばん難しいのか
arXivの論文で発表されたリップシンクモデルMuseTalkの研究者たちは、この問題を三すくみとして説明しています。拡散モデルの手法は見た目がとても良い一方で、動かすコストが高い。より速いGANの手法は、たいてい唇の同期の精度か「歯のディテール」を犠牲にします。歯がぼやけることを学術的に丁寧に言い換えた表現です。MuseTalkは圧縮された潜在空間で処理することで速度とディテールを両立させ、NVIDIA V100のGPU1枚で256×256ピクセル、毎秒30フレームを達成したと報告しています。
この解像度の数字は覚えておく価値があります。モデルは口の周りの小さな領域だけを描き直し、それをフルサイズの写真に合成し直します。顔が小さい、横を向いている、暗いといった場合は使える本物のディテールが少なくなり、たいていそこで錯覚が崩れます。
評価するときに見るべきところ
YouTubeでの並べ比べテストでHeyGenと安価なツールを比較したクリエイターは、役立つチェックリストを挙げています。口角を見ること、文が終わるときに頭がどう動くかを見ること、そしてPやBのような強い子音を聞くこと。そこは「安いリップシンクツールが完全に破綻しがちな場所」だからです。
アップロードする写真が結果の大半を決める
どのプラットフォームも写真に写っているものしか動かせないので、元の写真には設定以上に気を配る価値があります。こうした動画を毎週作っている人たちのアドバイスはよく似ています。
- カメラの正面を向く。2026年2月のHedraチュートリアルは、顔がレンズにまっすぐ向いた、照明の良い鮮明な写真を勧め、横顔の写真やぼやけた画像は避けるよう説明しています。また、Hedraは300ピクセル未満の画像を受け付けないとも述べています。
- 自然な無表情から始める。同じチュートリアルは、仕上がりが硬く見える場合は無表情に近い写真を使い、照明を改善し、クリアな音声を用意するよう勧めています。クリアな音声は「リップシンクの精度を高める」からです。
- クリップは短くする。「短いクリップのほうがリアルに見えます」とチュートリアルは書いています。長い台本は1本の長いテイクではなく、複数の短い動画に分けましょう。
- 動きを抑える。HeyGenチュートリアルで写真1枚からアバターを作ったクリエイターは、自然な見た目、歯が少し見える程度、手は映さないという専用の動きのプロンプトを追加しました。初期設定のままだとキャラクターが大げさになりやすいためです。
- できれば写真を複数用意する。HeyGenは、モデルがより多くのディテールをとらえられるよう、自分の写真を追加で数枚アップロードすることを勧めています。
声は顔と同じくらい重要です。平板で急いだ音声では、完璧な口元でさえ不自然に見えます。台本は話すために書き、一度声に出して読み、生成する前につっかえた文はすべて削りましょう。
BIGVU、HeyGen、Hedra:それぞれで何ができるか
3つとも写真を話すアバターに変えますが、想定している利用者は異なります。各社が現在自社のページで示している内容は次のとおりです。
BIGVU AI Talking Photo
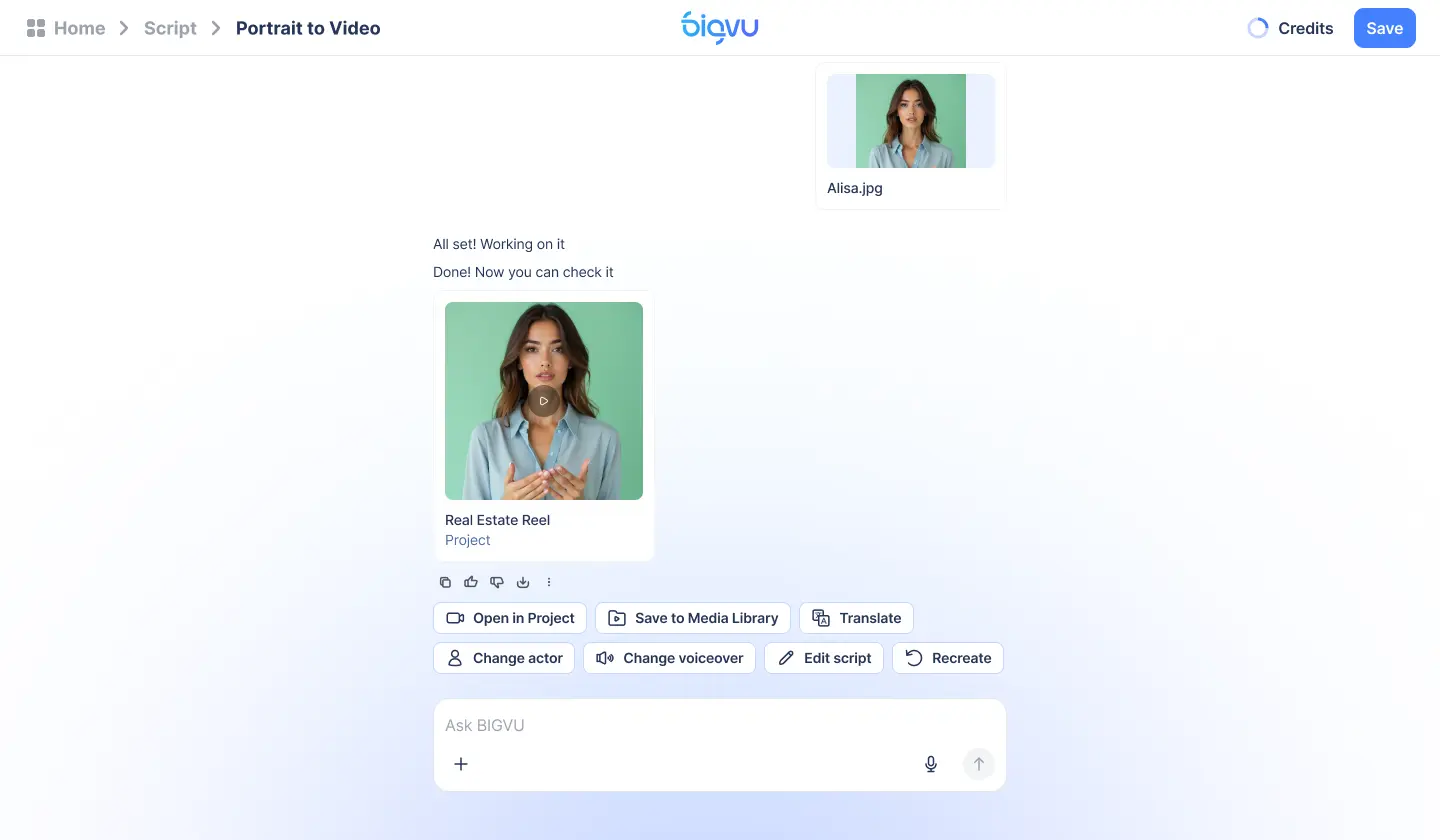
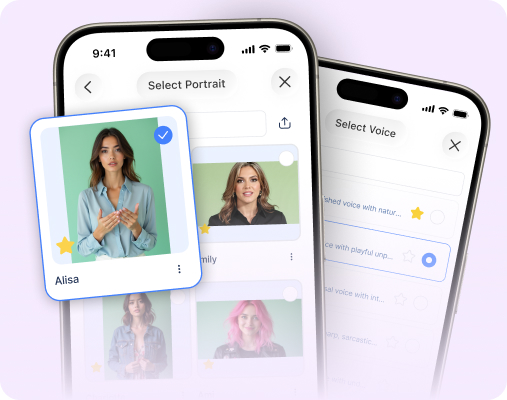
BIGVUのAI Talking Photoは3ステップです。顔写真をアップロードし、台本と音声を加え、動画を生成して公開します。台本は自分で書くことも、AI Script Generatorで下書きすることもでき、声はBIGVUのライブラリから選ぶか、自分の声をクローンできます。完成したリップシンク動画は同じアプリの中で字幕、ブランドキット、公開まで扱え、ウェブ、iPhone、Androidのどれからでも作業できます。AI機能は毎月のクレジットを使い、料金ページではそれを動画の長さに換算しています。無料プランの500クレジットで縦型動画約10秒分、AI Proの3,000クレジットで約1分分です。
HeyGen Photo Avatar
HeyGenのフォトアバターのページは、175以上の言語と方言に対応したトーキングフォト、服装や背景を変えられるテキストプロンプトとスタイルパック、そして写真1枚から音声の同期と手振りのある動画を作るAvatar IVエンジンをうたっています。料金ページによると、無料プランは透かし入りで月3本、1本あたり最長1分、Creatorは月29ドルで600クレジット、Proは月49ドルで1,000クレジット、動画は最長30分です。
Hedra
Hedraの料金は3社の中で最も詳しく公開されています。APIでは、アバター生成とリップシンクが前払いのドル残高から1秒あたり2.5セントからで、サブスクリプションは不要、ボイスクローンは無料です。Studioアプリを使う場合は、月20ドルで2,000クレジットのBasic、50ドルで7,200クレジットのPro、100ドルで18,000クレジットのUltraがあります。
最高か、コストに見合うか
先ほどの並べ比べテストのクリエイターは率直です。リアルさではHeyGenの圧勝で「比べものにならない」。それでも彼が普段よく使うのは安いツールです。アバターは動画の冒頭60秒から80秒だけで、その後は画面録画に切り替わるからです。この考え方はどのAI動画ツールにも当てはまります。顔そのものが商品なら、最もリアルな選択肢にお金を払う。顔が短い導入にすぎないなら、そこそこで十分です。
トーキングフォトが役立つ場面と、そうでない場面
トーキングフォトが力を発揮するのは、顔は必要でも撮影クルーは必要ない、繰り返しのメッセージです。BIGVUは典型的な用途として、市況レポート、物件情報の更新、地域紹介、よくある質問、プロモーション、社内連絡、商品説明を挙げており、共通点は繰り返しです。承認済みの顔写真が1枚あれば、誰の予定も押さえずに今月5本目の更新動画を作れます。
向いている使い方
- 短いイントロと定期的な更新。最初の1分は見慣れた顔、その後はスライド、デモ、物件の映像へ。
- 動画を使ったメールマーケティング。フォローアップメールの冒頭に個人的なあいさつがあると、文字だけより温かく感じられます。BIGVUのビデオメールツールなら同じアカウントから送れます。
- 撮影なしの物件紹介。不動産エージェントは、トーキングフォトのイントロとFototaleを組み合わせられます。Fototaleは既存の物件写真を、パン、ズーム、トランジション付きの動画に変えます。
向いていない使い方
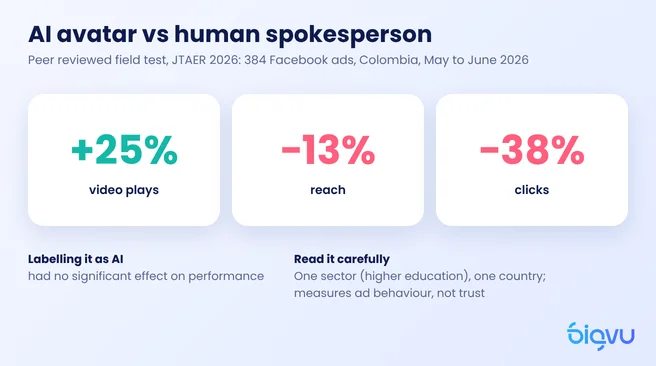
信頼がすべての場面では注意しましょう。Journal of Theoretical and Applied Electronic Commerce Researchに2026年に掲載された、Facebook広告384件を対象とする査読付きの実地実験では、AIアバターは人間の出演者より動画再生数が25%多い一方、リーチは13%少なく、クリック数は38%少ないという結果でした。この研究はコロンビアの高等教育の広告を対象としているので、法則ではなくひとつのデータとして扱ってください。それでも、先に紹介したYouTubeクリエイターの助言と一致します。クライアントの仕事、決まった顔を持つブランド、有料の顧客が1コマずつ見るようなものには、予算内で最もリアルなツールか、本物の撮影を勧めています。
開示、同意、そして新しいルール
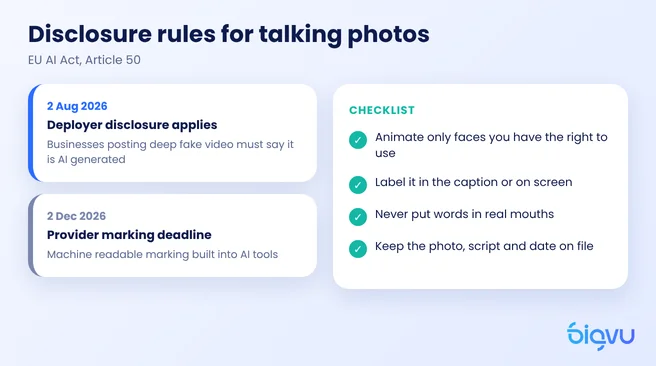
トーキングフォトの倫理は、かつてはマナーの問題でした。EUでは今や法的義務でもあります。EU AI法第50条は、ディープフェイクにあたる動画を生成または加工するAIシステムを利用する者は、そのコンテンツが人工的に生成または加工されたものであることを開示しなければならず、それは遅くとも視聴者が最初に目にした時点で明らかでなければならないと定めています。Morgan Lewisの解説によると、これらの透明性義務は2026年8月2日から適用されています。12月2日までの4か月の別の移行期間は、提供者が組み込む機械可読なマーキングだけが対象で、動画を公開する事業者の義務を先送りするものではありません。
シンプルなチェックリスト
- 使用する権利のある顔だけを動かす。自分の顔か、はっきり許可をくれた人の顔だけにしましょう。顧客、競合他社、有名人の顔を同意なしに使うのは絶対にやめましょう。
- ラベルをつける。「この動画はAIトーキングフォトを使用しています」のような短い一文をキャプションか画面に入れるだけで基本的な義務を満たせ、コストもほとんどかかりません。
- 実在の人に言葉を言わせない。自分のトーキングフォトに自分の台本を読ませるのは問題ありません。誰かが言ってもいないことを支持しているように見せるのは、まったく別の話です。
- 記録を残す。動画がどう作られたかを聞かれたときのために、元の写真、台本、日付を保存しておきましょう。
ラベルが成果を下げるのではと心配なら、同じFacebook広告の研究が安心材料になります。広告がAIで作られたと視聴者に伝えても、成果に有意な影響はありませんでした。ここでは、正直さにコストはかかりません。