ブランドではなく、聞き手から始める
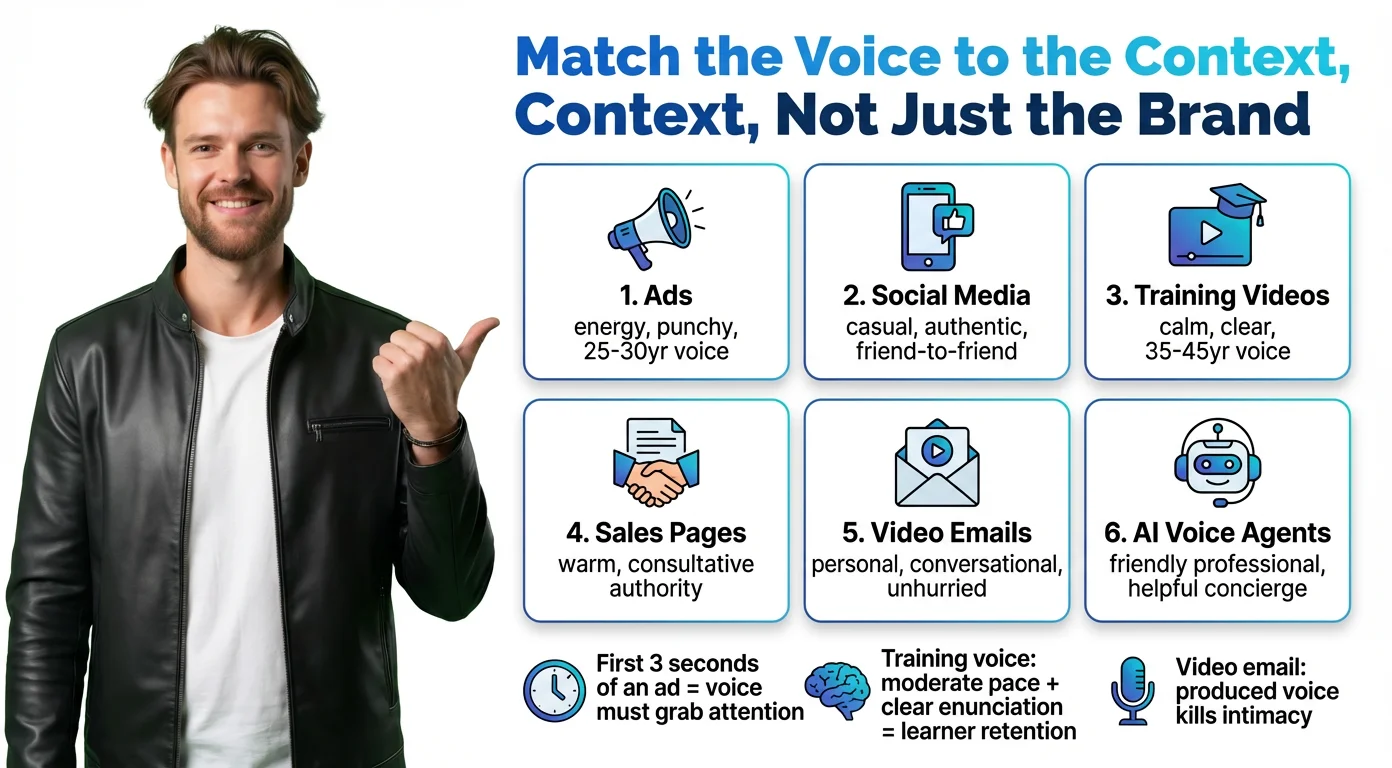
最初の失敗は、音声をブランドカラーのように扱うことです。ひとつ選んで、どこでも使う。販売ページで信頼を生む声が、SNSのクリップでは堅く聞こえることがあります。息つく間もない広告向けの声は、10分の研修素材では疲れさせます。
用途ごとに、私ならこのように声を変えます。
広告とプロモーションのコンテンツ
注意を引ける時間は約3秒なので、声にはエネルギーと前へ進む勢いが必要です。20代半ばから30代前半のペルソナは消費者向け商品に合います。より深く落ち着いたトーンはB2Bやプレミアムブランドに合います。軽快なテンポと歯切れの良い話し方を指定しましょう。
SNS動画
SNSでは、本物の人が友だちに話しているような感覚が評価されます。くだけていて、率直で、少し興奮している。作り込まれた響きはすべて魔法を壊します。会話調で親しみやすく、自然なテンポを指定しましょう。
研修・解説動画
長く見られるため、個性より明瞭さが大切です。落ち着いて抑制がありつつ、単調にならないこと。30代半ばから40代半ばのペルソナは、距離を感じさせずに権威を添えます。明瞭な発音、中程度のテンポ、温かく教える口調を指定しましょう。
販売ページとランディングページ
ここでの役目は信頼づくりです。声は、知識豊富なアドバイザーのように、自信があって温かく、押しつけがましくなく聞こえるべきです。演技のように感じるものは避けましょう。相談に乗る口調、なめらかな音色、会話の中の説得力を指定しましょう。
ビデオメール
ビデオメールの要点は、個人的に感じられることです。作り込みすぎた声は、その印象を一文で壊してしまいます。一対一で話すような、温かく、急がず、自然な間のある会話を目指しましょう。
AI音声エージェント(ウェブサイトと動画ランディングページ)
この声は、訪問者が最初に耳にするブランドとの接点になることがよくあります。親しみやすく役に立つこと。コールセンターの台本よりも、詳しい同僚に近い感じが理想です。
年齢はこれらすべてをつなぎます。22歳の声がコンプライアンス研修を読むと違和感があり、55歳の声がTikTok広告に出るとちぐはぐに感じられます。音声設計で最も活用されていない手がかりのひとつです。
「人間らしさ」は購入者にとって本当に重要でしょうか。ある事業者の調査では、差は小さいことがうかがえます。英国の音声広告会社Azerionは、2026年3月と4月に3,000人のリスナーで広告をテストしました。AI版を聞いた人のうち、人工音声だと正しく答えたのは29%だけで、78%がAI音声は自然だと答え、人間の声は75%でした。これは身近な2ブランドに関する事業者の結果であり、普遍的な法則ではありません。それでも、聞き手がまず話し方を判断していることは分かります。

本当に機能する音声プロンプトの構造
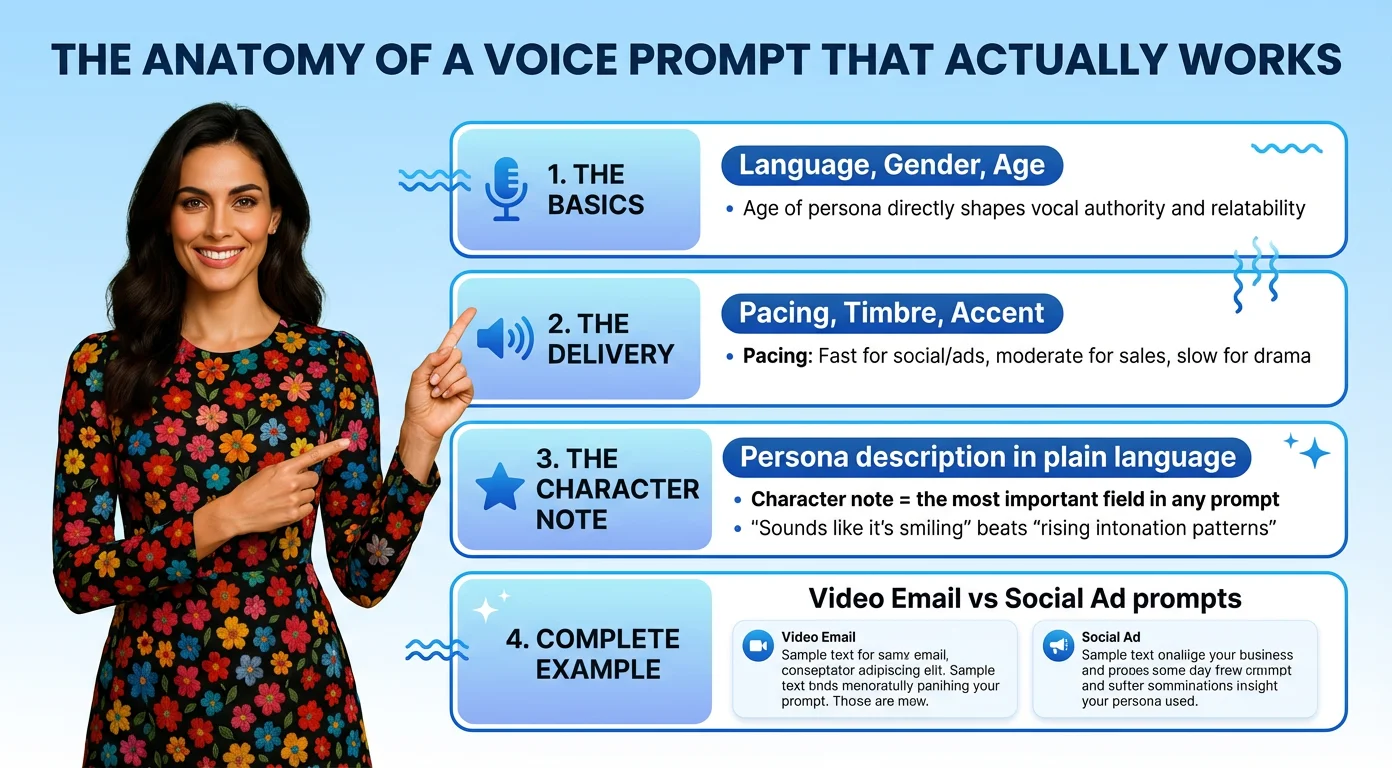
音声プロンプトは形容詞のリストではありません。読んだ別々の二人が同じ話し手を思い浮かべられるほど具体的な、キャラクターの説明です。
強いプロンプトには三つの層があります。
基本:言語、性別、年齢
これが外側の枠を決めます。「女性、30代前半、アメリカ英語」は「女性」よりはるかに有効です。年齢は声質、エネルギー、権威感を左右するので、曖昧にしないでください。
話し方:テンポ、音色、アクセント
テンポはエネルギーを左右します。SNSや広告は速く、販売や研修は中程度、ドラマ性のある内容は遅めです。音色は声の質感で、温かい、明るい、深い、ハスキー、なめらかなどがあります。アクセントは個性とローカライズを加え、聞き手にとって自然に聞こえるか、少し違和感があるかを分けることもあります。
キャラクターノート:最も重要な項目
ここで声は一般的なものから具体的なものに変わります。音響ではなく人を描写してください。「あなたに話しながら微笑んでいるように聞こえる」は、「上昇イントネーションと前方への近接感」より良い結果を生みます。
うまく機能しやすいキャラクターノート:
- ラジオスター:明るく、高エネルギーで、洗練されている。広告やプロモ向け。
- シネマティックなナレーター:深く、慎重で、ドラマチック。ブランドストーリー向け。
- ポッドキャストのホスト:くだけていて、温かく、好奇心がある。解説やソートリーダーシップ向け。
- 親しみやすいコーチ:明確で、励まし、忍耐強い。研修やオンボーディング向け。
- 深夜のDJ:なめらかで低く、親密。高級感や雰囲気のあるコンテンツ向け。
- ニュースキャスター:歯切れよく、中立で、権威がある。レポートや更新情報向け。
完成した例を二つ
ビデオメール向け:「温かく親しみやすい女性の声、30代前半、アメリカ英語、中程度のテンポ。会話調で近づきやすく、コーヒーを片手に同僚が役立つ助言を分けてくれるように。話し方にほのかな笑み。プロフェッショナルだが、決して堅苦しくない。」
SNS広告向け:「エネルギッシュな男性の声、20代半ば、中立的なアメリカ訛り、速いテンポ。素晴らしいものを見つけたばかりで、早く伝えたくてたまらない人のように、自信にあふれて興奮している。明るい音色、歯切れの良い話し方。」
これらのプロンプトが弱いプロンプトと違うのは、長さではありません。パラメータだけでなく、人柄を描いていることです。
BIGVUがプロンプトを2分以内にブランド音声へ変える仕組み
プロンプトを書くことは戦略的な仕事です。音声を生成することはスムーズであるべきで、BIGVUのVoice Designツールはそのために作られています。
ワークフローはBrand Kitの中、Branded Mediaの下にあります。四つのステップで進みます。
ステップ1:パラメータを設定する
Voice Designの画面で、言語、アクセント、性別、テンポ、年齢、音色を選びます。これらは技術的な入力で、AIが動く枠組みです。
ステップ2:キャラクターノートを書く
重要なのはこのプロンプト欄です。BIGVUは「追加ノート」と呼んでいますが、キャスティングの依頼書として扱ってください。「ラジオスターのエネルギー」「映画のようにじわじわ熱を帯びる」「朝の番組の司会者のように温かく楽しい」。仕様ではなくキャラクターを書きましょう。
ステップ3:三つのバリエーションを生成して選ぶ
BIGVUはプロンプトを三通りに解釈して生成します。サンプル台本でそれぞれを試聴し、印象を比べて一つを選びます。何が生成されたかを平易な言葉で説明した文章も表示されるので、何を残すのか分かります。
ステップ4:名前を付けて保存する
音声に名前を付け(BIGVUは言語と文化的背景に基づいて提案できます)、説明を確認して保存します。音声はそのままContent Bankに追加され、AIが生成した人物画像(顔、上半身、全身)も動画制作用に添えられます。
全体で2分もかかりません。キャスティングも、スタジオも、声優も不要です。音声はあなたのもので、保存され、すべての動画で再利用できます。
同じワークフローがあらゆる言語で使えます。ブラジル向けの温かいポルトガル語、東京向けのプロらしい日本語、中南米のSNS向けの速いスペイン語。言語、アクセント、文化的なノートを変えるだけで、出力が合わせて変わります。

読みを演出する:オーディオタグ、間、そして台本そのもの
良い声は仕事の半分です。残りの半分は台詞をどう届けるかで、ここではツールごとの違いが、宣伝が認めるより大きくなります。
ElevenLabs v4のオーディオタグ
ElevenLabsは、Eleven v4とEleven v3がオーディオタグに対応していると述べています。話し方を変えたい位置に置く、角かっこで囲んだ短い指示です。ヘルプセンターには[curious]、[whispers]、[laughs]、[clears throat]といった例が載っています。ドキュメントから実用的な点をひとつ。Eleven v4とv3はSSMLの休止タグに対応していないため、間は[pause]や[long pause]のようなタグ、または句読点で作ります。ElevenLabs自身の例では、同じ短い一行が[pause]タグなしで4秒、ありで6秒でした。
ElevenLabs公式チャンネルのチュートリアルは、役立つ進め方を加えています。一行にタグを重ねます。たとえば緊張した出だし、咳払い、そして一語だけのささやきです。長い台本では、Auto tagボタンがテキストを走査して文脈に合わせてタグを追加します。それでもタグが外れるなら、自分でその台詞を録音してVoice Changerを使いましょう。「録音で求める話し方に近づくほど、出力も近づく」からです(英語の引用の翻訳)。
他のツールの平易な言葉による指示
他のツールは別の道を取ります。OpenAIのテキスト読み上げガイドは指示欄を使い、「Speak in a cheerful and positive tone.」のような例を挙げています。ただし、頼る前に日付を確認してください。OpenAIのドキュメントには、tts 1、tts 1 hd、gpt 4o mini ttsのモデルは「非推奨であり、2027年1月6日に終了する」とあります(英語からの翻訳)。Googleは、Gemini 3.8のテキスト読み上げでは自分でト書きのような演出指示を書き、|mhm|のような合図で会話らしい質感を加えられると述べています。HumeのOctaveガイドは、どこでも通じる原則を示しています。表現豊かな入力テキストを使うとより表現豊かな音声になり、単語を大文字にすると強い強調になります。
台本は思う以上に大きい
YouTube動画が73万5000回以上再生されているクリエイターのIsaacは、人間らしいAI音声を四つに絞ります。トーンの変化、間、強調、そしてChatGPTからそのまま出てきたものではない台本です。彼は台本全体ではなく、数文ずつ生成します。どの音声ツールでも通用し、費用もかからない助言です。
正直な反論:タグは当てにならない
タグが毎回従うとは期待しないでください。Unite.AIのレビュー担当Janine Heinrichsは、2026年9月に「最大の弱点は、パフォーマンスタグへの追従が一貫していないことだった」と書きました(英語からの翻訳)。Isaacは、自分のクローンにv3のタグを加えると「声そのものが少し変わる」ことに気づき、安定性を下げたv2に戻りました。彼の動画はv4より前なので、その不満は今は当てはまらないかもしれません。実践的な答えは、タグを少なくし、影響させたい言葉の直前に置き、毎回聞くことです。
性能に関する主張にも、もうひとつ注意があります。ElevenLabsは、Eleven v4がArtificial Analysisで1位にランク付けされ、ブラインドテストでリスナーの約75%に好まれたと述べています。これはElevenLabs自身の数字で、Googleも別のベンチマークでGemini 3.8の1位を主張しています。自分の台本で試してください。
よくあるプロンプトの失敗と、人間らしさは隠すことではない理由
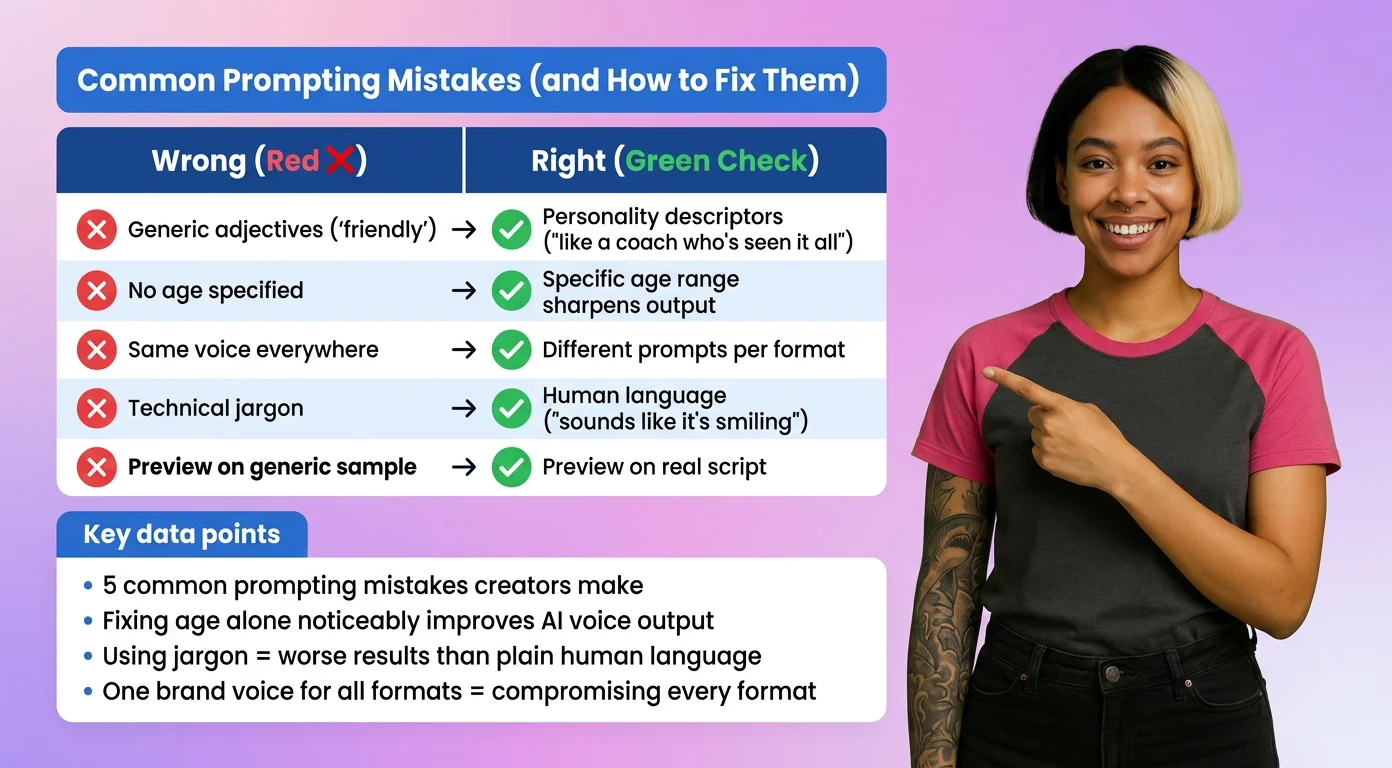
外れてしまう音声の多くは、同じ数個の理由で失敗します。
一般的な形容詞だけを使う
「プロフェッショナル」「親しみやすい」「明瞭」。まともな声ならどれもそうなので、これらの言葉はAIにほとんど何も与えません。人柄に置き換えましょう。「あらゆる経験をしてきたのに、助けることにまだワクワクしているベテランコーチのように」。
年齢を飛ばす
年齢の基準がないと、声は中間に落ち着きます。たいてい悪くはなく、めったに素晴らしくはありません。範囲を示せば、出力が鮮明になります。
どこでも同じ声を使う
すべての形式にひとつのブランド音声では、どれもうまく果たせません。販売ページ、SNSクリップ、オンボーディング動画は役割が違います。それぞれ異なるプロンプトのバリエーションを与えましょう。
描写の代わりに専門用語を書く
「韻律の変動」や「ボーカルフライ」は正確かもしれませんが、モデルは人の言葉により良く反応します。聞く体験を描写してください。「微笑んでいるように聞こえる」は「高めの音程と上昇する変調」に勝ります。
実際の台本でプレビューしない
声はサンプル文では輝いても、実際の原稿では力を失うことがあります。読み上げる台本から一、二行で試聴してください。
人間のふりをしようとする
これは実務であると同時に倫理の問題です。OpenAIの利用ポリシーは「聞いているTTS音声がAIによって生成されたものであることを、エンドユーザーに明確に開示するよう求めている」とあります(英語からの翻訳)。2026年のAdobeの米国消費者850人への調査では、88%が声を聞いてAIかどうか疑問に思ったことがあり、77%は今でも人間の声を最も信頼していました。AdobeはAIの音声ツールを販売しているので、事業者による調査として読んでください。「人間らしく聞こえる」の妥当な解釈は、自然で温かく、テンポの良い話し方であり、機械が話していることを隠すことではありません。
クローンは賭け金を引き上げます。2025年のPLOS One研究では、リスナーは音声クローンと本物の人間の声を確実には区別できませんでしたが、一般的なAI音声は見分けられました。サンプルは実験ごとに50人と小さいものの、教訓は明確です。あなたの声が人をだませるなら、そのことを伝えましょう。