
Apa yang sebenarnya terjadi saat sebuah foto belajar berbicara
Di balik layar, sebagian besar alat foto berbicara AI menjalankan versi dari proses yang sama. Dalam sebuah diskusi di r/generativeAI, pengguna menjelaskannya dalam dua tahap: pertama, model reka ulang wajah memberi gerakan alami pada foto diam, lalu model sinkronisasi bibir yang digerakkan audio membentuk ulang mulut agar cocok dengan setiap bunyi di trek suara. Nama sumber terbuka yang paling sering muncul adalah SadTalker dan LivePortrait untuk gerakan serta Wav2Lip untuk mulut, sementara D-ID dan HeyGen mengemas langkah serupa menjadi produk.
Mengapa mulut adalah bagian tersulit
Para peneliti di balik MuseTalk, model sinkronisasi bibir yang dijelaskan dalam sebuah makalah di arXiv, menggambarkan masalah ini sebagai trilema. Metode berbasis difusi terlihat sangat bagus tetapi mahal untuk dijalankan. Metode GAN yang lebih cepat biasanya mengorbankan akurasi gerak bibir atau "detail gigi", cara akademis yang sopan untuk mengatakan bahwa gigi menjadi buram. MuseTalk bekerja di ruang laten yang terkompresi untuk mendapatkan kecepatan sekaligus detail, dan melaporkan 30 bingkai per detik pada resolusi 256 kali 256 piksel di satu kartu grafis NVIDIA V100.
Angka resolusi itu patut diingat. Model hanya menggambar ulang area kecil di sekitar mulut, lalu memadukannya kembali ke foto Anda dalam ukuran penuh. Saat wajah terlihat kecil, menoleh, atau kurang cahaya, detail asli yang bisa diolah lebih sedikit, dan di situlah ilusinya biasanya runtuh.
Bagian yang perlu diperhatikan saat menilai
Seorang kreator yang membandingkan HeyGen dengan alat yang lebih murah dalam uji perbandingan langsung di YouTube memberi daftar yang berguna: perhatikan sudut mulut, lihat apa yang dilakukan kepala saat kalimat berakhir, dan dengarkan konsonan keras seperti P dan B, karena di situlah "alat sinkronisasi bibir yang lebih murah biasanya ambruk total".
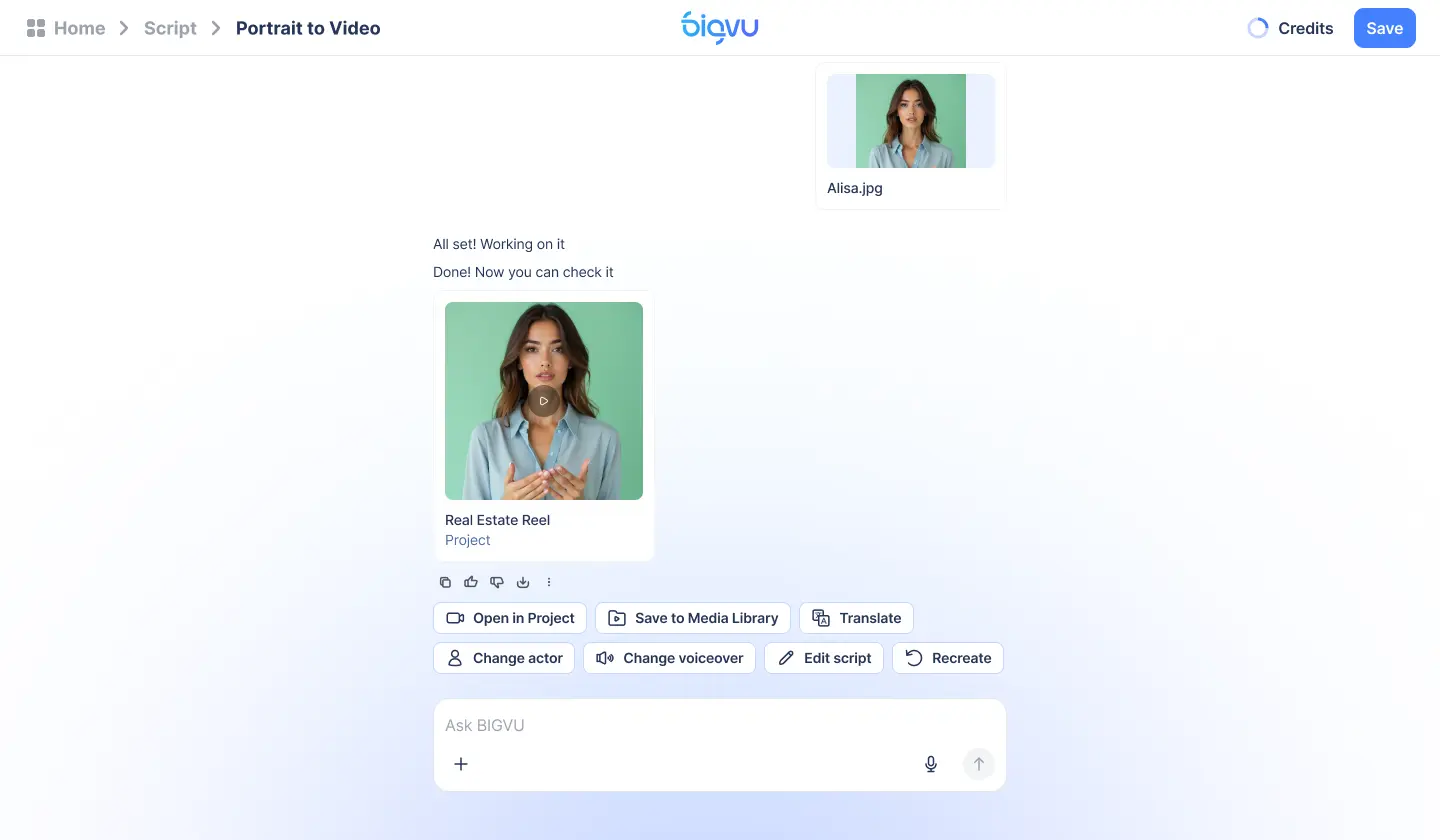
Foto yang Anda unggah menentukan sebagian besar hasil
Setiap platform hanya bisa menganimasikan apa yang ada di foto, jadi foto awal layak mendapat perhatian lebih dari pengaturan. Saran dari orang yang membuat video seperti ini setiap minggu sangat mirip.
- Hadap ke kamera. Sebuah tutorial Hedra dari Februari 2026 menyarankan foto yang tajam, dengan wajah menghadap lurus ke lensa dan pencahayaan yang baik, serta melarang foto dari samping dan gambar buram. Tutorial itu juga menyebut bahwa Hedra menolak gambar yang lebih kecil dari 300 piksel.
- Mulai dengan ekspresi netral. Tutorial yang sama menyarankan ekspresi netral jika hasilnya terlihat kaku, ditambah pencahayaan yang lebih baik dan audio yang bersih, karena audio yang jernih "meningkatkan akurasi sinkronisasi bibir".
- Buat klip pendek. "Klip yang lebih pendek terlihat lebih realistis," tulis tutorial itu. Pecah naskah panjang menjadi beberapa video pendek, bukan satu pengambilan panjang.
- Redam gerakannya. Seorang kreator yang membuat avatar dari satu foto dalam tutorial HeyGen miliknya menambahkan prompt gerakan khusus yang meminta tampilan alami, sedikit gigi terlihat, dan tanpa tangan, karena pengaturan bawaan bisa membuat karakter terlalu ekspresif.
- Berikan lebih dari satu foto jika bisa. HeyGen menyarankan mengunggah beberapa foto tambahan diri Anda agar modelnya menangkap lebih banyak detail.
Suara sama pentingnya dengan wajah. Trek suara yang datar dan terburu membuat mulut yang sempurna pun terlihat salah. Tulis naskah untuk diucapkan, baca sekali dengan suara keras, dan hapus setiap kalimat yang membuat Anda tersandung sebelum menghasilkan apa pun.
BIGVU, HeyGen, dan Hedra: apa yang ditawarkan tiap platform
Ketiganya mengubah foto menjadi avatar berbicara, tetapi dibuat untuk pembeli yang berbeda. Inilah yang ditampilkan setiap vendor di halaman mereka saat ini.
BIGVU AI Talking Photo
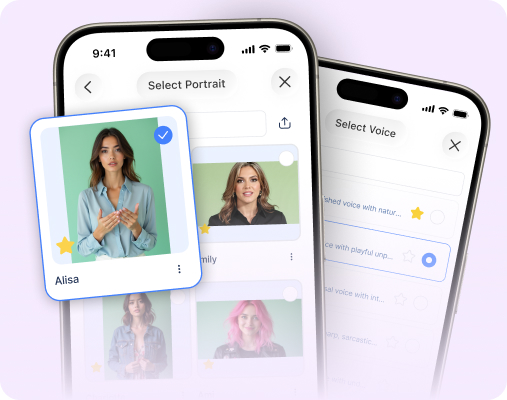
AI Talking Photo dari BIGVU bekerja dalam tiga langkah: unggah foto wajah, tambahkan naskah dan suara, lalu buat videonya dan terbitkan. Anda bisa menulis naskah sendiri atau menyusunnya dengan AI Script Generator, lalu memilih suara dari pustaka BIGVU atau mengkloning suara Anda sendiri. Video dengan sinkronisasi bibir itu tetap berada di aplikasi yang sama untuk teks, brand kit Anda, dan penerbitan, dan Anda bisa bekerja dari web, iPhone, atau Android. Fitur AI memakai kredit bulanan, dan halaman harga menerjemahkannya ke durasi video: 500 kredit di paket gratis cukup untuk video potret sekitar 10 detik, sedangkan 3.000 kredit di AI Pro cukup untuk sekitar satu menit.
HeyGen Photo Avatar
Halaman avatar foto HeyGen mengiklankan foto berbicara dalam lebih dari 175 bahasa dan dialek, prompt teks dan paket tampilan yang mengubah pakaian atau latar Anda, serta mesin Avatar IV yang mengubah satu foto menjadi video dengan sinkronisasi suara dan gerakan tangan. Di halaman harganya, paket gratis memberi 3 video per bulan dengan tanda air dan durasi hingga 1 menit per video, Creator seharga 29 dolar per bulan dengan 600 kredit, dan Pro seharga 49 dolar per bulan dengan 1.000 kredit serta video hingga 30 menit.
Hedra
Harga Hedra adalah yang paling rinci di antara ketiganya. Lewat API, pembuatan avatar dan sinkronisasi bibir dimulai dari 2,5 sen per detik dari saldo dolar prabayar, tanpa langganan, dan kloning suara gratis. Jika Anda lebih suka aplikasi Studio, paketnya mulai dari Basic seharga 20 dolar per bulan untuk 2.000 kredit, Pro seharga 50 dolar untuk 7.200 kredit, hingga Ultra seharga 100 dolar untuk 18.000 kredit.
Terbaik atau paling sepadan
Kreator di balik uji perbandingan tadi berterus terang: HeyGen menang soal realisme, "bahkan tidak mendekati", tetapi ia justru lebih sering memakai alat yang murah, karena avatarnya hanya membuka video selama 60 sampai 80 detik sebelum rekaman layar mengambil alih. Aturannya berlaku untuk semua alat video AI ini. Jika wajah adalah produknya, bayar opsi yang paling realistis. Jika wajah hanya pembuka singkat, cukup bagus sudah cukup.
Kapan foto berbicara bermanfaat, dan kapan tidak
Foto berbicara unggul untuk pesan berulang yang butuh wajah tetapi tidak butuh kru syuting. BIGVU menyebut kabar pasar, pembaruan listing properti, sorotan lingkungan, FAQ, promo, pengumuman internal, dan penjelasan produk sebagai penggunaan umum, dan benang merahnya adalah pengulangan. Dengan satu foto wajah yang sudah disetujui, Anda bisa membuat pembaruan kelima bulan ini tanpa memesan waktu siapa pun.
Penggunaan yang cocok
- Pembuka singkat dan pembaruan rutin. Wajah yang dikenal di menit pertama, lalu slide, demo, atau rekaman properti.
- Pemasaran email dengan video. Sapaan pribadi di awal email tindak lanjut terasa lebih hangat daripada teks saja. Alat video email BIGVU memungkinkan Anda mengirimnya dari akun yang sama.
- Listing tanpa sesi syuting. Agen properti bisa memadukan pembuka foto berbicara dengan Fototale, yang mengubah foto listing yang sudah ada menjadi video dengan gerakan geser, zoom, dan transisi.
Penggunaan yang lemah
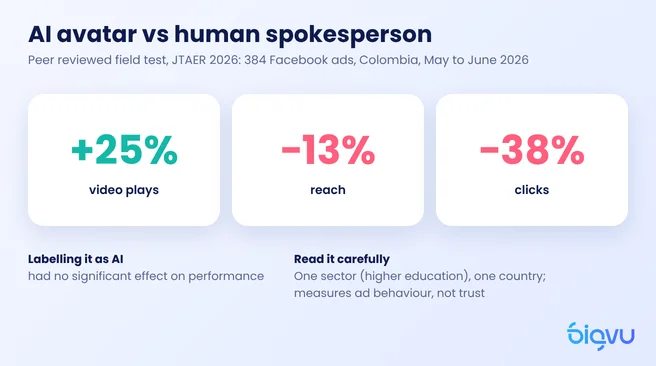
Waspadalah di tempat kepercayaan adalah segalanya. Sebuah uji lapangan yang ditinjau sejawat terhadap 384 iklan Facebook, yang terbit pada 2026 di Journal of Theoretical and Applied Electronic Commerce Research, menemukan bahwa avatar AI mendapat 25% lebih banyak pemutaran video dibanding juru bicara manusia, tetapi jangkauannya 13% lebih kecil dan kliknya 38% lebih sedikit. Studi ini meneliti iklan pendidikan tinggi di Kolombia, jadi anggap sebagai satu data, bukan hukum. Meski begitu, hasilnya sejalan dengan saran kreator YouTube yang dikutip tadi: untuk pekerjaan klien, merek dengan wajah tetap, atau apa pun yang akan diteliti pelanggan berbayar bingkai demi bingkai, ia menyarankan alat paling realistis yang mampu Anda beli, atau rekaman asli.
Pengungkapan, persetujuan, dan aturan baru
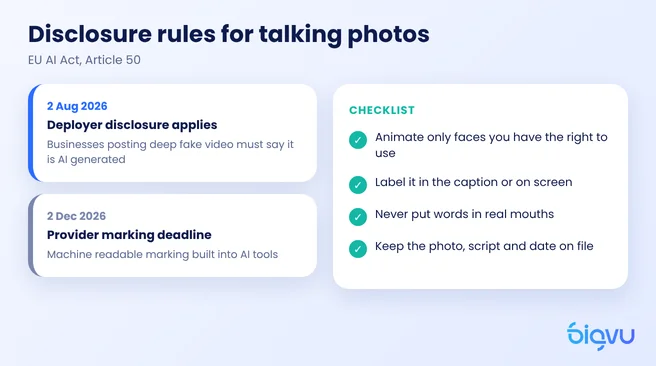
Etika foto berbicara dulu hanya soal sopan santun. Di Uni Eropa, kini itu juga kewajiban hukum. Pasal 50 Regulasi AI Uni Eropa menyatakan bahwa siapa pun yang menggunakan sistem AI yang menghasilkan atau memanipulasi video berupa deepfake wajib mengungkapkan bahwa konten tersebut dibuat atau dimanipulasi secara artifisial, dan hal itu harus jelas paling lambat saat penonton pertama kali melihatnya. Seperti dijelaskan Morgan Lewis, kewajiban transparansi itu mulai berlaku pada 2 Agustus 2026. Masa transisi terpisah selama empat bulan, hingga 2 Desember, hanya mencakup penandaan yang dapat dibaca mesin yang harus dibangun oleh penyedia, dan tidak menunda kewajiban bisnis yang menerbitkan video.
Daftar periksa sederhana
- Animasikan hanya wajah yang boleh Anda gunakan. Wajah Anda sendiri, atau milik orang yang sudah memberi izin tegas. Jangan pernah wajah klien, pesaing, atau selebritas tanpa persetujuan.
- Beri label. Satu baris singkat di keterangan atau di layar, seperti "Video ini menggunakan foto berbicara AI", memenuhi kewajiban dasar dan hampir tidak memakan biaya.
- Jangan menaruh kata di mulut orang sungguhan. Foto berbicara diri Anda yang membacakan naskah Anda sendiri adalah satu hal. Membuat seseorang tampak mendukung sesuatu yang tidak pernah ia katakan adalah hal lain.
- Simpan catatan. Simpan foto asli, naskah, dan tanggalnya, kalau ada yang bertanya bagaimana sebuah video dibuat.
Jika Anda khawatir label akan merusak hasil, studi iklan Facebook yang sama menenangkan: memberi tahu penonton bahwa iklan dibuat dengan AI tidak berpengaruh signifikan terhadap kinerja. Dalam hal ini, kejujuran gratis.