Mulailah dari Pendengar, Bukan dari Merek
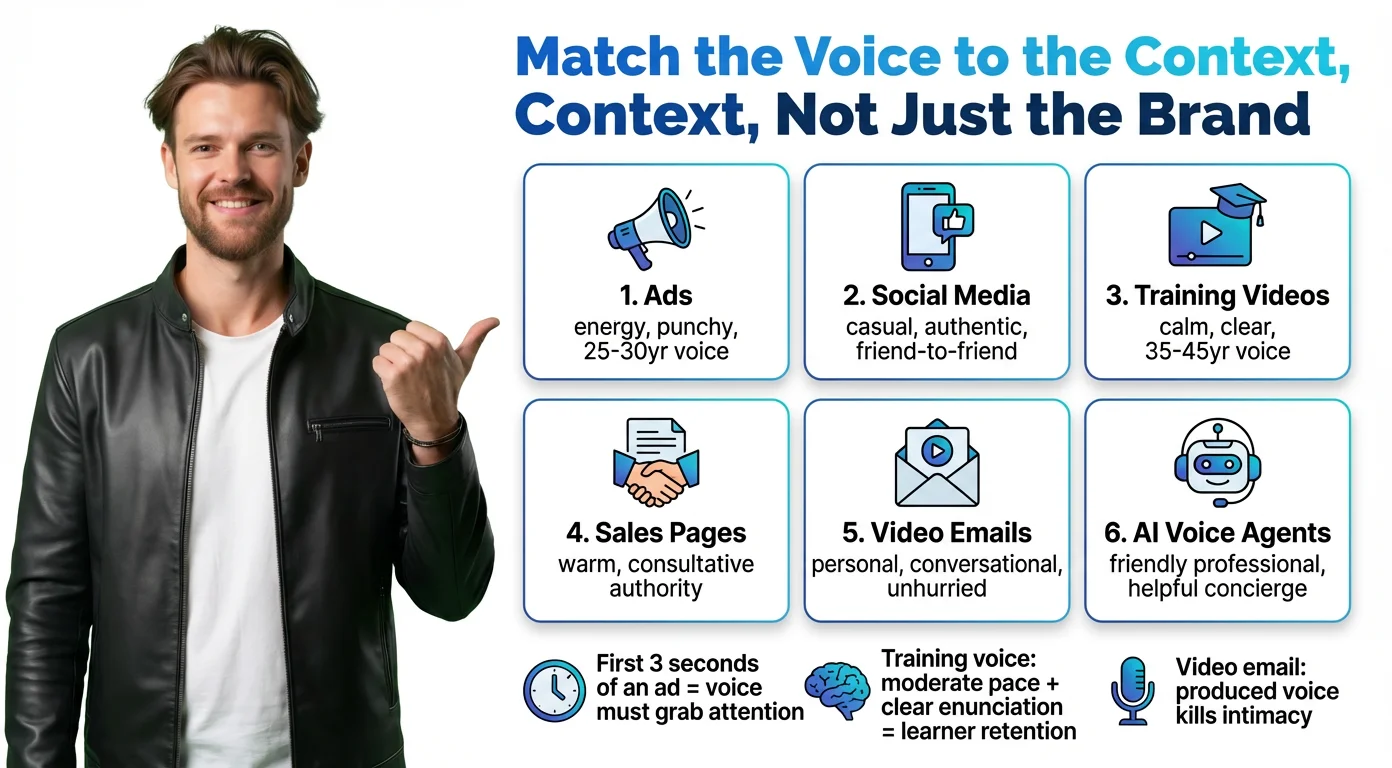
Kesalahan pertama adalah memperlakukan suara seperti warna merek: pilih satu dan pakai di mana mana. Suara yang membangun kepercayaan di halaman penjualan bisa terdengar kaku di klip media sosial, dan suara iklan yang terengah engah melelahkan setelah sepuluh menit materi pelatihan.
Beginilah cara saya menggeser suara sesuai penggunaan.
Iklan dan Konten Promosi
Anda hanya punya sekitar tiga detik untuk menarik perhatian, jadi suara butuh energi dan dorongan ke depan. Persona usia pertengahan 20an sampai awal 30an cocok untuk produk konsumen. Nada yang lebih dalam dan stabil cocok untuk B2B atau merek premium. Minta tempo bersemangat dan penyampaian yang tegas.
Video Media Sosial
Media sosial menghargai kesan orang sungguhan yang berbicara kepada teman. Santai, langsung, sedikit antusias. Apa pun yang terdengar diproduksi akan memecahkan suasana. Minta nada percakapan, mudah didekati, dan tempo alami.
Video Pelatihan dan Penjelasan
Orang mengikutinya lebih lama, jadi kejelasan lebih penting daripada kepribadian. Tenang dan terukur tanpa menjadi datar. Persona usia pertengahan 30an sampai pertengahan 40an memberi wibawa tanpa jarak. Minta artikulasi jelas, tempo sedang, hangat tetapi instruktif.
Halaman Penjualan dan Landing Page
Di sini tugasnya membangun kepercayaan. Suara harus terdengar seperti penasihat yang paham, yakin dan hangat, tanpa menekan. Hindari apa pun yang terasa dibuat buat. Minta nada konsultatif, timbre halus, wibawa dalam percakapan.
Email Video
Inti dari email video adalah terasa personal, dan suara yang terlalu diproduksi merusaknya dalam satu kalimat. Bidik percakapan empat mata: hangat, tidak terburu buru, dengan jeda alami.
Agen Suara AI (situs web dan landing page video)
Suara ini sering menjadi sentuhan merek pertama yang didengar pengunjung. Ia harus ramah dan membantu: kurang seperti naskah call center, lebih seperti rekan yang paham.
Usia mengikat semuanya. Suara usia 22 tahun yang menarasikan modul kepatuhan terasa janggal, dan suara usia 55 tahun di iklan TikTok terasa tidak nyambung. Ini salah satu tuas yang paling kurang dimanfaatkan dalam desain suara.
Apakah sisi "manusiawi" benar benar penting bagi pembeli? Satu studi vendor menunjukkan selisihnya kecil. Azerion, perusahaan iklan audio asal Inggris, menguji iklan pada 3.000 pendengar pada Maret dan April 2026. Hanya 29% dari mereka yang mendengar versi AI yang dengan benar menyebutnya buatan, dan 78% setuju suara AI terdengar alami, dibandingkan 75% untuk suara manusia. Anggap ini hasil dari vendor untuk dua merek rumah tangga, bukan aturan universal. Tetap saja, ini menunjukkan pendengar menilai penyampaian terlebih dahulu.

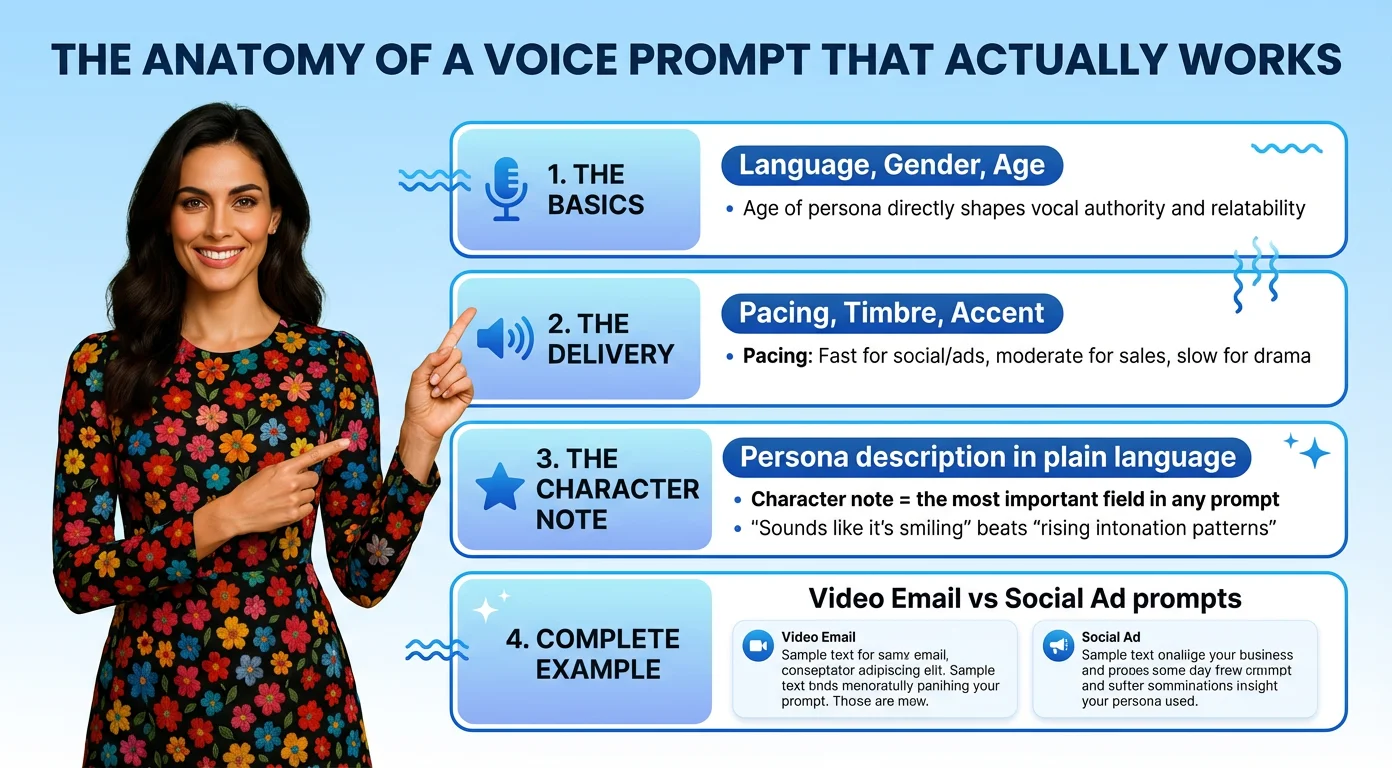
Anatomi Prompt Suara yang Benar Benar Berhasil
Prompt suara bukan daftar kata sifat. Ia adalah deskripsi karakter, cukup spesifik sehingga dua orang berbeda yang membacanya membayangkan pembicara yang sama.
Prompt yang kuat memiliki tiga lapisan.
Dasar: Bahasa, Gender, dan Usia
Ini menetapkan batas luar. "Perempuan, awal 30an, bahasa Inggris Amerika" jauh lebih baik daripada "perempuan". Usia membentuk kualitas suara, energi, dan wibawa, jadi jangan dibiarkan samar.
Penyampaian: Tempo, Timbre, dan Aksen
Tempo mengatur energi: cepat untuk media sosial dan iklan, sedang untuk penjualan dan pelatihan, lambat untuk drama. Timbre adalah tekstur suara: hangat, cerah, dalam, serak, halus. Aksen menambah karakter dan lokalisasi, dan bisa menentukan apakah suara terasa asli bagi audiens Anda atau sedikit janggal.
Catatan Karakter: Kolom yang Paling Penting
Di sinilah suara berubah dari generik menjadi spesifik. Gambarkan orangnya, bukan akustiknya. "Terdengar seperti tersenyum saat bicara denganmu" menghasilkan hasil lebih baik daripada "pola intonasi naik dengan kedekatan frontal".
Catatan karakter yang cenderung berhasil:
- Bintang Radio: cerah, berenergi tinggi, rapi. Iklan dan promo.
- Narator Sinematik: dalam, tenang, dramatis. Cerita merek.
- Pembawa Podcast: santai, hangat, penasaran. Penjelasan dan opini ahli.
- Pelatih Ramah: jelas, menyemangati, sabar. Pelatihan dan onboarding.
- DJ Larut Malam: halus, rendah, akrab. Konten mewah dan beratmosfer.
- Pembaca Berita: tegas, netral, berwibawa. Laporan dan pembaruan.
Dua Contoh Lengkap
Untuk email video: "Suara perempuan hangat dan ramah, awal 30an, bahasa Inggris Amerika, tempo sedang. Komunikatif dan mudah didekati, seperti rekan kerja yang berbagi saran berguna sambil minum kopi. Sedikit senyum dalam penyampaian. Profesional tetapi tidak pernah kaku."
Untuk iklan media sosial: "Suara laki laki enerjik, pertengahan 20an, aksen Amerika netral, tempo cepat. Percaya diri dan bersemangat, seperti orang yang baru menemukan sesuatu yang hebat dan tak sabar menceritakannya. Timbre cerah, penyampaian tegas."
Yang membedakan prompt ini dari prompt yang lemah bukan panjangnya. Prompt ini menggambarkan kepribadian, bukan hanya parameter.
Cara BIGVU Mengubah Prompt Menjadi Suara Merek dalam Kurang dari 2 Menit
Menulis prompt adalah pekerjaan strategis. Menghasilkan suara seharusnya lancar, dan itulah tujuan alat Voice Design BIGVU.
Alurnya ada di dalam Brand Kit, di bawah Branded Media. Berjalan dalam empat langkah.
Langkah 1: Atur Parameter
Pilih bahasa, aksen, gender, tempo, usia, dan timbre di antarmuka Voice Design. Ini input teknis Anda, kerangka tempat AI bekerja.
Langkah 2: Tulis Catatan Karakter
Inilah kolom prompt yang penting. BIGVU menyebutnya "catatan tambahan", tetapi perlakukan sebagai brief casting. "Energi bintang radio", "sinematik dan membara pelan", "hangat dan lucu seperti pembawa acara pagi". Tulis karakternya, bukan spesifikasinya.
Langkah 3: Hasilkan Tiga Variasi dan Pilih
BIGVU menghasilkan tiga interpretasi berbeda dari prompt Anda. Dengarkan masing masing dengan naskah contoh, bandingkan kesannya, dan pilih satu. Anda juga melihat deskripsi dalam bahasa sederhana tentang apa yang dihasilkan, sehingga tahu apa yang Anda simpan.
Langkah 4: Beri Nama dan Simpan
Beri nama pada suara (BIGVU dapat menyarankan satu berdasarkan bahasa dan konteks budaya), periksa deskripsinya, lalu simpan. Suara langsung masuk ke Content Bank Anda, dengan gambar potret buatan AI (wajah, setengah badan, seluruh badan) yang siap untuk produksi video.
Seluruh prosesnya memakan waktu kurang dari dua menit. Tanpa casting, tanpa studio, tanpa pengisi suara. Suara ini milik Anda, tersimpan dan bisa dipakai ulang di setiap video.
Alur yang sama berlaku di semua bahasa. Suara Portugis yang hangat untuk Brasil, suara Jepang profesional untuk Tokyo, suara Spanyol yang cepat untuk media sosial Amerika Latin: ubah bahasa, aksen, dan catatan budaya, dan hasilnya menyesuaikan.

Mengarahkan Pembacaan: Tag Audio, Jeda, dan Naskah Itu Sendiri
Suara yang bagus adalah separuh pekerjaan. Separuh lainnya adalah bagaimana kalimat disampaikan, dan di sini alat alat berbeda lebih jauh daripada yang diakui pemasarannya.
Tag Audio di ElevenLabs v4
ElevenLabs menyatakan Eleven v4 dan Eleven v3 mendukung tag audio: instruksi singkat dalam kurung siku, diletakkan di tempat penyampaian harus berubah. Pusat bantuannya mencantumkan contoh seperti [curious], [whispers], [laughs], dan [clears throat]. Satu detail praktis dari dokumentasinya: Eleven v4 dan v3 tidak mendukung tag jeda SSML, jadi jeda berasal dari tag seperti [pause] dan [long pause], atau dari tanda baca. Dalam contoh ElevenLabs sendiri, kalimat pendek yang sama berlangsung empat detik tanpa tag [pause] dan enam detik dengannya.
Tutorial di kanal resmi ElevenLabs menambahkan alur kerja yang berguna. Susun tag dalam satu baris, misalnya pembukaan gugup, dehaman, lalu bisikan pada satu kata. Pada naskah panjang, tombol Auto tag memindai teks dan menambahkan tag sesuai konteks. Jika tag masih meleset, rekam sendiri kalimatnya dan gunakan Voice Changer, karena "semakin dekat Anda dengan penyampaian yang diinginkan dalam rekaman, semakin dekat hasilnya" (terjemahan kutipan bahasa Inggris).
Arahan Bahasa Biasa di Tempat Lain
Alat lain mengambil jalur berbeda. Panduan text to speech OpenAI memakai kolom instruksi, dengan contoh seperti "Speak in a cheerful and positive tone." Periksa tanggalnya sebelum Anda membangun di atasnya. Dokumentasi OpenAI menyatakan model tts 1, tts 1 hd, dan gpt 4o mini tts "sudah usang dan akan dimatikan pada 6 Januari 2027" (terjemahan dari bahasa Inggris). Google mengatakan text to speech Gemini 3.8 memungkinkan Anda menulis arahan panggung sendiri dan menambahkan isyarat seperti |mhm| untuk tekstur percakapan. Panduan Octave dari Hume menyampaikan poin yang berlaku di mana saja: gunakan teks masukan yang ekspresif untuk mendapat ucapan yang lebih ekspresif, dan tulis satu kata dengan huruf kapital untuk penekanan lebih kuat.
Naskah Berperan Lebih Besar dari yang Anda Kira
Kreator Isaac, yang video YouTube nya ditonton lebih dari 735.000 kali, meringkas suara AI yang terdengar manusiawi menjadi empat hal: perubahan nada, jeda, penekanan, dan naskah yang tidak langsung diambil dari ChatGPT. Ia juga menghasilkan beberapa kalimat sekali jalan, bukan seluruh naskah. Nasihat ini berlaku untuk alat suara apa pun dan tidak memakan biaya.
Sanggahan yang Jujur: Tag Tidak Selalu Andal
Jangan berharap tag selalu patuh. Pengulas Janine Heinrichs dari Unite.AI menulis pada September 2026 bahwa "kelemahan terbesar adalah kepatuhan yang tidak konsisten terhadap tag performa" (terjemahan dari bahasa Inggris). Isaac mendapati bahwa menambahkan tag v3 pada klon miliknya berarti "suara itu sendiri sedikit berubah", sehingga ia kembali ke v2 dengan stabilitas lebih rendah. Videonya terbit sebelum v4, jadi keluhan itu mungkin tidak berlaku lagi. Jawaban praktisnya: pakai sedikit tag, letakkan tepat sebelum kata yang ingin dipengaruhi, dan dengarkan setiap hasil.
Satu kehati hatian lagi soal klaim kinerja. ElevenLabs menyatakan Eleven v4 diperingkat nomor satu oleh Artificial Analysis dan dipilih sekitar 75% pendengar dalam uji buta. Itu angka milik ElevenLabs sendiri, dan Google membuat klaim peringkat satu sendiri untuk Gemini 3.8 pada tolok ukur yang berbeda. Uji dengan naskah Anda sendiri.
Kesalahan Prompt yang Umum, dan Mengapa Manusiawi Tidak Berarti Disembunyikan
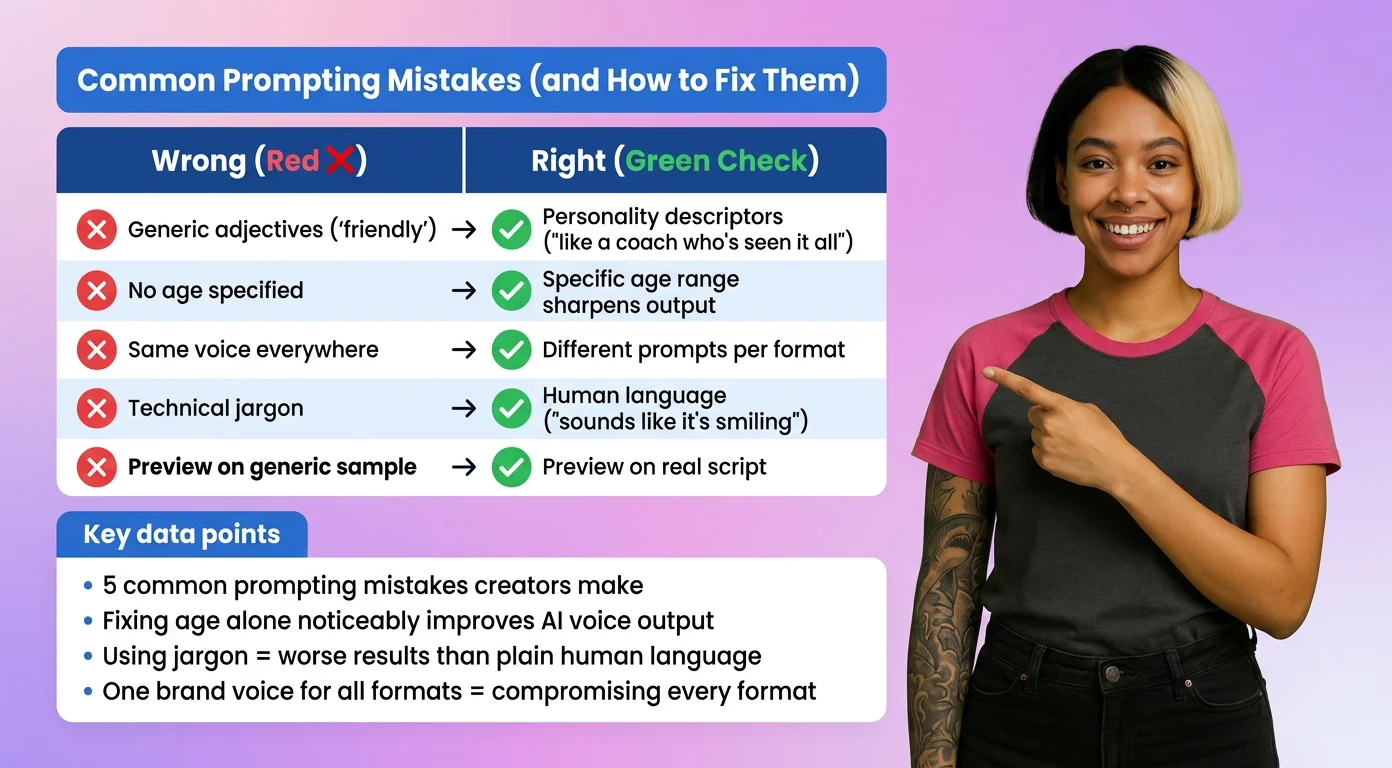
Sebagian besar suara yang meleset gagal karena segelintir alasan yang sama.
Hanya Memakai Kata Sifat Generik
"Profesional", "ramah", "jelas". Setiap suara yang layak memang begitu, jadi kata kata ini hampir tidak memberi apa apa pada AI. Gantilah dengan kepribadian: "seperti pelatih berpengalaman yang sudah melihat segalanya tetapi masih bersemangat membantu".
Melewatkan Usia
Tanpa patokan usia, suara akan jatuh di tengah, yang biasanya lumayan dan jarang bagus. Sebutkan rentangnya dan hasilnya akan lebih tajam.
Memakai Suara yang Sama di Mana Mana
Satu suara merek untuk semua format tidak melayani satu pun dengan baik. Halaman penjualan, klip media sosial, dan video onboarding Anda punya tugas berbeda. Beri mereka variasi prompt yang berbeda.
Menulis Jargon, Bukan Deskripsi
"Variasi prosodi" dan "vocal fry" mungkin akurat, tetapi model merespons lebih baik pada bahasa manusia. Gambarkan pengalaman mendengarkan. "Terdengar seperti tersenyum" mengalahkan "nada tinggi dengan modulasi naik".
Melewatkan Pratinjau dengan Naskah Asli
Suara bisa bersinar pada kalimat contoh dan jatuh pada teks asli Anda. Dengarkan satu atau dua baris dari naskah yang akan dinarasikannya.
Berusaha Dikira Manusia
Ini soal etika sama seperti soal praktis. Kebijakan penggunaan OpenAI "mewajibkan Anda memberi pengungkapan yang jelas kepada pengguna akhir bahwa suara TTS yang mereka dengar dibuat oleh AI" (terjemahan dari bahasa Inggris). Survei Adobe 2026 terhadap 850 konsumen AS menemukan 88% pernah mendengar suara dan bertanya tanya apakah itu AI, sementara 77% tetap paling percaya suara manusia. Adobe menjual alat audio AI, jadi baca ini sebagai studi vendor. Makna yang masuk akal dari "terdengar manusiawi" adalah penyampaian alami, hangat, dan temponya pas, bukan menyembunyikan bahwa mesin yang berbicara.
Klon menaikkan taruhannya. Studi PLOS One 2025 menemukan pendengar tidak bisa secara andal membedakan klon suara dari suara manusia asli, tetapi bisa mengenali suara AI generik. Sampelnya kecil, 50 peserta per eksperimen, namun pelajarannya jelas: jika suara Anda bisa mengelabui orang, katakan saja.