
Ce qui se passe vraiment quand une photo apprend à parler
En coulisses, la plupart des outils de photo parlante IA reposent sur une version du même procédé. Dans une discussion sur r/generativeAI, des utilisateurs le décrivaient en deux étapes : un modèle de reconstitution faciale donne d'abord un mouvement naturel à l'image fixe, puis un modèle de synchronisation labiale piloté par l'audio redessine la bouche pour chaque son de la piste vocale. Les noms open source qui reviennent le plus souvent sont SadTalker et LivePortrait pour le mouvement et Wav2Lip pour la bouche, tandis que D-ID et HeyGen regroupent des étapes similaires dans un produit.
Pourquoi la bouche est la partie la plus difficile
Les chercheurs à l'origine de MuseTalk, un modèle de synchronisation labiale présenté dans un article sur arXiv, décrivent le problème comme un trilemme. Les méthodes par diffusion offrent un très beau rendu mais coûtent cher à faire tourner. Les méthodes GAN, plus rapides, sacrifient souvent la précision labiale ou les « détails dentaires », une façon savante de dire que les dents deviennent floues. MuseTalk travaille dans un espace latent compressé pour obtenir à la fois vitesse et détail, et annonce 30 images par seconde en 256 sur 256 pixels sur une seule carte graphique NVIDIA V100.
Retenez ce chiffre de résolution. Le modèle ne redessine qu'une petite zone autour de la bouche, puis la fond dans votre image en taille réelle. Quand le visage est petit, tourné ou mal éclairé, il reste moins de détails réels à exploiter, et c'est généralement là que l'illusion se brise.
Où regarder pour juger le résultat
Un créateur qui a comparé HeyGen à un outil moins cher dans un test côte à côte sur YouTube propose une liste utile : observez les commissures des lèvres, regardez ce que fait la tête à la fin d'une phrase et écoutez les consonnes dures comme le P et le B, car c'est « généralement là que les outils de synchronisation labiale bon marché s'effondrent complètement ».
La photo que vous importez décide de presque tout
Aucune plateforme ne peut animer ce qui ne figure pas sur l'image, alors la photo mérite plus de soin que les réglages. Les conseils de ceux qui produisent ces vidéos chaque semaine se recoupent largement.
- Regardez l'objectif. Un tutoriel Hedra de février 2026 recommande une photo nette, visage tourné droit vers l'objectif, bien éclairée, et déconseille les profils et les images floues. Il précise aussi que Hedra refuse les images de moins de 300 pixels.
- Partez d'une expression neutre. Le même tutoriel suggère une expression neutre si le rendu paraît figé, ainsi qu'un meilleur éclairage et un son propre, car un audio clair « améliore la précision de la synchronisation labiale ».
- Gardez des clips courts. « Les clips plus courts paraissent plus réalistes », note le tutoriel. Découpez un long script en plusieurs vidéos courtes plutôt qu'en une seule longue prise.
- Modérez le mouvement. Une créatrice qui fabrique des avatars à partir d'une seule image dans son tutoriel HeyGen ajoute une consigne de mouvement personnalisée demandant un rendu naturel, peu de dents visibles et pas de mains, car le réglage par défaut peut rendre les personnages trop expressifs.
- Fournissez plusieurs photos si possible. HeyGen conseille d'importer quelques photos supplémentaires de vous pour que son modèle capte davantage de détails.
La voix compte autant que le visage. Une piste vocale plate et précipitée rend fausse même une bouche parfaite. Écrivez le script pour l'oral, lisez ce texte une fois à voix haute et supprimez toute phrase sur laquelle vous trébuchez avant de générer quoi que ce soit.
BIGVU, HeyGen et Hedra : ce que chacun vous apporte
Tous trois transforment une photo en avatar parlant, mais ils visent des acheteurs différents. Voici ce que chaque éditeur affiche aujourd'hui sur ses propres pages.
BIGVU AI Talking Photo
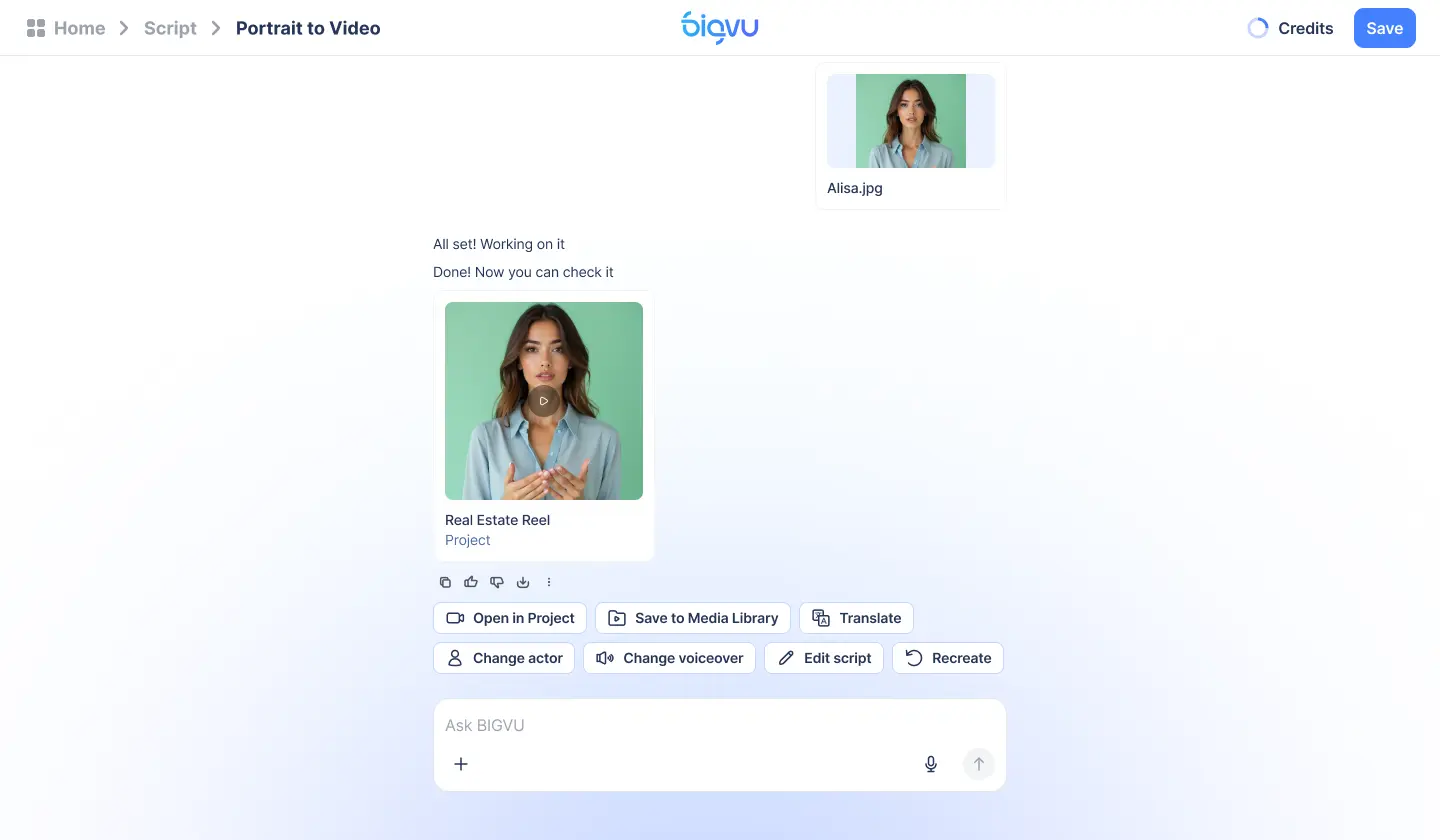
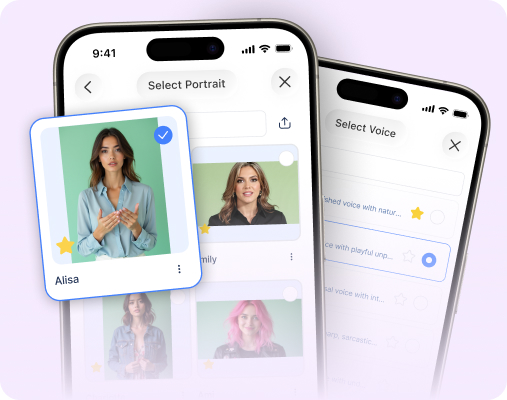
AI Talking Photo de BIGVU fonctionne en trois étapes : importer un portrait, ajouter le script et la voix, puis générer et publier. Vous pouvez écrire le script ou le rédiger avec l'AI Script Generator, puis choisir une voix dans la bibliothèque de BIGVU ou cloner la vôtre. La vidéo synchronisée reste dans la même application pour les sous-titres, votre kit de marque et la publication, et vous pouvez travailler sur le web, sur iPhone ou sur Android. Les fonctions IA consomment des crédits mensuels, que la page des tarifs traduit en durée de vidéo : les 500 crédits de l'offre gratuite couvrent une vidéo portrait d'environ 10 secondes, les 3 000 crédits d'AI Pro environ une minute.
HeyGen Photo Avatar
La page des avatars photo de HeyGen met en avant des photos parlantes dans plus de 175 langues et dialectes, des consignes textuelles et des packs de styles qui changent votre tenue ou le décor, ainsi que son moteur Avatar IV, qui transforme une seule image en vidéo avec synchronisation vocale et gestes des mains. Sur sa page de tarifs, l'offre gratuite donne 3 vidéos par mois avec filigrane, d'une minute maximum chacune, Creator coûte 29 dollars par mois avec 600 crédits et Pro 49 dollars par mois avec 1 000 crédits et des vidéos jusqu'à 30 minutes.
Hedra
La grille tarifaire de Hedra est la plus détaillée des trois. Sur son API, la génération d'avatar et de synchronisation labiale démarre à 2,5 cents par seconde à partir d'un solde prépayé en dollars, sans abonnement, et le clonage de voix est gratuit. Si vous préférez son application Studio, les offres vont de Basic à 20 dollars par mois pour 2 000 crédits à Pro à 50 dollars pour 7 200 crédits et Ultra à 100 dollars pour 18 000 crédits.
Le meilleur ou le plus rentable
Le créateur du test côte à côte a été direct : HeyGen l'emporte sur le réalisme, « ce n'est même pas comparable », et pourtant il utilise davantage l'outil moins cher, car son avatar n'ouvre une vidéo que pendant 60 à 80 secondes avant de laisser place aux captures d'écran. Sa règle vaut pour tous ces outils vidéo IA. Si le visage est le produit, payez l'option la plus réaliste. Si le visage n'est qu'une courte introduction, un résultat correct suffit.
Où les photos parlantes sont utiles, et où elles ne le sont pas
Les photos parlantes excellent pour les messages récurrents qui ont besoin d'un visage mais pas d'une équipe de tournage. BIGVU cite comme usages types les points marché, les nouvelles annonces immobilières, les présentations de quartier, les FAQ, les promotions, les annonces internes et les explications produit, et leur point commun est la répétition. Avec un seul portrait validé, vous produisez la cinquième mise à jour du mois sans mobiliser le temps de qui que ce soit.
Les bons usages
- Introductions courtes et mises à jour régulières. Un visage familier pendant la première minute, puis des diapositives, des démonstrations ou des images du bien.
- Marketing par email vidéo. Un mot personnel en tête d'un email de relance paraît plus chaleureux qu'un simple texte. L'outil d'email vidéo de BIGVU permet de l'envoyer depuis le même compte.
- Des annonces sans tournage. Les agents immobiliers peuvent associer une introduction en photo parlante à Fototale, qui transforme les photos existantes d'un bien en vidéo avec panoramiques, zooms et transitions.
Les usages risqués
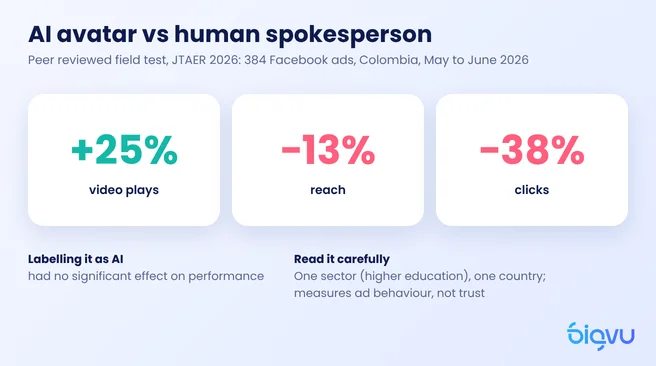
Soyez prudent là où la confiance est essentielle. Une étude de terrain évaluée par des pairs portant sur 384 publicités Facebook, publiée dans le Journal of Theoretical and Applied Electronic Commerce Research en 2026, a constaté qu'un avatar IA obtenait 25 % de lectures vidéo en plus qu'un présentateur humain, mais 13 % de portée en moins et 38 % de clics en moins. L'étude portait sur des publicités pour l'enseignement supérieur en Colombie, il faut donc y voir un indice, pas une loi. Elle rejoint néanmoins le conseil du créateur YouTube cité plus haut : pour le travail client, une marque incarnée par un visage ou tout ce qu'un client payant examinera image par image, il recommande l'outil le plus réaliste que vous puissiez vous offrir, ou un vrai tournage.
Transparence, consentement et nouvelles règles
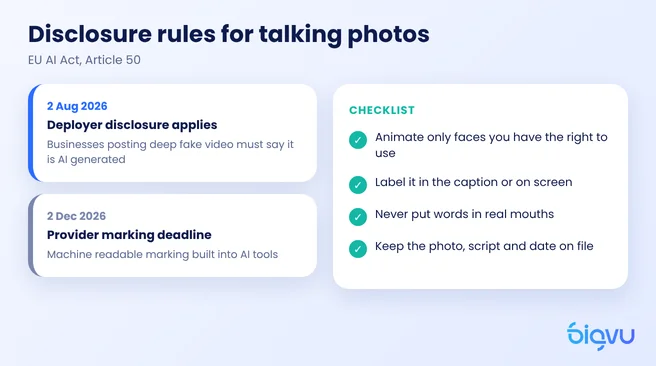
L'éthique des photos parlantes relevait autrefois des bonnes manières. Dans l'Union européenne, c'est désormais aussi une obligation légale. L'article 50 du règlement européen sur l'IA prévoit que quiconque déploie un système d'IA qui génère ou manipule une vidéo constituant un hypertrucage doit indiquer que le contenu a été généré ou manipulé par une IA, et que cette information doit être claire au plus tard au moment où le spectateur le voit pour la première fois. Comme l'a expliqué Morgan Lewis, ces obligations de transparence s'appliquent depuis le 2 août 2026. Une transition distincte de quatre mois, jusqu'au 2 décembre, ne concerne que le marquage lisible par machine que les fournisseurs doivent intégrer, et elle ne reporte pas les obligations des entreprises qui publient les vidéos.
Une liste simple
- N'animez que des visages que vous avez le droit d'utiliser. Le vôtre, ou celui d'une personne qui vous a donné son accord explicite. Jamais un client, un concurrent ou une célébrité sans consentement.
- Ajoutez une mention. Une courte mention dans la légende ou à l'écran, comme « Cette vidéo utilise une photo parlante IA », couvre l'obligation de base et ne vous coûte presque rien.
- Ne mettez pas de mots dans la bouche de vraies personnes. Une photo parlante de vous lisant votre propre script, c'est une chose. Faire croire qu'une personne soutient ce qu'elle n'a jamais dit en est une autre.
- Gardez une trace. Conservez la photo d'origine, le script et la date, au cas où l'on vous demanderait comment une vidéo a été réalisée.
Si vous craignez qu'une mention nuise aux résultats, la même étude sur les publicités Facebook est rassurante : indiquer aux spectateurs que la publicité avait été faite avec l'IA n'a eu aucun effet significatif sur les performances. Ici, l'honnêteté ne coûte rien.