
Que se passe-t-il réellement lorsqu'une photo apprend à parler
Sous le capot, la plupart des outils photo parlants d’IA exécutent une version du même pipeline. Dans une analyse sur r/generativeAI , les utilisateurs l'ont décrit en deux étapes : d'abord un modèle de reconstitution du visage donne à l'image fixe un mouvement naturel, puis un modèle de synchronisation labiale piloté par l'audio remodèle la bouche pour qu'elle corresponde à chaque son de la piste vocale. Les noms open source qui reviennent encore et encore sont SadTalker et LivePortrait pour le mouvement et Wav2Lip pour la bouche, tandis que D-ID et HeyGen intègrent des étapes similaires dans un produit.
Pourquoi la bouche est la partie la plus difficile
Les chercheurs derrière MuseTalk, un modèle de synchronisation labiale décrit dans un article sur arXiv , présentent le problème comme un trilemme. Les méthodes basées sur la diffusion ont fière allure mais sont coûteuses à mettre en œuvre. Les méthodes plus rapides basées sur le GAN ont tendance à sacrifier soit la précision de la synchronisation labiale, soit les « détails dentaires », ce qui est la manière académique polie de dire que les dents deviennent pâteuses. MuseTalk fonctionne dans un espace latent compressé pour obtenir à la fois vitesse et détails, et rapporte 30 images par seconde à 256 x 256 pixels sur une seule carte graphique NVIDIA V100.
Ce chiffre de résolution mérite d’être rappelé. Le modèle redessine uniquement une petite région autour de la bouche, puis la mélange à nouveau dans votre image en taille réelle. Lorsque le visage est petit, détourné ou mal éclairé, il y a moins de détails réels à travailler, et c'est généralement là que l'illusion se brise.
Où chercher quand on en juge un
Un créateur qui a comparé HeyGen à un outil moins cher lors d'un test côte à côte sur YouTube a donné une liste de contrôle utile : surveillez les coins de la bouche, observez ce que fait la tête à la fin d'une phrase et écoutez les consonnes dures comme P et B, car c'est "généralement là que les outils de synchronisation labiale moins chers s'effondrent complètement".
La photo que vous téléchargez détermine la majeure partie du résultat
Chaque plate-forme ne peut animer que ce qui est dans l'image, donc la saisie mérite plus d'attention que les paramètres. Les conseils des personnes qui réalisent ces vidéos chaque semaine sont étroitement liés.
- Faites face à la caméra. Un tutoriel Hedra de février 2026 recommande une photo claire avec le visage regardant droit vers l'objectif, bien éclairé, et met en garde contre les profils latéraux et les prises de vue floues. Il souligne également qu'Hedra rejette les images inférieures à 300 pixels.
- Commencez au neutre. Le même didacticiel suggère une expression neutre si le résultat semble rigide, ainsi qu'un meilleur éclairage et un son clair, car un son clair "améliore la précision de la synchronisation labiale".
- Gardez les clips courts. "Les clips plus courts semblent plus réalistes", note le didacticiel. Divisez un long script en plusieurs courtes vidéos plutôt qu'en une seule longue prise.
- Calmez le mouvement. Une créatrice qui crée des avatars à partir d'une seule image dans sa procédure pas à pas HeyGen ajoute une invite de mouvement personnalisée demandant un aspect naturel, peu de dents visibles et pas de mains, car la valeur par défaut peut rendre les personnages trop expressifs.
- Donnez-lui plus d'une chance si vous le pouvez. HeyGen suggère de télécharger quelques photos supplémentaires de vous-même afin que son modèle puisse capturer plus de détails.
La voix compte autant que le visage. Une voix plate et précipitée donne l’impression que même une bouche parfaite semble fausse. Écrivez le script pour parler, lisez-le une fois à voix haute et coupez toute phrase sur laquelle vous trébuchez avant de générer quoi que ce soit.
BIGVU vs HeyGen vs Hedra : ce que chacun vous apporte
Tous les trois transforment une photo en avatar parlant , mais ils sont conçus pour des acheteurs différents. Voici ce que chaque fournisseur affiche actuellement sur ses propres pages.
Photo parlante BIGVU AI
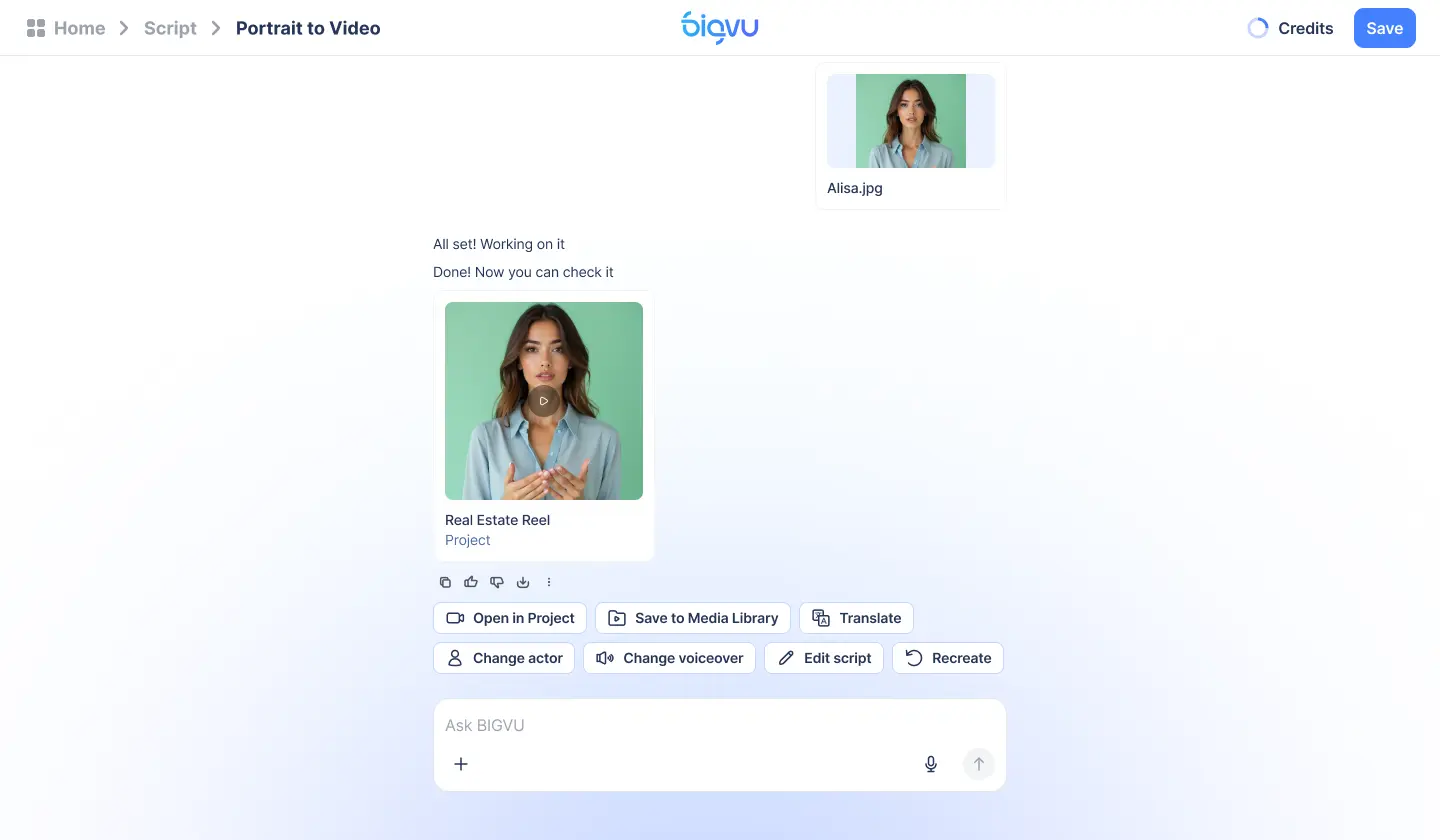
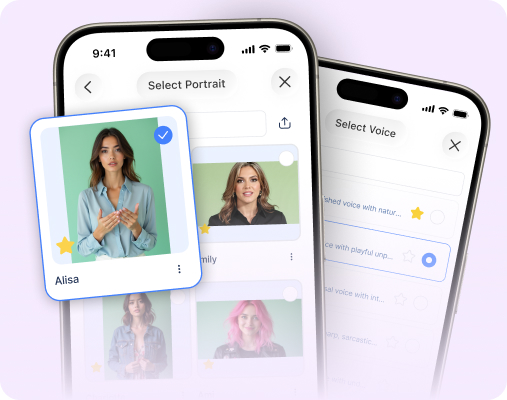
AI Talking Photo de BIGVU fonctionne en trois étapes : téléchargez un portrait, ajoutez votre script et votre voix, puis générez et publiez. Vous pouvez écrire le script vous-même ou le rédiger avec le générateur de script AI , et choisir une voix dans la bibliothèque de BIGVU ou cloner la vôtre . La vidéo synchronisée sur les lèvres reste ensuite dans la même application pour les sous-titres, votre kit de marque et la publication, et vous pouvez travailler depuis le Web, iPhone ou Android. Les fonctionnalités d'IA s'appuient sur des crédits mensuels, et la page de tarification les traduit en temps vidéo : les 500 crédits du forfait gratuit couvrent environ 10 secondes de portrait vidéo, les 3 000 crédits d'AI Pro environ une minute.
Avatar photo HeyGen
La page d'avatar photo de HeyGen propose des photos parlantes dans plus de 175 langues et dialectes, des invites textuelles et des packs de looks qui modifient votre tenue ou votre arrière-plan, ainsi que son moteur Avatar IV, qui transforme une seule image en vidéo avec synchronisation vocale et gestes de la main. Sur sa page de tarification , vérifiée le 1er novembre 2026, le forfait gratuit vous offre 3 vidéos filigranées par mois d'une durée maximale d'une minute chacune, Creator coûte 29 $ par mois avec 600 crédits et Pro coûte 49 $ par mois avec 1 000 crédits et vidéos jusqu'à 30 minutes. Notez que HeyGen indique que les crédits expirent si vous annulez, et que dans notre compte gratuit, les téléchargements étaient limités à 720p.
Hèdre
La page de tarification publique de Hedra n'affiche plus les forfaits mensuels. Il facture par sortie un solde en dollars prépayé : génération d'avatar et de synchronisation labiale à partir de 2,5 cents par seconde, mise à l'échelle à 2,14 cents par seconde, édition à 7 cents par seconde et rééclairage à 20 cents par seconde, sans abonnement.
Que s'est-il passé lorsque nous en avons créé un sur Hedra ?
Nous avons commencé avec le plan gratuit d'Hedra, qui comportait 100 crédits. La création de l'image de départ a nécessité 7 crédits et a pris environ une demi-minute. Pour la partie parlante, nous avons choisi Hedra Avatar, tapé un script de sept secondes et conservé la voix par défaut à 720p. Le bouton Générer indiquait 85 crédits. La balance a chuté de 40 et le résultat a été un clip de 6 secondes, 1280 x 720 avec un filigrane, prêt en deux minutes environ. Le sélectionneur de modèles a également montré à quel point les coûts peuvent varier : MiniMax H3 Max a été qualifié de meilleur rapport qualité-prix entre 50 et 240 crédits par génération, tandis que Seedance 2.5 a été qualifié de plus haute qualité avec 84 à 3 322 crédits.
Une autre chose est ressortie. À aucun moment le flux n’a montré une étiquette de divulgation d’IA, une vérification du consentement ou une question quant à savoir si nous avions les droits sur la photo. Le filigrane était le seul marquage. Cela vous impose directement la responsabilité de la divulgation, ce qui est important pour les règles décrites ci-dessous.
Le meilleur contre la peine
Le créateur du test côte à côte ci-dessus a été direct : HeyGen a gagné sur le réalisme, "ce n'est même pas proche", mais il utilise davantage l'outil le moins cher, car son avatar n'ouvre une vidéo que pendant 60 à 80 secondes avant que les enregistrements d'écran ne prennent le relais. Sa règle est bonne pour n’importe lequel de ces outils vidéo d’IA . Si le visage est le produit, payez pour l’option la plus réaliste. Si le visage est une brève introduction, c’est assez bien.
Où les photos parlantes gagnent leur vie, et où elles ne le font pas
Les photos parlantes brillent sur des messages récurrents qui nécessitent un visage mais pas une équipe de tournage. BIGVU répertorie les mises à jour du marché, les mises à jour des listes, les projecteurs du quartier, les FAQ, les promotions, les annonces internes et les explications de produits comme utilisations typiques, et le fil conducteur est la répétition. Une fois que vous avez un portrait approuvé, vous pouvez produire la cinquième mise à jour du mois sans réserver le temps de qui que ce soit.
Bons ajustements
- Courtes introductions et mises à jour récurrentes. Un visage familier pendant la première minute, puis des diapositives, des démos ou une liste de séquences.
- Marketing vidéo par e-mail. Un message d'accueil personnel en haut d'un e-mail de suivi semble plus chaleureux qu'un texte brut. L'outil de courrier électronique vidéo de BIGVU vous permet de l'envoyer à partir du même compte.
- Annonces sans tournage. Les agents immobiliers peuvent associer une introduction photo parlante à Fototale , qui transforme les photos d'annonces existantes en vidéo avec des panoramiques, des zooms et des transitions.
Ajustements faibles
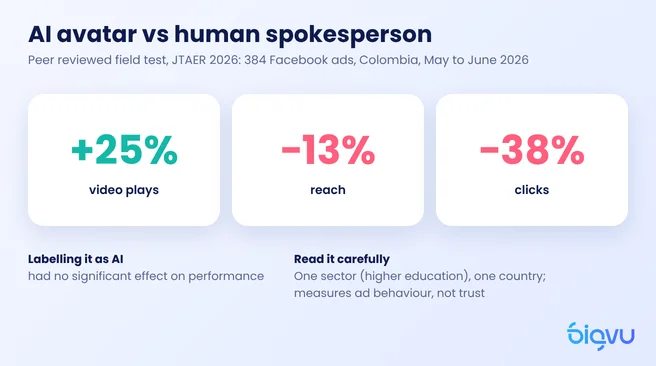
Soyez prudent lorsque la confiance est le principal objectif. Un test sur le terrain de 384 publicités Facebook, évalué par des pairs et publié dans le Journal of Theoretical and Applied Electronic Commerce Research en 2026, a révélé qu'un avatar IA gagnait 25 % de lectures vidéo en plus qu'un porte-parole humain, mais 13 % de portée en moins et 38 % de clics en moins. L'étude a couvert les publicités pour l'enseignement supérieur en Colombie, il faut donc la considérer comme un point de données et non comme une loi. Cela correspond néanmoins aux conseils du créateur de YouTube cités précédemment : pour le travail d'un client, une marque de porte-parole ou tout ce qu'un client payant étudiera image par image, il recommande l'outil le plus réaliste que vous puissiez vous permettre, ou un véritable enregistrement.
Divulgation, consentement et nouvelles règles
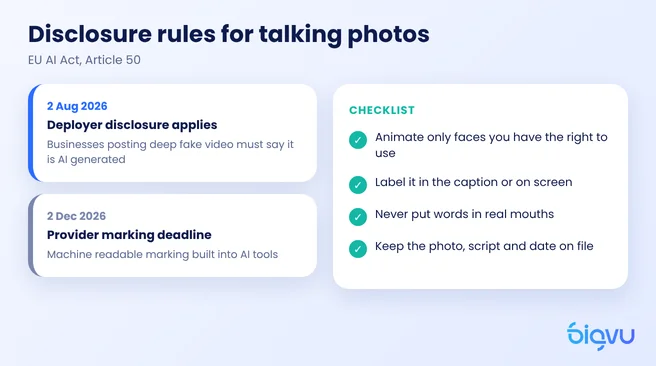
L’éthique des photos parlantes était autrefois une question de bonnes manières. Dans l’Union européenne, c’est désormais également une obligation légale. L'article 50 de la loi européenne sur l'IA stipule que toute personne déployant un système d'IA qui génère ou manipule une vidéo constituant un deep fake « doit révéler que le contenu a été généré ou manipulé artificiellement », et que cela doit être clair au plus tard lorsqu'un spectateur le voit pour la première fois. Comme l'explique Morgan Lewis , ces obligations de transparence ont commencé à s'appliquer le 2 août 2026. Une transition distincte de quatre mois jusqu'au 2 décembre ne couvre que le marquage lisible par machine que les fournisseurs doivent intégrer, et ne reporte pas les obligations des entreprises publiant les vidéos.
Le 10 juin 2026, la Commission européenne a également publié un code de bonnes pratiques final sur le marquage et l'étiquetage du contenu généré par l'IA, avec un ensemble d'icônes européennes pour le contenu entièrement généré par l'IA et partiellement modifié par l'IA. Une photo parlante d’une personne réelle est un cas d’école pour cette étiquette.
Une simple liste de contrôle
- Animez uniquement les visages que vous avez le droit d’utiliser. Le vôtre ou celui de quelqu’un qui vous a donné une autorisation explicite. Jamais un client, un concurrent ou une célébrité sans consentement.
- Étiquetez-le. Une courte ligne dans la légende ou à l'écran, telle que "Cette vidéo utilise une photo parlante IA", couvre la tâche de base et vous coûte très peu.
- Ne mettez pas de mots dans de vraies bouches. Une photo parlante de vous en train de lire votre propre scénario est une chose. Faire en sorte que quelqu’un semble approuver quelque chose qu’il n’a jamais dit en est une autre.
- Tenez un registre. Enregistrez la photo originale, le script et la date, au cas où quelqu'un vous demanderait comment une vidéo a été réalisée.
Une étiquette va-t-elle nuire aux résultats ? Les preuves sont mitigées. L'étude publicitaire Facebook ci-dessus a révélé que le fait de dire aux téléspectateurs qu'une publicité avait été réalisée avec l'IA n'avait aucun effet significatif sur les performances. Une étude réalisée en 2025 auprès de 358 consommateurs dans le Journal of Research in Interactive Marketing a révélé le contraire : la divulgation réduisait la valeur que les gens trouvaient à l'annonce et leur intention d'achat. Notre point de vue est que le label est obligatoire de toute façon dans l'UE, la meilleure question est donc de savoir comment rendre la vidéo intéressante à regarder une fois que les gens le savent. Un vrai scénario, une vraie offre et une voix qui donne l'impression que vous allez loin.
Si vous préférez ne pas les produire vous-même, l'équipe SuperAgent de BIGVU peut réaliser vos vidéos mensuelles avec une TalkingPhoto dans votre voix clonée, avec un stratège dédié, des légendes et des miniatures, 8 vidéos par mois à partir de 299 $ par mois facturées mensuellement.