
Was passiert eigentlich, wenn ein Foto sprechen lernt?
Unter der Haube führen die meisten KI-sprechenden Fototools eine Version derselben Pipeline aus. In einer Aufschlüsselung zu r/generativeAI beschrieben Benutzer es in zwei Phasen: Zuerst verleiht ein Gesichtsnachbildungsmodell dem Standbild eine natürliche Bewegung, dann formt ein audiogesteuertes Lippensynchronisationsmodell den Mund neu, um ihn an jeden Ton in der Sprachspur anzupassen. Die Open-Source-Namen, die immer wieder fallen, sind SadTalker und LivePortrait für Bewegung und Wav2Lip für den Mund, während D-ID und HeyGen ähnliche Schritte in ein Produkt packen.
Warum der Mund der schwierige Teil ist
Forscher hinter MuseTalk, einem Lippensynchronisationsmodell, das in einem Artikel auf arXiv beschrieben wird, bezeichnen das Problem als ein Trilemma. Diffusionsbasierte Methoden sehen gut aus, sind aber teuer in der Ausführung. Schnellere GAN-basierte Methoden neigen dazu, entweder die Genauigkeit der Lippensynchronisation oder „Zahndetails“ zu opfern, was die höfliche akademische Art ist, zu sagen, dass die Zähne matschig werden. MuseTalk arbeitet in einem komprimierten latenten Raum, um sowohl Geschwindigkeit als auch Details zu erzielen, und meldet 30 Bilder pro Sekunde bei 256 x 256 Pixeln auf einer einzelnen NVIDIA V100-Grafikkarte.
Diese Auflösungszahl ist es wert, im Gedächtnis behalten zu werden. Das Modell zeichnet nur einen kleinen Bereich um den Mund herum neu und fügt ihn dann wieder in Ihr Bild in voller Größe ein. Wenn das Gesicht klein, abgewandt oder schlecht beleuchtet ist, gibt es weniger reale Details, mit denen man arbeiten kann, und das ist normalerweise der Punkt, an dem die Illusion bricht.
Wo man suchen muss, wenn man einen beurteilt
Ein YouTuber, der HeyGen in einem Side-by-Side-Test auf YouTube mit einem günstigeren Tool verglich, gab eine nützliche Checkliste: Achten Sie auf die Mundwinkel, achten Sie darauf, was der Kopf tut, wenn ein Satz endet, und achten Sie auf harte Konsonanten wie P und B, denn dort „versagen billigere Lippensynchronisationstools normalerweise völlig.“
Das von Ihnen hochgeladene Foto entscheidet größtenteils über das Ergebnis
Jede Plattform kann nur das animieren, was im Bild ist, daher verdient die Eingabe mehr Sorgfalt als die Einstellungen. Die Ratschläge von Leuten, die diese Videos jede Woche machen, stimmen genau überein.
- Schauen Sie in die Kamera. Ein Hedra-Tutorial vom Februar 2026 empfiehlt ein klares Foto, bei dem das Gesicht direkt auf die Linse blickt, gut beleuchtet ist, und warnt vor Seitenprofilen und verschwommenen Aufnahmen. Außerdem wird darauf hingewiesen, dass Hedra Bilder ablehnt, die kleiner als 300 Pixel sind.
- Beginnen Sie neutral. Das gleiche Tutorial schlägt einen neutralen Ausdruck vor, wenn das Ergebnis steif aussieht, sowie eine bessere Beleuchtung und einen sauberen Ton, da klarer Ton „die Genauigkeit der Lippensynchronisation verbessert“.
- Halten Sie die Clips kurz. „Kürzere Clips sehen realistischer aus“, heißt es im Tutorial. Teilen Sie ein langes Drehbuch in mehrere kurze Videos auf, statt in eine lange Aufnahme.
- Beruhigen Sie die Bewegung. Eine Erstellerin, die in ihrer HeyGen-Komplettlösung Avatare aus einem einzigen Bild erstellt, fügt eine benutzerdefinierte Bewegungsaufforderung hinzu und bittet um ein natürliches Aussehen, wenige sichtbare Zähne und keine Hände, da die Standardeinstellung dazu führen kann, dass Charaktere übermäßig ausdrucksstark sind.
- Versuchen Sie es mehr als einmal, wenn Sie können. HeyGen empfiehlt, ein paar zusätzliche Fotos von sich hochzuladen, damit das Modell mehr Details einfangen kann.
Die Stimme ist genauso wichtig wie das Gesicht. Eine flache, hektische Sprachspur lässt selbst einen perfekten Mund falsch aussehen. Schreiben Sie das Skript zum Sprechen, lesen Sie es einmal laut vor und streichen Sie jeden Satz, über den Sie stolpern, bevor Sie etwas generieren.
BIGVU vs. HeyGen vs. Hedra: Was Ihnen jeder einzelne bietet
Alle drei verwandeln ein Foto in einen sprechenden Avatar , sind aber für unterschiedliche Käufer konzipiert. Hier ist, was jeder Anbieter derzeit auf seinen eigenen Seiten zeigt.
BIGVU AI sprechendes Foto
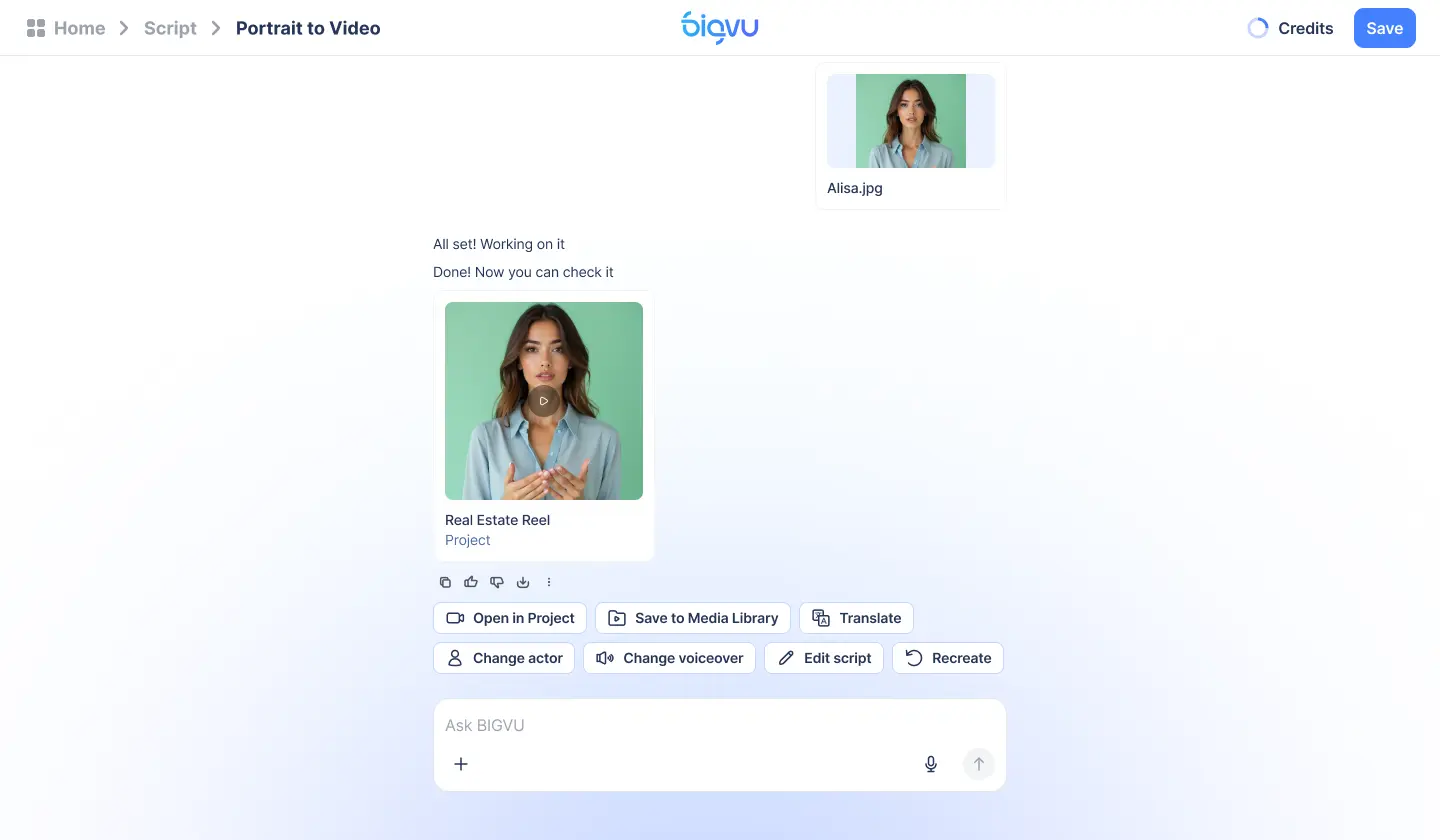
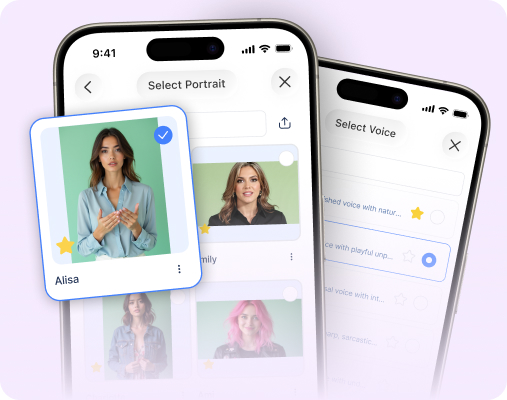
Das AI Talking Photo von BIGVU funktioniert in drei Schritten: Hochladen eines Porträts, Hinzufügen Ihres Skripts und Ihrer Stimme, dann Generieren und Veröffentlichen. Sie können das Skript selbst schreiben oder es mit dem AI Script Generator entwerfen und eine Stimme aus der BIGVU-Bibliothek auswählen oder Ihre eigene klonen . Das lippensynchrone Video bleibt dann für Untertitel, Ihr Marken-Kit und die Veröffentlichung in derselben App, und Sie können über das Internet, das iPhone oder Android arbeiten. Für AI-Funktionen sind monatliche Credits erforderlich, und auf der Preisseite werden diese in Videozeit umgerechnet: Die 500 Credits des kostenlosen Plans decken etwa ein 10-sekündiges Porträtvideo ab, die 3.000 Credits von AI Pro etwa eine Minute.
HeyGen-Foto-Avatar
Die Foto-Avatar-Seite von HeyGen wirbt für sprechende Fotos in mehr als 175 Sprachen und Dialekten, Textaufforderungen und Look-Packs, die Ihr Outfit oder Ihren Hintergrund ändern, sowie für die Avatar IV-Engine, die ein einzelnes Bild mit Sprachsynchronisierung und Handgesten in ein Video verwandelt. Auf der Preisseite , geprüft am 1. November 2026, erhalten Sie mit dem kostenlosen Plan 3 Videos mit Wasserzeichen pro Monat von jeweils bis zu 1 Minute, Creator kostet 29 $ pro Monat mit 600 Credits und Pro kostet 49 $ pro Monat mit 1.000 Credits und Videos von bis zu 30 Minuten. Beachten Sie, dass laut HeyGen das Guthaben verfällt, wenn Sie kündigen, und dass in unserem kostenlosen Konto die Downloads auf 720p beschränkt waren.
Hedra
Auf der öffentlichen Preisseite von Hedra werden keine Monatspläne mehr angezeigt. Es wird pro Ausgabe ein Prepaid-Dollar-Guthaben berechnet: Avatar- und Lippensynchronisationsgenerierung ab 2,5 Cent pro Sekunde, Hochskalierung mit 2,14 Cent pro Sekunde, Bearbeitung mit 7 Cent pro Sekunde und Neubeleuchtung mit 20 Cent pro Sekunde, ohne Abonnement.
Was geschah, als wir eines auf Hedra machten?
Wir begannen mit dem kostenlosen Plan von Hedra, der 100 Credits beinhaltete. Die Erstellung des Startbildes erforderte 7 Credits und dauerte etwa eine halbe Minute. Für den sprechenden Teil haben wir Hedra Avatar ausgewählt, ein sieben Sekunden langes Skript geschrieben und die Standardstimme bei 720p belassen. Auf der Schaltfläche „Generieren“ stand „85 Credits“. Der Restbetrag sank um 40, und das Ergebnis war ein 6 Sekunden langer, 1280 x 720-Clip mit Wasserzeichen, der in etwa zwei Minuten fertig war. Auch die Modellauswahl zeigte, wie stark die Kosten schwanken können: MiniMax H3 Max wurde mit 50 bis 240 Credits pro Generation als bester Wert ausgezeichnet, während Seedance 2.5 mit 84 bis 3.322 Credits als höchste Qualität ausgezeichnet wurde.
Noch etwas fiel auf. Der Ablauf zeigte zu keinem Zeitpunkt ein KI-Offenlegungsetikett, eine Einwilligungsprüfung oder eine Frage, ob wir die Rechte an dem Foto hatten. Das Wasserzeichen war die einzige Markierung. Damit liegt die Verantwortung für die Offenlegung direkt bei Ihnen, was für die unten aufgeführten Regeln von Bedeutung ist.
Das Beste im Vergleich dazu, dass es sich lohnt
Der Schöpfer des obigen Vergleichstests äußerte sich unverblümt: HeyGen hat beim Realismus gewonnen, „er kommt nicht einmal annähernd“, dennoch nutzt er das günstigere Tool häufiger, weil sein Avatar ein Video nur 60 bis 80 Sekunden lang öffnet, bevor die Bildschirmaufnahmen übernehmen. Seine Regel gilt für jedes dieser KI-Videotools . Wenn das Gesicht das Produkt ist, zahlen Sie für die realistischste Option. Wenn das Gesicht eine kurze Einführung ist, ist gut genug gut genug.
Wo sprechende Fotos ihren Lebensunterhalt verdienen und wo nicht
Sprechende Fotos glänzen mit wiederkehrenden Botschaften, die ein Gesicht brauchen, aber kein Filmteam. BIGVU listet Marktaktualisierungen, Auflistungsaktualisierungen, Nachbarschafts-Spotlights, FAQs, Werbeaktionen, interne Ankündigungen und Produkterklärungen als typische Verwendungszwecke auf, und der rote Faden ist die Wiederholung. Sobald Sie ein genehmigtes Porträt haben, können Sie das fünfte Update des Monats erstellen, ohne dafür Zeit zu beanspruchen.
Passt gut
- Kurze Einführungen und wiederkehrende Updates. In der ersten Minute ein bekanntes Gesicht, dann Folien, Demos oder Auflistungsmaterial.
- Video-E-Mail-Marketing. Eine persönliche Begrüßung am Anfang einer Folge-E-Mail fühlt sich herzlicher an als reiner Text. Mit dem Video-E-Mail-Tool von BIGVU können Sie es von demselben Konto aus versenden.
- Inserate ohne Shooting. Immobilienmakler können ein sprechendes Foto-Intro mit Fototale kombinieren, das vorhandene Immobilienfotos in ein Video mit Schwenks, Zooms und Übergängen umwandelt.
Schwache Passform
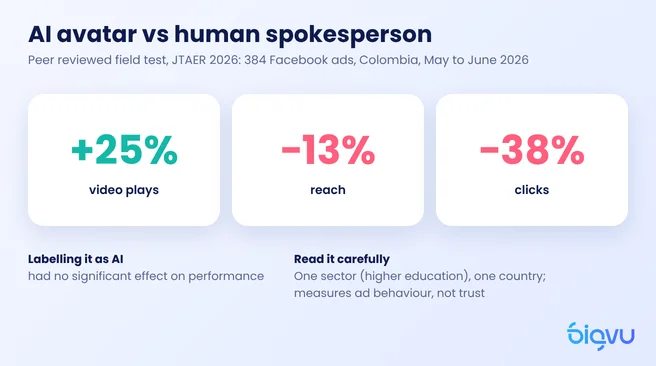
Seien Sie vorsichtig, wenn es um Vertrauen geht. Ein von Experten begutachteter Feldtest mit 384 Facebook-Anzeigen, der 2026 im Journal of Theoretical and Applied Electronic Commerce Research veröffentlicht wurde, ergab, dass ein KI-Avatar 25 % mehr Videowiedergaben erzielte als ein menschlicher Sprecher, aber 13 % weniger Reichweite und 38 % weniger Klicks. Die Studie befasste sich mit Hochschulwerbung in Kolumbien. Behandeln Sie sie daher als einen Datenpunkt und nicht als Gesetz. Dennoch deckt es sich mit dem Ratschlag des zuvor zitierten YouTube-Erstellers: Für Kundenarbeit, eine Sprechermarke oder alles, was ein zahlender Kunde Bild für Bild studieren wird, empfiehlt er das realistischste Tool, das Sie sich leisten können, oder eine echte Aufnahme.
Offenlegung, Einwilligung und die neuen Regeln
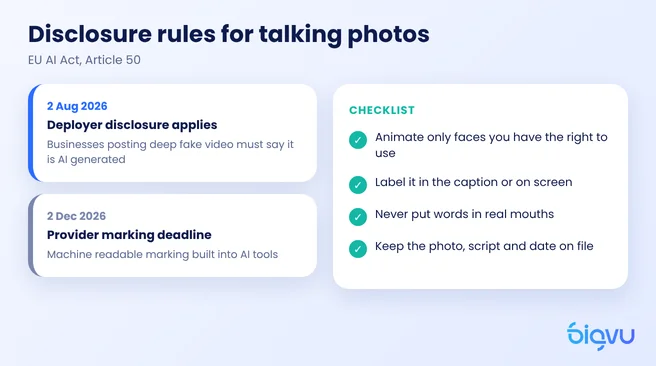
Die Ethik beim Sprechen von Fotos war früher eine Frage guter Manieren. In der Europäischen Union ist es inzwischen auch eine gesetzliche Pflicht. Artikel 50 des EU-KI-Gesetzes besagt, dass jeder, der ein KI-System einsetzt, das Videos erzeugt oder manipuliert, die einen Deep Fake darstellen, „offenlegen muss, dass der Inhalt künstlich erzeugt oder manipuliert wurde“, und dass dies spätestens beim ersten Betrachten klar sein muss. Wie Morgan Lewis erklärte , gelten diese Transparenzpflichten seit dem 2. August 2026. Eine separate viermonatige Übergangsfrist bis zum 2. Dezember betrifft nur die maschinenlesbare Kennzeichnung, die Anbieter einbauen müssen, und verschiebt nicht die Pflichten der Unternehmen, die die Videos veröffentlichen.
Am 10. Juni 2026 veröffentlichte die Europäische Kommission außerdem einen endgültigen Verhaltenskodex zur Kennzeichnung und Kennzeichnung von KI-generierten Inhalten mit einer Reihe vonEU-Symbolen für vollständig KI-generierte und teilweise KI-modifizierte Inhalte. Ein sprechendes Foto einer realen Person ist ein Paradebeispiel für dieses Label.
Eine einfache Checkliste
- Animieren Sie nur Gesichter, zu deren Verwendung Sie berechtigt sind. Ihre eigene oder jemand, der Ihnen ausdrücklich die Erlaubnis gegeben hat. Niemals ein Kunde, ein Konkurrent oder eine Berühmtheit ohne Zustimmung.
- Beschriften Sie es. Eine kurze Zeile in der Bildunterschrift oder auf dem Bildschirm, z. B. „Dieses Video verwendet ein sprechendes KI-Foto“, deckt die Grundgebühr ab und kostet Sie nur sehr wenig.
- Legen Sie keine Worte in echte Münder. Ein sprechendes Foto von dir selbst, wie du dein eigenes Drehbuch liest, ist eine Sache. Jemanden den Eindruck zu erwecken, er unterstütze etwas, was er nie gesagt hat, ist eine andere Sache.
- Führen Sie ein Protokoll. Speichern Sie das Originalfoto, das Drehbuch und das Datum, falls jemand fragt, wie ein Video entstanden ist.
Wird ein Label den Ergebnissen schaden? Die Beweise sind gemischt. Die obige Facebook-Werbestudie ergab, dass die Mitteilung an die Zuschauer, dass eine Anzeige mit KI erstellt wurde, keinen signifikanten Einfluss auf die Leistung hatte. Eine Studie aus dem Jahr 2025 mit 358 Verbrauchern im Journal of Research in Interactive Marketing kam zu dem gegenteiligen Ergebnis: Die Offenlegung verringerte den Wert, den die Leute die Anzeige fanden, und verringerte ihre Kaufabsicht. Unserer Meinung nach ist das Label in der EU ohnehin erforderlich. Die bessere Frage ist also, wie man das Video sehenswert machen kann, sobald die Leute es wissen. Ein echtes Drehbuch, ein echtes Angebot und eine Stimme, die so klingt, als würden Sie einen langen Weg zurücklegen.
Wenn Sie diese lieber nicht selbst produzieren möchten, kann das SuperAgent- Team von BIGVU Ihre monatlichen Videos mit einem TalkingPhoto in Ihrer geklonten Stimme erstellen, mit einem engagierten Strategen, Untertiteln und Miniaturansichten, 8 Videos pro Monat ab 299 $ pro Monat bei monatlicher Abrechnung.