Beginnen Sie beim Zuhörer, nicht bei der Marke
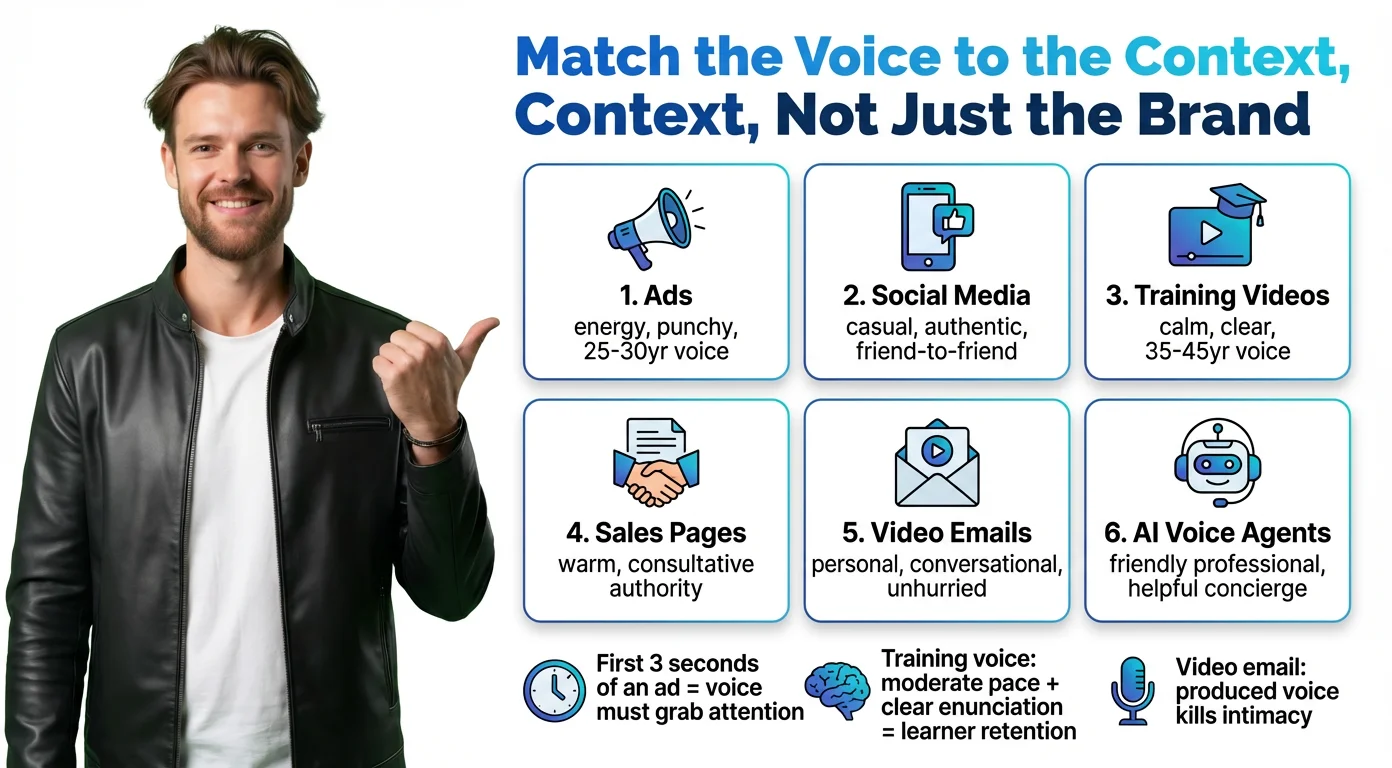
Der erste Fehler: die Stimme wie eine Markenfarbe zu behandeln, also eine zu wählen und überall zu nutzen. Eine Stimme, die auf einer Verkaufsseite Vertrauen schafft, kann in einem Social Clip steif wirken, und eine atemlose Werbestimme ermüdet nach zehn Minuten Schulungsmaterial.
So würde ich die Stimme je nach Einsatz verschieben.
Werbung und Promotion
Sie haben etwa drei Sekunden, um Aufmerksamkeit zu gewinnen, also braucht die Stimme Energie und Vorwärtsdrang. Eine Persona zwischen Mitte 20 und Anfang 30 passt zu Konsumprodukten. Ein tieferer, ruhigerer Ton passt zu B2B oder Premiummarken. Bitten Sie um schwungvolles Tempo und knackigen Vortrag.
Social Media Videos
Social Media belohnt den Eindruck, ein echter Mensch spreche mit einem Freund. Locker, direkt, ein wenig begeistert. Alles, was produziert klingt, bricht den Zauber. Bitten Sie um Gesprächston, Nahbarkeit und natürliches Tempo.
Schulungs und Erklärvideos
Man folgt ihnen länger, daher zählt Klarheit mehr als Persönlichkeit. Ruhig und gelassen, ohne flach zu werden. Eine Persona zwischen Mitte 30 und Mitte 40 vermittelt Autorität ohne Distanz. Bitten Sie um klare Aussprache, mittleres Tempo, warm aber lehrend.
Verkaufs und Landingpages
Hier geht es um Vertrauen. Die Stimme soll wie ein kompetenter Berater klingen, sicher und warm, ohne Druck. Vermeiden Sie alles Gespielte. Bitten Sie um beratenden Ton, weiches Timbre, Autorität im Gesprächston.
Videomails
Der Sinn einer Videomail ist, dass sie persönlich wirkt, und eine überproduzierte Stimme zerstört das in einem Satz. Zielen Sie auf ein Gespräch unter vier Augen: warm, unaufgeregt, mit natürlichen Pausen.
KI Sprachagenten (Website und Video Landingpages)
Diese Stimme ist oft das erste Markenelement, das Besucher hören. Sie sollte freundlich und hilfsbereit sein, weniger Callcenter Skript, mehr kundiger Kollege.
Das Alter verbindet all das. Eine 22 jährige Stimme, die ein Compliance Modul spricht, wirkt falsch, und eine 55 jährige Stimme in einer TikTok Anzeige wirkt abgekoppelt. Es ist einer der am meisten unterschätzten Hebel im Stimmdesign.
Ist das „Menschliche“ für Käufer wirklich wichtig? Eine Studie eines Anbieters legt nahe, dass der Abstand klein ist. Azerion, ein britisches Unternehmen für Audiowerbung, testete im März und April 2026 Spots mit 3.000 Hörern. Nur 29 % derer, die die KI Version hörten, erkannten sie korrekt als künstlich, und 78 % stimmten zu, die KI Stimme klinge natürlich, gegenüber 75 % bei der menschlichen Stimme. Sehen Sie das als Anbieterergebnis für zwei bekannte Marken, nicht als allgemeine Regel. Es zeigt aber, dass Hörer zuerst den Vortrag beurteilen.

Der Aufbau eines Sprachprompts, der wirklich funktioniert
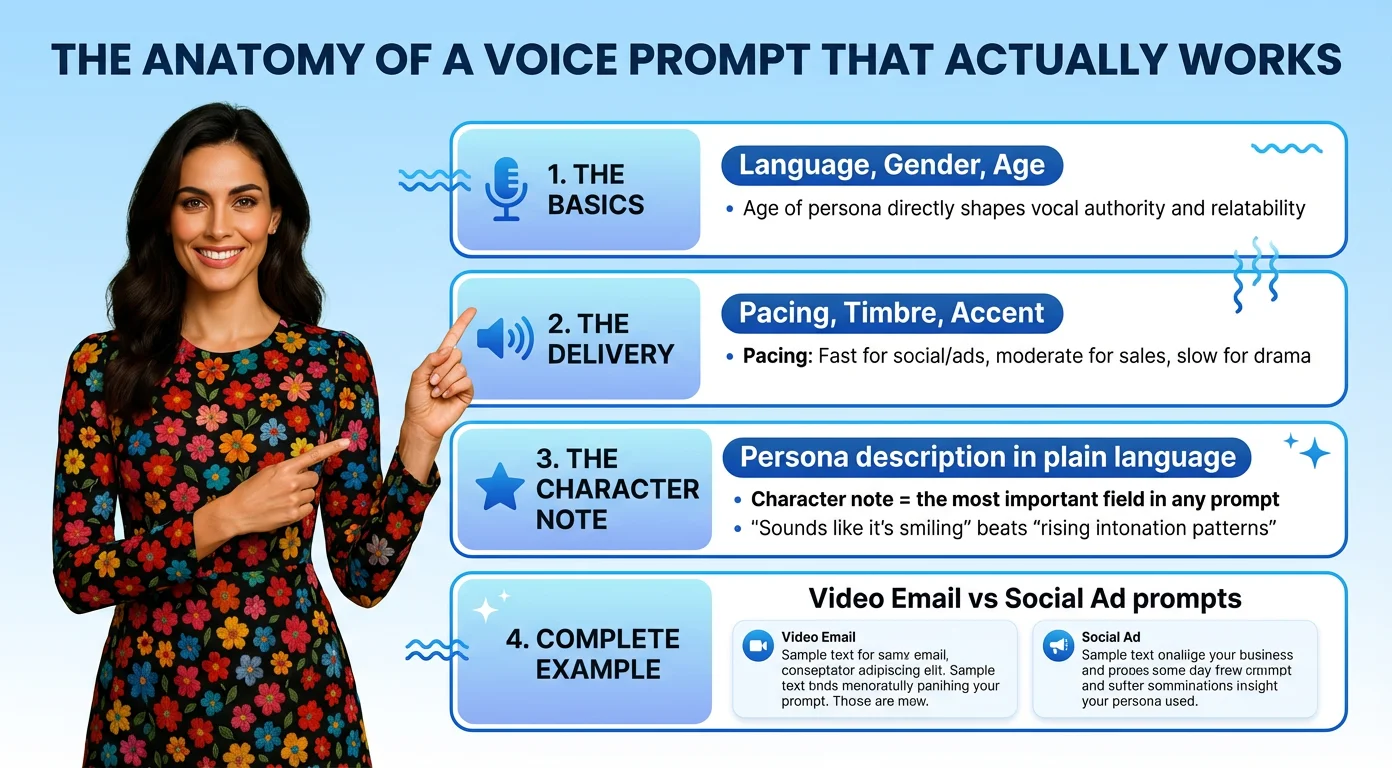
Ein Sprachprompt ist keine Adjektivliste. Er ist eine Figurenbeschreibung, so konkret, dass zwei verschiedene Leser sich dieselbe Sprecherin oder denselben Sprecher vorstellen.
Starke Prompts haben drei Ebenen.
Die Grundlagen: Sprache, Geschlecht und Alter
Sie setzen die äußeren Grenzen. „Frau, Anfang 30, amerikanisches Englisch“ schlägt „Frau“ um Längen. Das Alter prägt Klangqualität, Energie und Autorität, lassen Sie es also nicht vage.
Der Vortrag: Tempo, Timbre und Akzent
Das Tempo steuert die Energie: schnell für Social und Werbung, mittel für Verkauf und Schulung, langsam für Dramatisches. Das Timbre ist die Textur der Stimme: warm, hell, tief, rau, weich. Der Akzent bringt Charakter und Lokalisierung und entscheidet, ob eine Stimme für Ihr Publikum heimisch oder leicht fremd klingt.
Die Charakternotiz: das wichtigste Feld
Hier wird aus einer generischen eine spezifische Stimme. Beschreiben Sie die Person, nicht die Akustik. „Klingt, als würde sie beim Sprechen lächeln“ bringt ein besseres Ergebnis als „steigende Intonationsmuster mit frontaler Nähe“.
Charakternotizen, die oft gut funktionieren:
- Radiostar: hell, energiegeladen, geschliffen. Werbung und Promos.
- Kinoerzähler: tief, bedächtig, dramatisch. Markengeschichten.
- Podcast Host: locker, warm, neugierig. Erklärstücke und Meinungsführerschaft.
- Freundlicher Coach: klar, ermutigend, geduldig. Schulung und Onboarding.
- Nacht DJ: weich, tief, vertraut. Luxus und Atmosphärisches.
- Nachrichtensprecher: prägnant, neutral, autoritativ. Berichte und Meldungen.
Zwei vollständige Beispiele
Für eine Videomail: „Warme, freundliche weibliche Stimme, Anfang 30, amerikanisches Englisch, mittleres Tempo. Gesprächig und nahbar, wie eine Kollegin, die bei einem Kaffee einen nützlichen Tipp teilt. Ein leichtes Lächeln im Vortrag. Professionell, aber nie steif.“
Für eine Social Anzeige: „Energische männliche Stimme, Mitte 20, neutraler amerikanischer Akzent, schnelles Tempo. Selbstbewusst und begeistert, wie jemand, der gerade etwas Tolles entdeckt hat und es kaum erwarten kann, davon zu erzählen. Helles Timbre, knackiger Vortrag.“
Was diese Prompts von einem schwachen unterscheidet, ist nicht die Länge. Sie beschreiben eine Persönlichkeit, nicht nur Parameter.
Wie BIGVU aus einem Prompt in unter 2 Minuten eine Markenstimme macht
Den Prompt zu schreiben ist die strategische Arbeit. Die Stimme zu erzeugen sollte reibungslos gehen, und dafür ist das Voice Design Tool von BIGVU gebaut.
Der Ablauf liegt im Brand Kit unter Branded Media. Er läuft in vier Schritten.
Schritt 1: Parameter festlegen
Wählen Sie Sprache, Akzent, Geschlecht, Tempo, Alter und Timbre in der Voice Design Oberfläche. Das sind Ihre technischen Eingaben, der Rahmen, in dem die KI arbeitet.
Schritt 2: Charakternotiz schreiben
Das ist das Prompt Feld, auf das es ankommt. BIGVU nennt es „zusätzliche Notizen“, aber behandeln Sie es wie ein Casting Briefing. „Radiostar Energie“, „filmisch und langsam aufbauend“, „warm und witzig wie eine Morgenshow Moderatorin“. Schreiben Sie die Figur, nicht die Spezifikation.
Schritt 3: Drei Varianten erzeugen und wählen
BIGVU erzeugt drei verschiedene Interpretationen Ihres Prompts. Hören Sie jede mit einem Beispieltext an, vergleichen Sie die Wirkung und wählen Sie eine. Sie sehen außerdem eine Beschreibung in einfacher Sprache, was erzeugt wurde, sodass Sie wissen, was Sie behalten.
Schritt 4: Benennen und speichern
Geben Sie der Stimme einen Namen (BIGVU kann je nach Sprache und kulturellem Kontext einen vorschlagen), prüfen Sie die Beschreibung und speichern Sie. Die Stimme landet direkt in Ihrer Content Bank, mit KI erzeugten Porträtbildern (Kopf, Oberkörper, ganze Figur), bereit für die Videoproduktion.
Der ganze Vorgang dauert unter zwei Minuten. Kein Casting, kein Studio, kein Sprecher. Die Stimme gehört Ihnen, ist gespeichert und in jedem Ihrer Videos wiederverwendbar.
Derselbe Ablauf gilt in jeder Sprache. Eine warme portugiesische Stimme für Brasilien, eine professionelle japanische Stimme für Tokio, eine schnelle spanische Stimme für Social in Lateinamerika: Ändern Sie Sprache, Akzent und kulturelle Hinweise, und das Ergebnis passt sich an.

Den Vortrag lenken: Audio Tags, Pausen und das Skript selbst
Eine gute Stimme ist die halbe Arbeit. Die andere Hälfte ist, wie die Zeile gesprochen wird, und hier unterscheiden sich die Tools mehr, als ihr Marketing zugibt.
Audio Tags in ElevenLabs v4
ElevenLabs sagt, Eleven v4 und Eleven v3 unterstützen Audio Tags: eine kurze Anweisung in eckigen Klammern, dort platziert, wo sich der Vortrag ändern soll. Das Help Center nennt Beispiele wie [curious], [whispers], [laughs] und [clears throat]. Ein praktisches Detail aus der Dokumentation: Eleven v4 und v3 unterstützen keine SSML Pausen Tags, Pausen entstehen also durch Tags wie [pause] und [long pause] oder durch Zeichensetzung. In einem Beispiel von ElevenLabs selbst dauerte dieselbe kurze Zeile ohne [pause] vier Sekunden und mit [pause] sechs.
Ein Tutorial auf dem offiziellen ElevenLabs Kanal ergänzt einen nützlichen Ablauf. Stapeln Sie Tags in einer Zeile, etwa ein nervöser Einstieg, ein Räuspern, dann ein Flüstern bei einem einzelnen Wort. Bei langen Skripten scannt ein Auto Tag Button den Text und setzt Tags nach Kontext. Treffen Tags immer noch nicht, sprechen Sie die Zeile selbst ein und nutzen Sie Voice Changer, denn „je näher Sie in Ihrer Aufnahme an den gewünschten Vortrag kommen, desto näher kommen Sie im Ergebnis“ (Übersetzung des englischen Zitats).
Anweisungen in normaler Sprache anderswo
Andere Tools gehen einen anderen Weg. Der Text to Speech Leitfaden von OpenAI nutzt ein Anweisungsfeld, mit Beispielen wie „Speak in a cheerful and positive tone.“ Prüfen Sie aber das Datum, bevor Sie darauf aufbauen. Laut OpenAI Dokumentation sind die Modelle tts 1, tts 1 hd und gpt 4o mini tts „veraltet und werden am 6. Januar 2027 abgeschaltet“ (Übersetzung aus dem Englischen). Google sagt, die Gemini 3.8 Sprachausgabe erlaube eigene Regieanweisungen und Hinweise wie |mhm| für gesprächige Textur. Der Octave Leitfaden von Hume nennt einen Punkt, der überall gilt: Nutzen Sie ausdrucksstarken Eingabetext, um ausdrucksstärkere Sprache zu erhalten, und schreiben Sie ein Wort in Großbuchstaben für mehr Betonung.
Das Skript zählt mehr, als Sie denken
Der Creator Isaac, dessen YouTube Video über 735.000 Aufrufe hat, fasst menschlich klingende KI Stimmen in vier Punkten zusammen: Tonwechsel, Pausen, Betonung und ein Skript, das nicht unbearbeitet aus ChatGPT stammt. Außerdem erzeugt er immer nur ein paar Sätze statt des ganzen Skripts. Der Rat funktioniert mit jedem Sprachtool und kostet nichts.
Das ehrliche Gegenargument: Tags sind nicht zuverlässig
Erwarten Sie nicht, dass Tags jedes Mal funktionieren. Die Rezensentin Janine Heinrichs von Unite.AI schrieb im September 2026, „die größte Schwäche war die uneinheitliche Befolgung der Performance Tags“ (Übersetzung aus dem Englischen). Isaac stellte fest, dass v3 Tags bei seinem eigenen Klon „die Stimme selbst leicht verändern“, weshalb er mit geringerer Stabilität zu v2 zurückging. Sein Video stammt aus der Zeit vor v4, die Kritik muss also nicht mehr gelten. Praktische Antwort: wenige Tags, direkt vor den betroffenen Wörtern, und jede Aufnahme anhören.
Noch eine Vorsicht bei Leistungsversprechen. ElevenLabs sagt, Eleven v4 sei von Artificial Analysis auf Platz eins gerankt worden und in Blindtests von etwa 75 % der Hörer bevorzugt worden. Das sind eigene Zahlen von ElevenLabs, und Google erhebt für Gemini 3.8 auf einem anderen Benchmark seinen eigenen Platz eins Anspruch. Testen Sie mit Ihrem eigenen Skript.
Häufige Prompt Fehler, und warum „menschlich“ nicht „versteckt“ heißt
Die meisten verfehlten Stimmen scheitern an denselben wenigen Gründen.
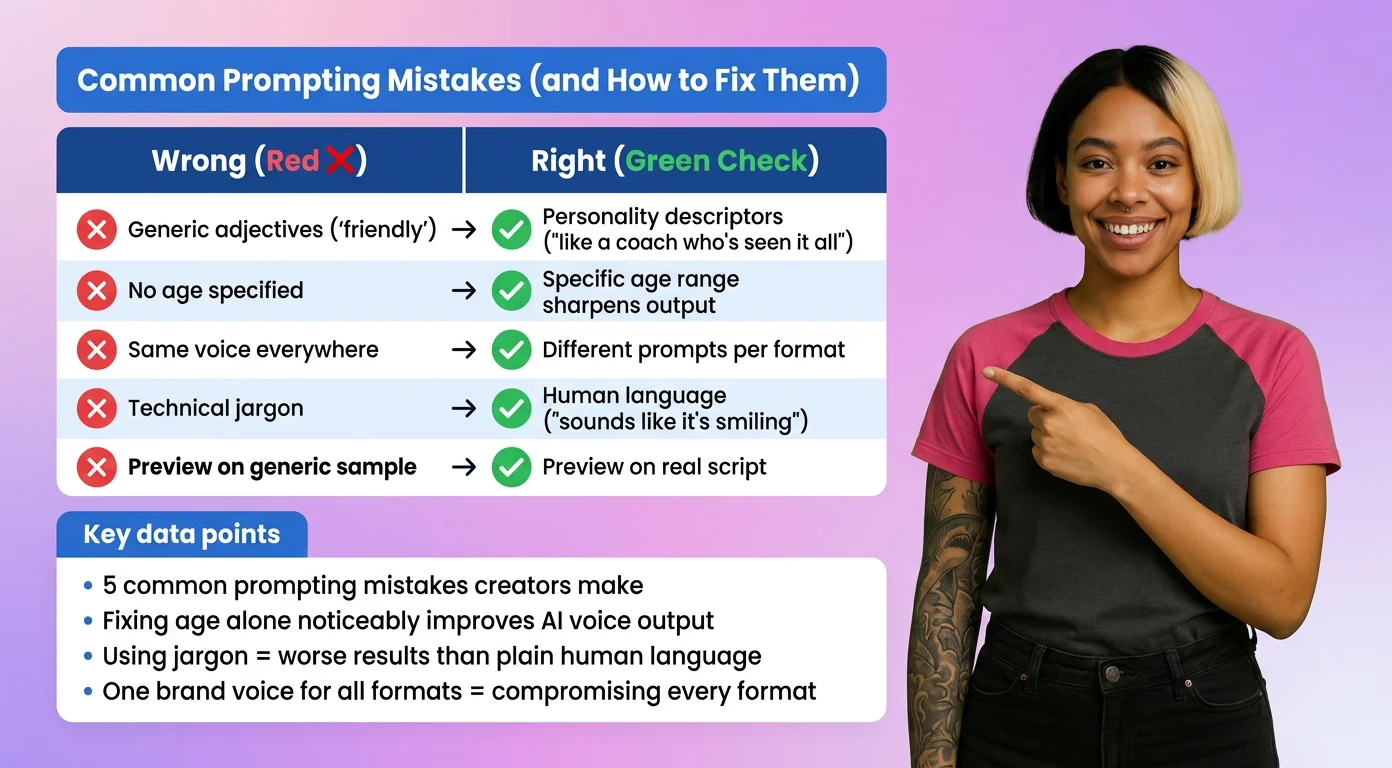
Nur allgemeine Adjektive verwenden
„Professionell“, „freundlich“, „klar“. Jede brauchbare Stimme ist das, also geben diese Wörter der KI fast nichts. Ersetzen Sie sie durch Persönlichkeit: „wie ein erfahrener Coach, der schon alles gesehen hat und sich trotzdem freut zu helfen“.
Das Alter auslassen
Ohne Altersanker landet die Stimme in der Mitte, was meistens in Ordnung und selten großartig ist. Nennen Sie die Spanne, und das Ergebnis wird schärfer.
Dieselbe Stimme überall nutzen
Eine einzige Markenstimme für alle Formate dient keinem davon gut. Ihre Verkaufsseite, Ihre Social Clips und Ihre Onboarding Videos haben unterschiedliche Aufgaben. Geben Sie ihnen unterschiedliche Prompt Varianten.
Fachjargon statt Beschreibung
„Prosodische Variation“ und „Strohbass“ mögen korrekt sein, aber Modelle reagieren besser auf menschliche Sprache. Beschreiben Sie das Hörerlebnis. „Klingt, als würde sie lächeln“ schlägt „erhöhte Tonhöhe mit aufwärts gerichteter Modulation“.
Die Vorschau mit echtem Skript überspringen
Eine Stimme kann bei einem Beispielsatz glänzen und bei Ihrem echten Text durchfallen. Hören Sie ein, zwei Zeilen aus dem Skript an, das sie sprechen soll.
Als Mensch durchgehen wollen
Das ist ebenso eine ethische wie eine praktische Frage. Die Nutzungsrichtlinien von OpenAI „verlangen, dass Sie Endnutzern klar offenlegen, dass die gehörte TTS Stimme KI erzeugt ist“ (Übersetzung aus dem Englischen). Adobes Umfrage von 2026 unter 850 US Verbrauchern ergab, dass 88 % schon eine Stimme gehört und sich gefragt hatten, ob sie von KI stammt, während 77 % menschlichen Stimmen weiterhin am meisten vertrauen. Adobe verkauft KI Audiotools, lesen Sie es also als Anbieterstudie. Die vernünftige Deutung von „menschlich klingen“ ist ein natürlicher, warmer, gut getakteter Vortrag, nicht das Verbergen, dass eine Maschine spricht.
Klone erhöhen den Einsatz. Eine PLOS One Studie von 2025 fand, dass Hörer Stimmklone nicht zuverlässig von echten menschlichen Stimmen unterscheiden konnten, generische KI Stimmen aber erkannten. Die Stichproben waren klein, 50 Teilnehmende pro Experiment, doch die Lehre ist klar: Wenn Ihre Stimme Menschen täuschen kann, sagen Sie es.