
ما الذي يحدث فعلًا عندما تتعلم صورة أن تتكلم
خلف الكواليس، تشغّل معظم أدوات الصور الناطقة بالذكاء الاصطناعي نسخة من العملية نفسها. في نقاش على r/generativeAI، يصفها المستخدمون بمرحلتين: أولًا يمنح نموذج لإعادة تمثيل الوجه الصورة الثابتة حركة طبيعية، ثم يعيد نموذج لمزامنة الشفاه يعمل بالصوت تشكيل الفم ليطابق كل صوت في المسار الصوتي. أكثر الأسماء مفتوحة المصدر تداولًا هي SadTalker وLivePortrait للحركة وWav2Lip للفم، بينما تجمع D-ID وHeyGen خطوات مشابهة في منتج واحد.
لماذا الفم هو الجزء الأصعب
يصف الباحثون الذين طوروا MuseTalk، وهو نموذج لمزامنة الشفاه عُرض في ورقة بحثية على arXiv، المشكلة بأنها معضلة ثلاثية. الطرق القائمة على الانتشار تبدو رائعة لكنها مكلفة في التشغيل. وطرق GAN الأسرع تضحي عادة بدقة الشفاه أو "تفاصيل الأسنان"، وهي طريقة أكاديمية مهذبة للقول إن الأسنان تصبح ضبابية. يعمل MuseTalk في فضاء كامن مضغوط ليجمع بين السرعة والتفاصيل، ويذكر أنه يحقق 30 إطارًا في الثانية بدقة 256 في 256 بكسل على بطاقة رسومات واحدة من نوع NVIDIA V100.
رقم الدقة هذا يستحق التذكر. فالنموذج يعيد رسم منطقة صغيرة حول الفم فقط، ثم يدمجها مجددًا في صورتك بحجمها الكامل. وعندما يكون الوجه صغيرًا أو ملتفتًا جانبًا أو ضعيف الإضاءة، تقل التفاصيل الحقيقية المتاحة، وهنا عادة ما ينهار الإيهام.
ما الذي يجب ملاحظته عند التقييم
يقدم صانع محتوى قارن HeyGen بأداة أرخص في اختبار مقارنة مباشر على YouTube قائمة مفيدة: راقب زوايا الفم، ولاحظ ما يفعله الرأس عند انتهاء الجملة، واستمع إلى الحروف الساكنة القوية مثل P وB، لأن هناك "تنهار أدوات مزامنة الشفاه الأرخص تمامًا عادة".
الصورة التي ترفعها تحدد معظم النتيجة
لا تستطيع أي منصة أن تحرك إلا ما هو موجود في الصورة، لذا تستحق الصورة الأصلية اهتمامًا أكبر من الإعدادات. ونصائح من يصنعون هذه الفيديوهات كل أسبوع متشابهة جدًا.
- انظر مباشرة إلى الكاميرا. يوصي درس تعليمي من Hedra في فبراير 2026 بصورة حادة، والوجه متجه مباشرة نحو العدسة، مع إضاءة جيدة، ويستبعد الصور الجانبية والصور الضبابية. ويشير أيضًا إلى أن Hedra ترفض الصور الأصغر من 300 بكسل.
- ابدأ بتعبير محايد. يقترح الدرس نفسه تعبيرًا محايدًا إذا بدت النتيجة متصلبة، مع إضاءة أفضل وصوت نظيف، لأن الصوت الواضح "يحسن دقة مزامنة الشفاه".
- اجعل المقاطع قصيرة. يقول الدرس: "المقاطع الأقصر تبدو أكثر واقعية". قسّم النص الطويل إلى عدة فيديوهات قصيرة بدلًا من لقطة طويلة واحدة.
- خفف الحركة. أضافت صانعة محتوى أنشأت أفاتار من صورة واحدة في درسها التعليمي عن HeyGen أمر حركة مخصصًا يطلب مظهرًا طبيعيًا وظهورًا بسيطًا للأسنان ومن دون يدين، لأن الإعدادات الافتراضية قد تجعل الشخصية مبالغة في التعبير.
- قدّم أكثر من صورة إن أمكن. توصي HeyGen برفع بضع صور إضافية لك حتى يلتقط النموذج مزيدًا من التفاصيل.
الصوت مهم بقدر أهمية الوجه. المسار الصوتي الرتيب والمستعجل يجعل حتى الفم المثالي يبدو غير مقنع. اكتب النص ليُقال بصوت عالٍ، واقرأه مرة واحدة بصوت مسموع، واحذف كل جملة تتعثر فيها قبل أن تنتج أي شيء.
BIGVU وHeyGen وHedra: ما الذي يقدمه كل منها
تحول الأدوات الثلاث الصورة إلى أفاتار يتكلم، لكنها صُممت لفئات مختلفة من المشترين. إليك ما يعرضه كل مزود على صفحاته اليوم.
BIGVU AI Talking Photo
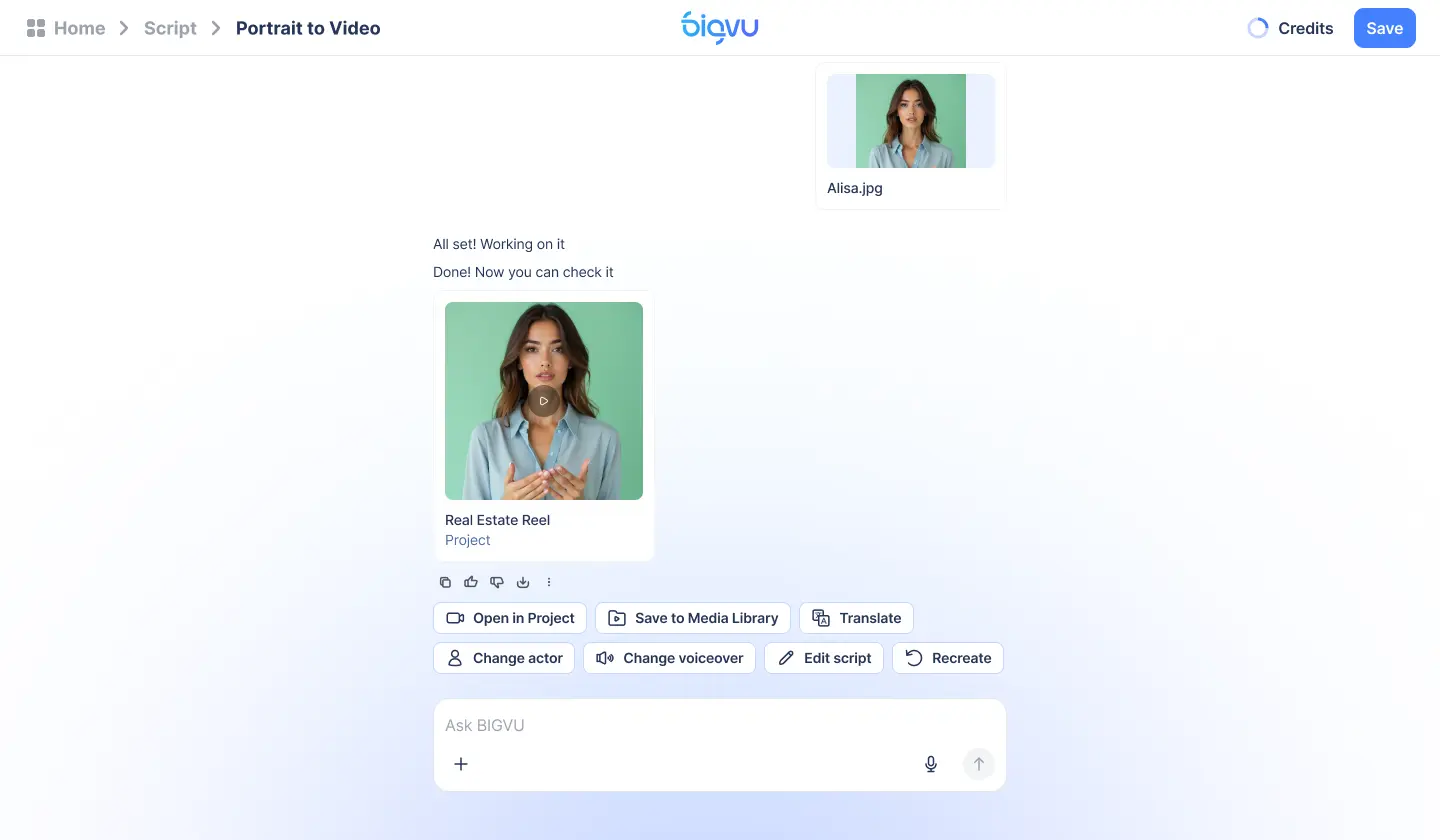
تعمل أداة AI Talking Photo من BIGVU في ثلاث خطوات: ارفع صورة شخصية، وأضف نصًا وصوتًا، ثم أنشئ الفيديو وانشره. يمكنك كتابة النص بنفسك أو صياغة مسودة باستخدام AI Script Generator، ثم اختيار صوت من مكتبة BIGVU أو استنساخ صوتك. يبقى الفيديو المتزامن داخل التطبيق نفسه لإضافة الترجمة وهوية علامتك التجارية والنشر، ويمكنك العمل من الويب أو iPhone أو Android. تستهلك ميزات الذكاء الاصطناعي أرصدة شهرية، وتحوّل صفحة الأسعار هذه الأرصدة إلى مدة فيديو: 500 رصيد في الخطة المجانية تكفي لفيديو عمودي مدته نحو 10 ثوانٍ، و3000 رصيد في AI Pro تكفي لنحو دقيقة.
HeyGen Photo Avatar
تروّج صفحة أفاتار الصور من HeyGen لصور ناطقة بأكثر من 175 لغة ولهجة، وأوامر نصية وحزم أنماط تغير ملابسك أو خلفيتك، ومحرك Avatar IV الذي يحول صورة واحدة إلى فيديو بصوت متزامن وإيماءات يد. وعلى صفحة الأسعار، تمنح الخطة المجانية 3 فيديوهات شهريًا بعلامة مائية وبحد أقصى دقيقة واحدة للفيديو، وتكلف Creator مبلغ 29 دولارًا شهريًا مع 600 رصيد، وPro مبلغ 49 دولارًا شهريًا مع 1000 رصيد وفيديوهات تصل إلى 30 دقيقة.
Hedra
تسعير Hedra هو الأكثر تفصيلًا بين الثلاثة. عبر API، يبدأ إنشاء الأفاتار ومزامنة الشفاه من 2.5 سنت للثانية من رصيد مدفوع مسبقًا بالدولار، من دون اشتراك، واستنساخ الصوت مجاني. وإذا كنت تفضل تطبيق Studio، فالخطط تتراوح بين Basic بسعر 20 دولارًا شهريًا مقابل 2000 رصيد، وPro بسعر 50 دولارًا مقابل 7200 رصيد، وUltra بسعر 100 دولار مقابل 18000 رصيد.
الأفضل أم الأجدى
صانع المحتوى صاحب اختبار المقارنة صريح: HeyGen تتفوق في الواقعية، "ولا مجال للمقارنة أصلًا"، ومع ذلك يستخدم الأداة الأرخص أكثر، لأن الأفاتار عنده يفتتح الفيديو فقط لمدة 60 إلى 80 ثانية قبل أن تتولى تسجيلات الشاشة المهمة. وقاعدته تنطبق على أي أداة فيديو بالذكاء الاصطناعي. إذا كان الوجه هو المنتج، فادفع مقابل الخيار الأكثر واقعية. وإذا كان الوجه مجرد مقدمة قصيرة، فالجيد بما يكفي يكفي.
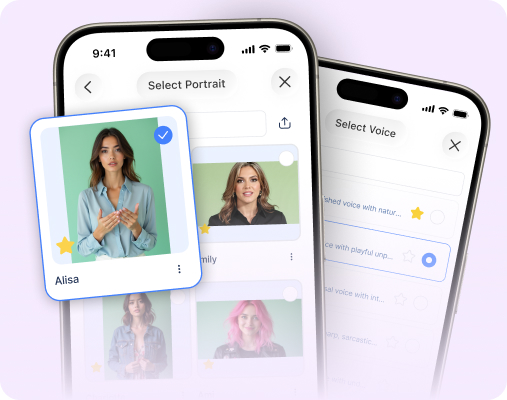
أين تستحق الصور الناطقة مكانها، وأين لا
تتألق الصور الناطقة في الرسائل المتكررة التي تحتاج إلى وجه لكنها لا تحتاج إلى فريق تصوير. تذكر BIGVU تحديثات السوق، وتحديثات العقارات المعروضة، والتعريف بالأحياء، والأسئلة الشائعة، والعروض الترويجية، والإعلانات الداخلية، وشرح المنتجات بوصفها استخدامات شائعة، والقاسم المشترك هو التكرار. بصورة شخصية واحدة معتمدة، يمكنك إنتاج التحديث الخامس هذا الشهر من دون حجز وقت أي شخص.
استخدامات مناسبة
- مقدمات قصيرة وتحديثات دورية. وجه مألوف في الدقيقة الأولى، ثم شرائح أو عرض توضيحي أو لقطات للعقار.
- التسويق عبر البريد الإلكتروني بالفيديو. تحية شخصية في بداية رسالة متابعة تبدو أدفأ من النص وحده. وتتيح لك أداة الفيديو عبر البريد من BIGVU إرسالها من الحساب نفسه.
- عقارات من دون جلسة تصوير. يمكن لوكلاء العقارات الجمع بين مقدمة بصورة ناطقة وFototale، الذي يحول صور العقار الموجودة إلى فيديو بحركات تحريك وتكبير وانتقالات.
استخدامات ضعيفة
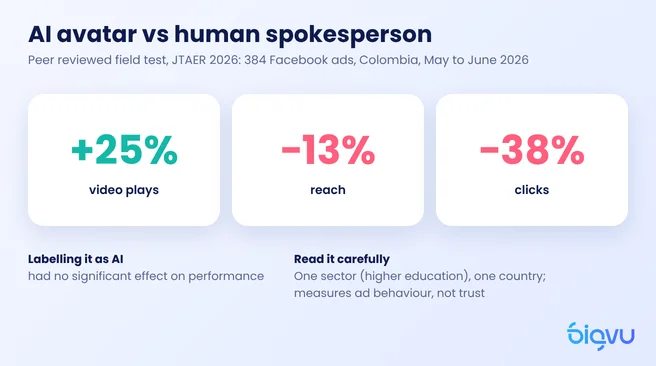
كن حذرًا حيث تكون الثقة هي كل شيء. وجدت تجربة ميدانية محكّمة شملت 384 إعلانًا على Facebook، ونُشرت في 2026 في Journal of Theoretical and Applied Electronic Commerce Research، أن أفاتارات الذكاء الاصطناعي حصلت على مشاهدات فيديو أكثر بنسبة 25% من المتحدث البشري، لكن وصولها كان أقل بنسبة 13% ونقراتها أقل بنسبة 38%. درست الدراسة إعلانات للتعليم العالي في كولومبيا، فاعتبرها نقطة بيانات واحدة لا قانونًا. ومع ذلك، تتفق مع نصيحة صانع المحتوى على YouTube المذكور سابقًا: لأعمال العملاء، أو لعلامة تجارية بوجه ثابت، أو لأي شيء سيفحصه عملاء يدفعون إطارًا بإطار، يوصي بأكثر أداة واقعية تستطيع تحمل تكلفتها، أو بالتصوير الحقيقي.
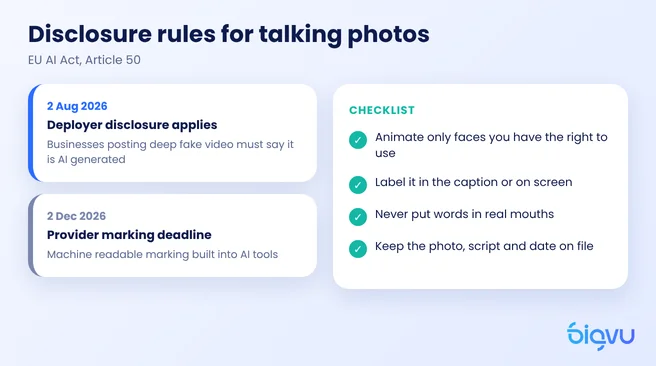
الإفصاح والموافقة والقواعد الجديدة
كانت أخلاقيات الصور الناطقة في الماضي مسألة لياقة. أما في الاتحاد الأوروبي فقد أصبحت الآن التزامًا قانونيًا أيضًا. تنص المادة 50 من قانون الذكاء الاصطناعي الأوروبي على أن من يستخدم نظام ذكاء اصطناعي ينتج أو يعدّل فيديو يشكل تزييفًا عميقًا ملزم بالإفصاح عن أن المحتوى أُنشئ أو عُدّل بشكل اصطناعي، وأن يكون ذلك واضحًا في موعد أقصاه لحظة رؤية المشاهد له لأول مرة. وكما يوضح Morgan Lewis، بدأ تطبيق التزامات الشفافية هذه في 2 أغسطس 2026. أما فترة الانتقال المنفصلة البالغة أربعة أشهر، حتى 2 ديسمبر، فتغطي فقط العلامات القابلة للقراءة آليًا التي يجب على المزودين بناؤها، ولا تؤجل التزام الشركات التي تنشر الفيديوهات.
قائمة تحقق بسيطة
- لا تحرك إلا الوجوه التي يحق لك استخدامها. وجهك أنت، أو وجه شخص منحك إذنًا صريحًا. ولا تستخدم أبدًا وجه عميل أو منافس أو شخصية مشهورة من دون موافقة.
- ضع علامة توضيحية. سطر قصير في التعليق أو على الشاشة، مثل "يستخدم هذا الفيديو صورة ناطقة بالذكاء الاصطناعي"، يفي بالالتزام الأساسي ولا يكلف شيئًا تقريبًا.
- لا تضع كلمات على لسان شخص حقيقي. صورة ناطقة لك تقرأ نصك أمر، وجعل شخص ما يبدو وكأنه يؤيد شيئًا لم يقله قط أمر مختلف تمامًا.
- احتفظ بسجلات. احفظ الصورة الأصلية والنص والتاريخ، تحسبًا لأن يسأل أحد كيف صُنع الفيديو.
إذا كنت تخشى أن تضر العلامة بالنتائج، فإن دراسة إعلانات Facebook نفسها مطمئنة: إخبار المشاهدين بأن الإعلان صُنع بالذكاء الاصطناعي لم يكن له تأثير ملحوظ على الأداء. هنا، الصدق لا يكلف شيئًا.