ابدأ من المستمع لا من العلامة التجارية
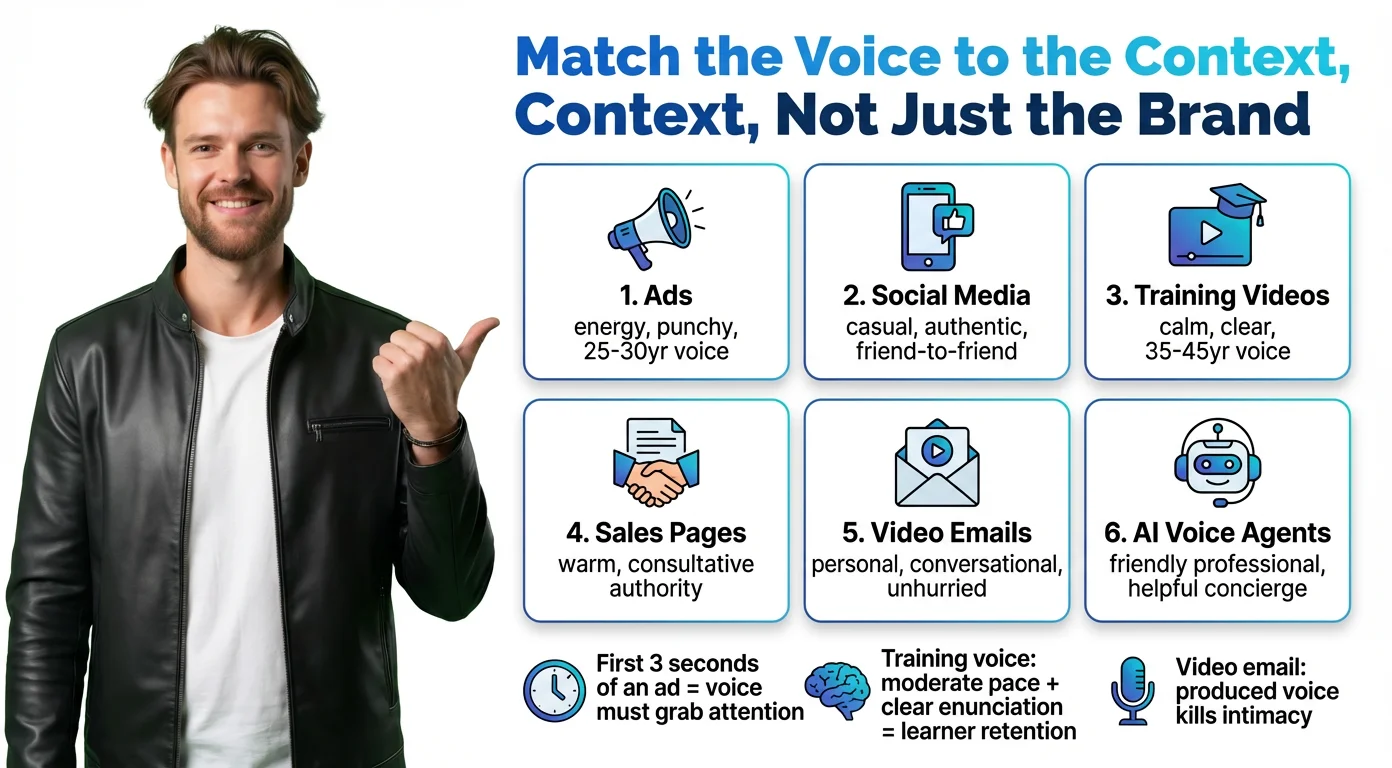
الخطأ الأول هو التعامل مع الصوت كأنه لون للعلامة التجارية: تختار واحدًا وتستخدمه في كل مكان. الصوت الذي يبني الثقة في صفحة المبيعات قد يبدو جامدًا في مقطع على وسائل التواصل، والصوت الإعلاني اللاهث يصبح مرهقًا بعد عشر دقائق من مادة التدريب.
هكذا أغيّر الصوت بحسب الاستخدام.
الإعلانات والمحتوى الترويجي
أمامك نحو ثلاث ثوانٍ لكسب الانتباه، لذا يحتاج الصوت إلى طاقة وزخم. شخصية في منتصف العشرينات إلى مطلع الثلاثينات تناسب منتجات المستهلكين. ونبرة أعمق وأكثر ثباتًا تناسب B2B أو العلامات الفاخرة. اطلب إيقاعًا حيويًا وأداءً حاسمًا.
فيديوهات وسائل التواصل الاجتماعي
وسائل التواصل تكافئ الإحساس بأن شخصًا حقيقيًا يتحدث إلى صديق. عفوي ومباشر ومتحمس قليلًا. وكل ما يبدو مُنتَجًا يكسر السحر. اطلب نبرة حوارية قريبة وإيقاعًا طبيعيًا.
فيديوهات التدريب والشرح
يتابعها الناس لفترات أطول، لذا الوضوح أهم من الشخصية. هادئ ومتزن دون أن يصبح رتيبًا. شخصية من منتصف الثلاثينات إلى منتصف الأربعينات تمنح سلطة دون مسافة. اطلب نطقًا واضحًا وإيقاعًا معتدلًا ودفئًا تعليميًا.
صفحات المبيعات وصفحات الهبوط
المهمة هنا بناء الثقة. يجب أن يبدو الصوت كمستشار خبير، واثق ودافئ، دون ضغط. تجنّب كل ما يبدو تمثيلًا. اطلب نبرة استشارية وطبقة ناعمة وسلطة حوارية.
رسائل البريد بالفيديو
جوهر رسالة الفيديو أنها تبدو شخصية، والصوت المبالغ في إنتاجه يهدم ذلك في جملة واحدة. استهدف حديثًا فرديًا: دافئًا وغير مستعجل وبوقفات طبيعية.
وكلاء الصوت بالذكاء الاصطناعي (الموقع وصفحات الهبوط بالفيديو)
غالبًا ما يكون هذا الصوت أول ما يسمعه الزائر من علامتك. يجب أن يكون ودودًا ومفيدًا: أقل شبهًا بنص مركز اتصال، وأكثر شبهًا بزميل خبير.
العمر يربط هذا كله. صوت في الثانية والعشرين يروي وحدة امتثال يبدو في غير مكانه، وصوت في الخامسة والخمسين في إعلان على تيك توك يبدو منفصلًا. إنه من أقل الرافعات استغلالًا في تصميم الصوت.
هل يهم الجانب "البشري" فعلًا للمشترين؟ دراسة من أحد الموردين تشير إلى أن الفارق صغير. أجرت Azerion، وهي شركة بريطانية للإعلان الصوتي، اختبارًا على 3000 مستمع في مارس وأبريل 2026. لم يصف الصوت المُولَّد بأنه اصطناعي بشكل صحيح سوى 29% ممن سمعوا نسخة الذكاء الاصطناعي، وقال 78% إن الصوت يبدو طبيعيًا مقابل 75% للصوت البشري. اعتبر هذا نتيجة من مورّد لعلامتين معروفتين، لا قاعدة عامة. ومع ذلك يدل على أن المستمعين يحكمون على الأداء أولًا.

تشريح الموجّه الصوتي الذي ينجح فعلًا
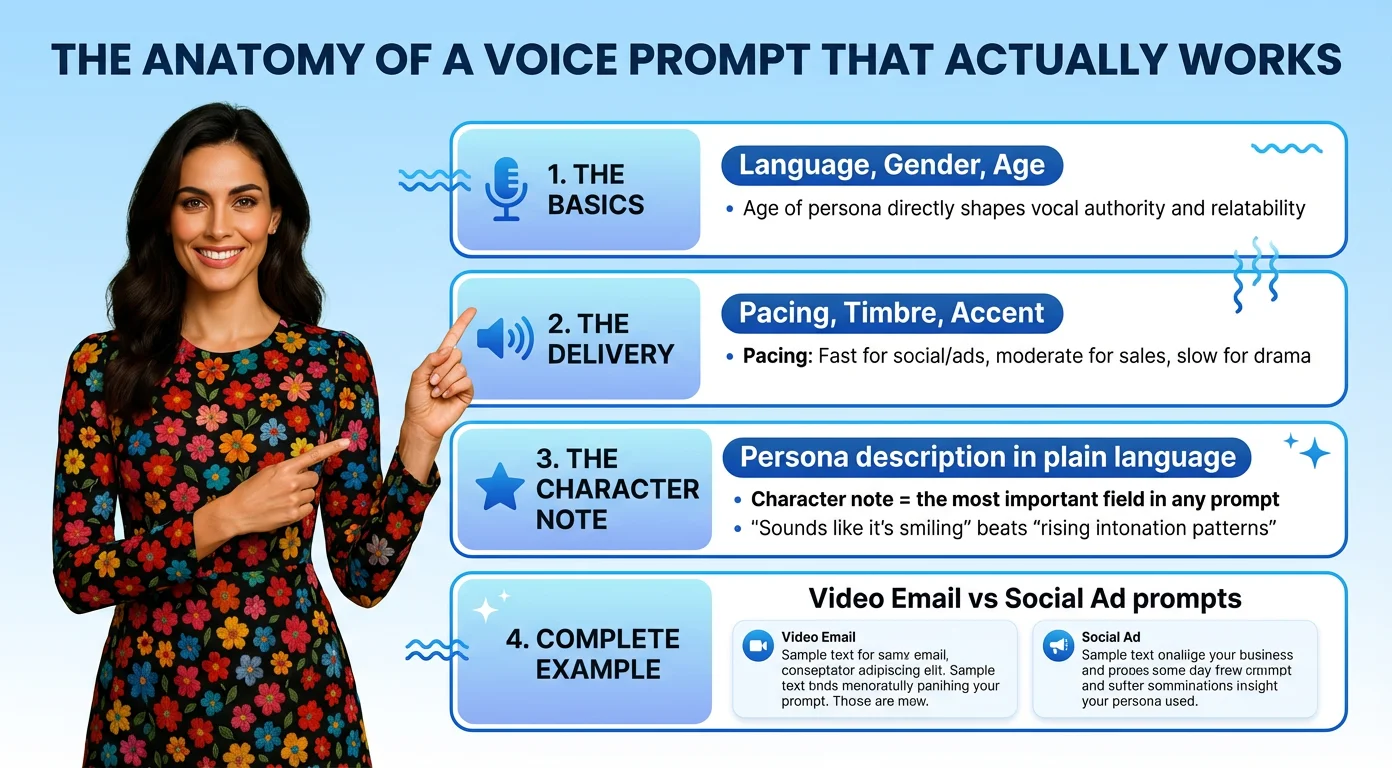
الموجّه الصوتي ليس قائمة صفات. إنه وصف لشخصية، محدد بما يكفي ليتخيل قارئان مختلفان المتحدث نفسه.
للموجّهات القوية ثلاث طبقات.
الأساسيات: اللغة والجنس والعمر
هذه تحدد الحدود الخارجية. "امرأة في مطلع الثلاثينات بالإنجليزية الأمريكية" أفضل كثيرًا من "امرأة". العمر يشكّل جودة الصوت والطاقة والسلطة، فلا تتركه غامضًا.
الأداء: الإيقاع والطبقة واللهجة
الإيقاع يتحكم في الطاقة: سريع لوسائل التواصل والإعلانات، معتدل للمبيعات والتدريب، بطيء للدراما. الطبقة هي ملمس الصوت: دافئ ساطع عميق خشن ناعم. واللهجة تضيف طابعًا وتوطينًا، وقد تحدد هل يبدو الصوت محليًا لجمهورك أم غريبًا قليلًا.
ملاحظة الشخصية: أهم حقل
هنا ينتقل الصوت من العام إلى المحدد. صِف الشخص لا الصوتيات. "يبدو كأنها تبتسم وهي تحدثك" يعطي نتيجة أفضل من "أنماط تنغيم صاعد مع قرب أمامي".
ملاحظات شخصية تعمل غالبًا:
- نجم الراديو: ساطع، عالي الطاقة، مصقول. للإعلانات والترويج.
- الراوي السينمائي: عميق، متأنٍ، درامي. لقصص العلامة.
- مقدم البودكاست: عفوي، دافئ، فضولي. للشروحات وقيادة الرأي.
- المدرب الودود: واضح، مشجع، صبور. للتدريب والتأهيل.
- مذيع الليل: ناعم، منخفض، حميم. للفخامة والمحتوى الأجوائي.
- مذيع الأخبار: حاد، محايد، ذو سلطة. للتقارير والتحديثات.
مثالان كاملان
لرسالة بريد بالفيديو: "صوت أنثوي دافئ وودود، في مطلع الثلاثينات، بالإنجليزية الأمريكية، بإيقاع معتدل. حواري ومقرّب، كزميلة تشارك نصيحة مفيدة على فنجان قهوة. ابتسامة خفيفة في الأداء. مهنية دون أن تكون جامدة."
لإعلان على وسائل التواصل: "صوت ذكوري نشيط، في منتصف العشرينات، بلكنة أمريكية محايدة، بإيقاع سريع. واثق ومتحمس، كمن اكتشف للتو شيئًا رائعًا ولا يطيق صبرًا ليخبرك به. طبقة ساطعة وأداء حاسم."
ما يميز هذه الموجّهات عن موجّه ضعيف ليس الطول. إنها تصف شخصية، لا مجرد معاملات.
كيف تحوّل BIGVU الموجّه إلى صوت لعلامتك في أقل من دقيقتين
كتابة الموجّه هي العمل الاستراتيجي. أما توليد الصوت فيجب أن يكون سلسًا، ولهذا بُنيت أداة Voice Design من BIGVU.
يقع سير العمل داخل Brand Kit تحت Branded Media. ويجري في أربع خطوات.
الخطوة 1: اضبط المعاملات
اختر اللغة واللهجة والجنس والإيقاع والعمر والطبقة في واجهة Voice Design. هذه مدخلاتك التقنية، الإطار الذي يعمل الذكاء الاصطناعي داخله.
الخطوة 2: اكتب ملاحظة الشخصية
هذا هو حقل الموجّه الذي يهم. تسميه BIGVU "ملاحظات إضافية"، لكن تعامل معه كملخص اختيار ممثل. "طاقة نجم راديو"، "سينمائي وبطيء الاشتعال"، "دافئ وظريف كمقدم برنامج صباحي". اكتب الشخصية لا المواصفات.
الخطوة 3: ولّد ثلاث نسخ واختر
تنتج BIGVU ثلاث تفسيرات مختلفة لموجّهك. استمع إلى كل واحد بنص تجريبي وقارن وقعه واختر واحدًا. وترى أيضًا وصفًا بلغة بسيطة لما تم توليده، فتعرف ما تحتفظ به.
الخطوة 4: سمِّ واحفظ
امنح الصوت اسمًا (يمكن لـ BIGVU اقتراح اسم بحسب اللغة والسياق الثقافي)، وراجع الوصف واحفظ. يُضاف الصوت مباشرة إلى Content Bank الخاص بك مع صور شخصية مولّدة بالذكاء الاصطناعي (وجه ونصف جسم وجسم كامل) جاهزة لإنتاج الفيديو.
تستغرق العملية كلها أقل من دقيقتين. بلا اختيار ممثلين ولا استوديو ولا ممثل صوتي. الصوت لك، محفوظ وقابل لإعادة الاستخدام في كل فيديو.
سير العمل نفسه ينطبق على كل لغة. صوت برتغالي دافئ للبرازيل، صوت ياباني محترف لطوكيو، صوت إسباني سريع لوسائل التواصل في أمريكا اللاتينية: غيّر اللغة واللهجة والملاحظات الثقافية فيتكيف الناتج.

توجيه الأداء: وسوم الصوت والوقفات والنص نفسه
الصوت الجيد نصف العمل. والنصف الآخر هو كيف تُقال الجملة، وهنا تختلف الأدوات أكثر مما يعترف به تسويقها.
وسوم الصوت في ElevenLabs v4
تقول ElevenLabs إن Eleven v4 وEleven v3 يدعمان وسوم الصوت: تعليمة قصيرة بين أقواس مربعة توضع حيث يجب أن يتغير الأداء. ويسرد مركز المساعدة لديها أمثلة مثل [curious] و[whispers] و[laughs] و[clears throat]. وهناك تفصيل عملي من وثائقها: Eleven v4 وv3 لا يدعمان وسوم التوقف SSML، لذا تأتي الوقفات من وسوم مثل [pause] و[long pause] أو من علامات الترقيم. وفي مثال من ElevenLabs نفسها، استغرق السطر القصير ذاته أربع ثوانٍ دون وسم [pause] وست ثوانٍ معه.
يضيف شرح على القناة الرسمية لـ ElevenLabs أسلوب عمل مفيدًا. كدّس الوسوم في سطر واحد، مثل بداية متوترة ثم تنحنح ثم همس على كلمة واحدة. وفي النصوص الطويلة، يفحص زر Auto tag النص ويضيف وسومًا بحسب السياق. وإذا ظلت الوسوم تخطئ، سجّل السطر بنفسك واستخدم Voice Changer، لأنه "كلما اقتربت في تسجيلك من الأداء الذي تريده، اقتربت من الناتج" (ترجمة للاقتباس الإنجليزي).
تعليمات بلغة عادية في أدوات أخرى
تسلك أدوات أخرى طريقًا مختلفًا. يستخدم دليل OpenAI لتحويل النص إلى كلام حقل تعليمات، بأمثلة مثل "Speak in a cheerful and positive tone." لكن تحقق من التاريخ قبل أن تبني عليه. تقول وثائق OpenAI إن النماذج tts 1 وtts 1 hd وgpt 4o mini tts "مهجورة وسيتم إيقافها في 6 يناير 2027" (ترجمة من الإنجليزية). وتقول Google إن تحويل النص إلى كلام في Gemini 3.8 يتيح كتابة إرشاداتك المسرحية وإضافة إشارات مثل |mhm| لملمس حواري. وينبه دليل Octave من Hume إلى مبدأ ينطبق في كل مكان: استخدم نص إدخال معبرًا لتحصل على كلام أكثر تعبيرًا، واكتب كلمة بأحرف كبيرة لتأكيد أقوى.
النص أهم مما تظن
يختزل المبدع Isaac، الذي تجاوزت مشاهدات فيديو يوتيوب لديه 735000، الصوت البشري بالذكاء الاصطناعي في أربعة أمور: تغيّر النبرة والوقفات والتأكيد ونص لم يُنسخ مباشرة من ChatGPT. كما يولّد بضع جمل في كل مرة بدل النص كله. إنها نصيحة تصلح مع أي أداة صوتية ولا تكلف شيئًا.
المقابل الصادق: الوسوم ليست موثوقة
لا تتوقع أن تلتزم الوسوم في كل مرة. كتبت المراجِعة Janine Heinrichs من Unite.AI في سبتمبر 2026 أن "أكبر نقاط الضعف كانت الالتزام غير المتسق بوسوم الأداء" (ترجمة من الإنجليزية). وجد Isaac أن إضافة وسوم v3 إلى نسخته الصوتية تعني "أنه يغيّر الصوت نفسه قليلًا"، فعاد إلى v2 بثبات أقل. فيديوه سابق لـ v4، فقد لا تنطبق تلك الشكوى الآن. الجواب العملي: استخدم وسومًا قليلة، وضعها قبل الكلمات التي تؤثر فيها مباشرة، واستمع إلى كل تسجيل.
تحذير آخر بشأن ادعاءات الأداء. تقول ElevenLabs إن Eleven v4 صُنّف الأول بحسب Artificial Analysis وفضّله نحو 75% من المستمعين في اختبارات عمياء. هذه أرقام ElevenLabs نفسها، وتقدم Google ادعاءها الخاص بالمركز الأول لـ Gemini 3.8 على معيار مختلف. اختبر بنصك أنت.
أخطاء شائعة في كتابة الموجّهات، ولماذا لا يعني البشري المخفي
معظم الأصوات التي تخطئ الهدف تفشل لنفس الأسباب القليلة.
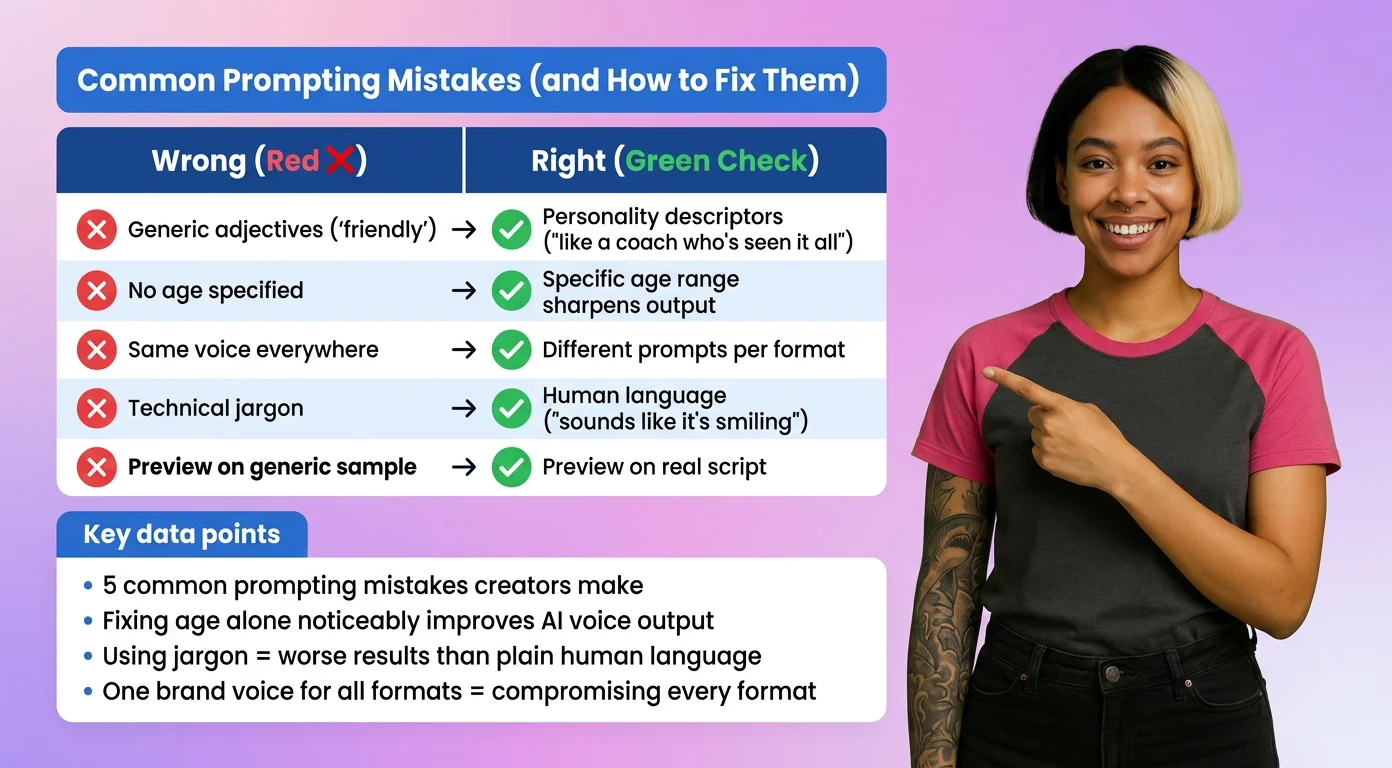
استخدام صفات عامة فقط
"محترف" و"ودود" و"واضح". كل صوت جيد كذلك، فلا تمنح هذه الكلمات الذكاء الاصطناعي شيئًا تقريبًا. استبدلها بالشخصية: "كمدرب متمرس رأى كل شيء لكنه ما زال متحمسًا للمساعدة".
تجاهل العمر
بدون مرساة للعمر يستقر الصوت في المنتصف، وهو عادة مقبول وقلما يكون ممتازًا. حدد النطاق وسيزداد الناتج حدة.
استخدام الصوت نفسه في كل مكان
صوت واحد للعلامة في كل الصيغ لا يخدم أيًا منها جيدًا. صفحة المبيعات ومقاطع التواصل وفيديوهات التأهيل لها مهام مختلفة. امنحها نسخًا مختلفة من الموجّه.
كتابة مصطلحات تقنية بدل الوصف
"التنوع العروضي" و"vocal fry" قد تكون دقيقة، لكن النماذج تستجيب أفضل للغة البشر. صِف تجربة الاستماع. "يبدو كأنها تبتسم" يتفوق على "طبقة مرتفعة مع تضمين صاعد".
تخطي المعاينة بالنص الحقيقي
قد يتألق الصوت في جملة تجريبية ويخفق في نصك الفعلي. استمع إلى سطر أو سطرين من النص الذي سيرويه.
محاولة التظاهر بأنه شخص
هذا أخلاقي بقدر ما هو عملي. تنص سياسات الاستخدام لدى OpenAI على أنها "تتطلب منك إفصاحًا واضحًا للمستخدمين النهائيين بأن صوت TTS الذي يسمعونه مولَّد بالذكاء الاصطناعي" (ترجمة من الإنجليزية). ووجد استطلاع Adobe لعام 2026 على 850 مستهلكًا أمريكيًا أن 88% سمعوا صوتًا وتساءلوا هل هو ذكاء اصطناعي، بينما لا يزال 77% يثقون بالأصوات البشرية أكثر. تبيع Adobe أدوات صوت بالذكاء الاصطناعي، فاقرأ هذا كدراسة من مورّد. القراءة المعقولة لعبارة "يبدو بشريًا" هي أداء طبيعي ودافئ وجيد الإيقاع، لا إخفاء أن آلة تتكلم.
النسخ الصوتية ترفع الرهان. وجدت دراسة PLOS One عام 2025 أن المستمعين لم يستطيعوا التمييز بشكل موثوق بين النسخ الصوتية والأصوات البشرية الحقيقية، لكنهم كشفوا أصوات الذكاء الاصطناعي العامة. كانت العينات صغيرة، 50 مشاركًا في كل تجربة، لكن الدرس واضح: إذا كان صوتك قادرًا على خداع الناس فأخبرهم.