Comece pelo ouvinte, não pela marca
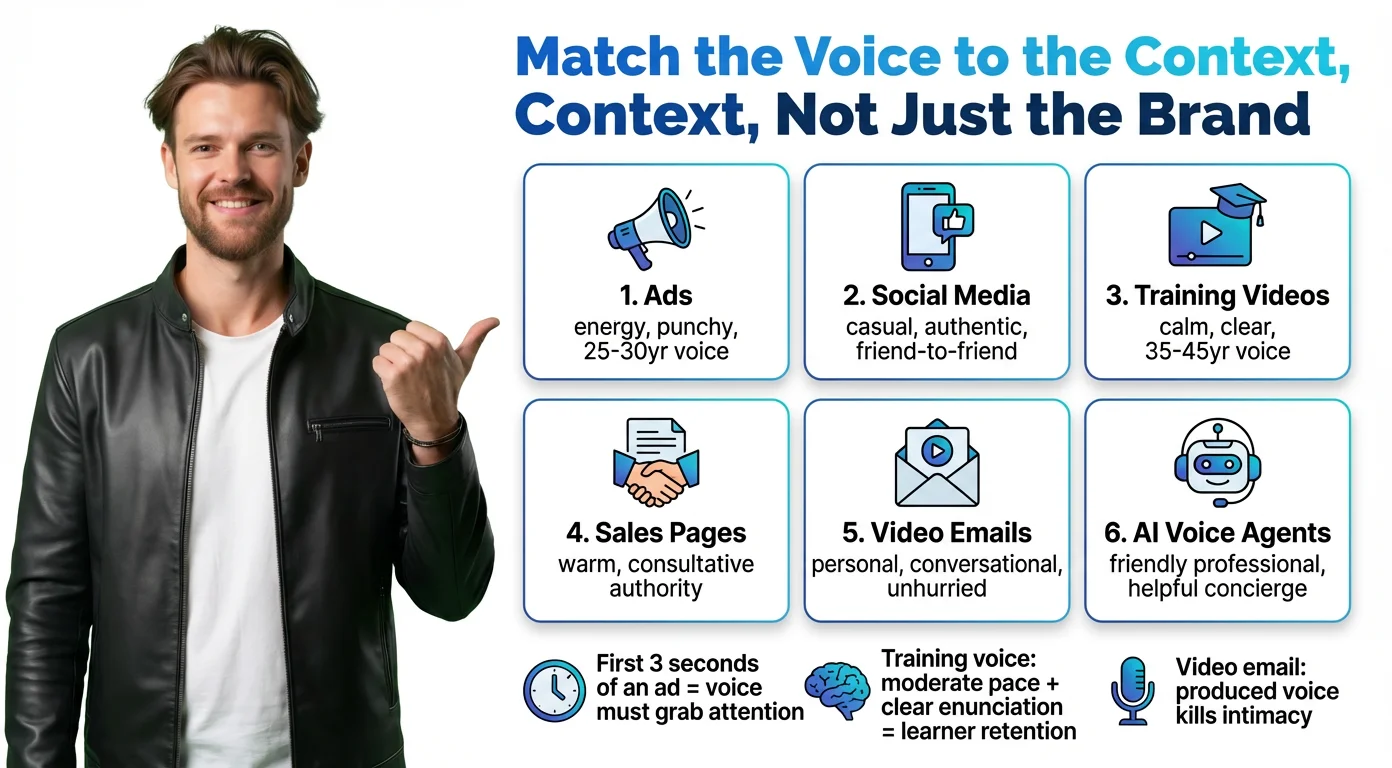
O primeiro erro é tratar a voz como uma cor de marca: escolhe se uma e usa se em todo o lado. Uma voz que gera confiança numa página de vendas pode soar rígida num clipe social, e uma voz de anúncio ofegante cansa depois de dez minutos de formação.
Eis como eu mudaria a voz conforme o uso.
Anúncios e conteúdo promocional
Tem cerca de três segundos para captar a atenção, por isso a voz precisa de energia e impulso. Uma persona dos 20 aos 30 e poucos anos serve produtos de consumo. Um tom mais grave e firme serve B2B ou marcas premium. Peça ritmo animado e entrega incisiva.
Vídeos para redes sociais
As redes sociais premeiam a sensação de uma pessoa real a falar com um amigo. Descontraída, direta, um pouco entusiasmada. Tudo o que soe produzido quebra o encanto. Peça tom de conversa, proximidade e ritmo natural.
Vídeos de formação e explicativos
Seguem se durante mais tempo, por isso a clareza pesa mais do que a personalidade. Calma e comedida sem ficar monótona. Uma persona dos 35 aos 45 anos traz autoridade sem distância. Peça dicção clara, ritmo moderado, calorosa mas instrutiva.
Páginas de vendas e landing pages
Aqui o trabalho é gerar confiança. A voz deve soar como um consultor conhecedor, seguro e caloroso, sem pressão. Evite tudo o que pareça encenado. Peça tom consultivo, timbre suave, autoridade de conversa.
E mails em vídeo
O objetivo de um e mail em vídeo é parecer pessoal, e uma voz demasiado produzida estraga isso numa frase. Aponte a uma conversa a dois: calorosa, sem pressa, com pausas naturais.
Agentes de voz com IA (site e landing pages com vídeo)
Esta voz é muitas vezes o primeiro contacto de marca que um visitante ouve. Deve ser simpática e prestável: menos guião de call center, mais colega que domina o assunto.
A idade liga tudo isto. Uma voz de 22 anos a narrar um módulo de compliance soa errada, e uma de 55 num anúncio de TikTok parece desligada. É uma das alavancas menos exploradas do design de voz.
O lado «humano» importa mesmo para quem compra? Um estudo de um fornecedor sugere que a diferença é pequena. A Azerion, uma empresa britânica de publicidade áudio, testou anúncios com 3.000 ouvintes em março e abril de 2026. Só 29% de quem ouviu a versão com IA disse corretamente que era artificial, e 78% concordaram que a voz de IA soava natural, contra 75% da voz humana. Encare isto como um resultado de fornecedor para duas marcas de grande consumo, não uma regra universal. Ainda assim, mostra que o ouvinte avalia primeiro a entrega.

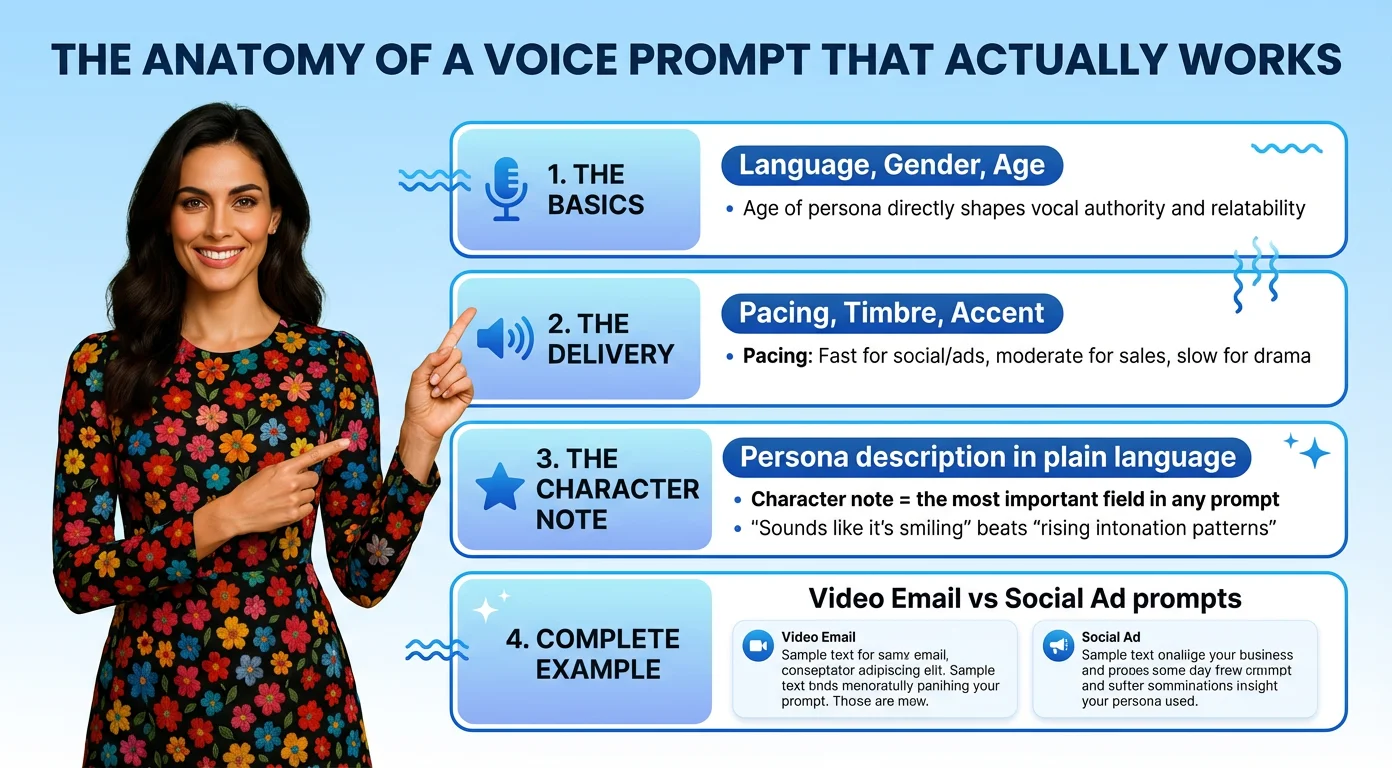
A anatomia de um prompt de voz que realmente funciona
Um prompt de voz não é uma lista de adjetivos. É a descrição de uma personagem, específica ao ponto de duas pessoas diferentes que a leiam imaginarem o mesmo falante.
Os prompts fortes têm três camadas.
O básico: idioma, género e idade
Isto define os limites exteriores. «Mulher, 30 e poucos anos, inglês americano» vale muito mais do que «mulher». A idade molda a qualidade vocal, a energia e a autoridade, por isso não a deixe vaga.
A entrega: ritmo, timbre e sotaque
O ritmo controla a energia: rápido para redes e anúncios, moderado para vendas e formação, lento para drama. O timbre é a textura da voz: quente, brilhante, grave, rouca, suave. O sotaque acrescenta carácter e localização, e pode decidir se uma voz soa nativa para o seu público ou ligeiramente estranha.
A nota de personagem: o campo mais importante
É aqui que a voz passa de genérica a específica. Descreva a pessoa, não a acústica. «Soa como se sorrisse enquanto fala consigo» dá melhor resultado do que «padrões de entoação ascendente com proximidade frontal».
Notas de personagem que costumam funcionar:
- Estrela da rádio: brilhante, muito energética, polida. Anúncios e promoções.
- Narrador cinematográfico: grave, pausado, dramático. Storytelling de marca.
- Apresentador de podcast: descontraído, caloroso, curioso. Explicações e liderança de opinião.
- Treinador simpático: claro, encorajador, paciente. Formação e integração.
- DJ da noite: suave, grave, íntimo. Luxo e conteúdo de ambiente.
- Pivô de notícias: nítido, neutro, com autoridade. Relatórios e atualizações.
Dois exemplos completos
Para um e mail em vídeo: «Voz feminina calorosa e simpática, 30 e poucos anos, inglês americano, ritmo moderado. Conversacional e acessível, como uma colega a partilhar um conselho útil com um café. Um ligeiro sorriso na entrega. Profissional, mas nunca rígida.»
Para um anúncio social: «Voz masculina enérgica, 20 e poucos anos, sotaque americano neutro, ritmo rápido. Confiante e entusiasmado, como alguém que acabou de descobrir algo ótimo e mal pode esperar para contar. Timbre brilhante, entrega incisiva.»
O que distingue estes prompts de um fraco não é o tamanho. É descreverem uma personalidade, não apenas parâmetros.
Como a BIGVU transforma um prompt numa voz de marca em menos de 2 minutos
Escrever o prompt é o trabalho estratégico. Gerar a voz deve ser sem atrito, e é para isso que existe a ferramenta Voice Design da BIGVU.
O fluxo vive dentro do Brand Kit, em Branded Media. Corre em quatro passos.
Passo 1: defina os parâmetros
Escolha idioma, sotaque, género, ritmo, idade e timbre na interface do Voice Design. São as suas entradas técnicas, o quadro dentro do qual a IA trabalha.
Passo 2: escreva a nota de personagem
Este é o campo de prompt que conta. A BIGVU chama lhe «notas adicionais», mas trate o como um briefing de casting. «Energia de estrela da rádio», «cinematográfica e de queima lenta», «calorosa e divertida como uma apresentadora de programa da manhã». Escreva a personagem, não as especificações.
Passo 3: gere três variações e escolha
A BIGVU produz três interpretações distintas do seu prompt. Ouça cada uma com um guião de amostra, compare como resultam e escolha uma. Vê também uma descrição em linguagem simples do que foi gerado, para saber o que está a guardar.
Passo 4: dê um nome e guarde
Dê um nome à voz (a BIGVU pode sugerir um com base no idioma e no contexto cultural), reveja a descrição e guarde. A voz vai diretamente para o seu Content Bank, com retratos gerados por IA (rosto, meio corpo, corpo inteiro) prontos para produção de vídeo.
Todo o processo leva menos de dois minutos. Sem casting, sem estúdio, sem ator de voz. A voz é sua, fica guardada e pode ser reutilizada em todos os seus vídeos.
O mesmo fluxo aplica se em qualquer idioma. Uma voz portuguesa calorosa para o Brasil, uma voz japonesa profissional para Tóquio, uma voz espanhola rápida para redes na América Latina: mude o idioma, o sotaque e as notas culturais, e o resultado adapta se.

Dirigir a leitura: tags de áudio, pausas e o próprio roteiro
Uma boa voz é metade do trabalho. A outra metade é como a frase é entregue, e aqui as ferramentas diferem mais do que o marketing admite.
Tags de áudio no ElevenLabs v4
A ElevenLabs diz que o Eleven v4 e o Eleven v3 suportam tags de áudio: uma instrução curta entre parênteses retos, colocada onde a entrega deve mudar. O centro de ajuda lista exemplos como [curious], [whispers], [laughs] e [clears throat]. Um detalhe prático da documentação: o Eleven v4 e o v3 não suportam tags de pausa SSML, por isso as pausas vêm de tags como [pause] e [long pause], ou da pontuação. Num exemplo da própria ElevenLabs, a mesma frase curta durou quatro segundos sem a tag [pause] e seis com ela.
Um tutorial no canal oficial da ElevenLabs acrescenta um fluxo útil. Empilhe tags numa só linha: um início nervoso, um pigarro, depois um sussurro numa só palavra. Em guiões longos, um botão de Auto tag analisa o texto e acrescenta tags conforme o contexto. Se as tags continuarem a falhar, grave a frase você mesmo e use o Voice Changer, porque «quanto mais perto chegar da entrega que quer na sua gravação, mais perto chegará no resultado» (tradução da citação em inglês).
Indicações em linguagem natural noutras ferramentas
Outras ferramentas seguem outro caminho. O guia de texto para fala da OpenAI usa um campo de instruções, com exemplos como «Speak in a cheerful and positive tone.» Confirme a data antes de se apoiar nisto. A documentação da OpenAI diz que os modelos tts 1, tts 1 hd e gpt 4o mini tts «estão descontinuados e serão desligados a 6 de janeiro de 2027» (tradução do inglês). A Google afirma que o seu texto para fala do Gemini 3.8 permite escrever as suas indicações de cena e acrescentar sinais como |mhm| para dar textura de conversa. O guia do Octave da Hume lembra um princípio válido em todo o lado: use texto de entrada expressivo para obter fala mais expressiva e escreva uma palavra em maiúsculas para dar mais ênfase.
O roteiro pesa mais do que pensa
O criador Isaac, cujo vídeo no YouTube tem mais de 735.000 visualizações, resume a voz de IA com som humano em quatro coisas: mudanças de tom, pausas, ênfase e um roteiro que não saiu direto do ChatGPT. Gera também poucas frases de cada vez em vez do guião inteiro. É um conselho que vale para qualquer ferramenta de voz e não custa nada.
O contraponto honesto: as tags não são fiáveis
Não espere que as tags funcionem sempre. A analista Janine Heinrichs, da Unite.AI, escreveu em setembro de 2026 que «a maior fraqueza foi a adesão inconsistente às tags de desempenho» (tradução do inglês). Isaac verificou que, ao juntar tags v3 ao seu próprio clone, «altera ligeiramente a própria voz», por isso voltou ao v2 com menos estabilidade. O vídeo dele é anterior ao v4, por isso essa queixa pode já não se aplicar. A resposta prática: poucas tags, colocadas mesmo antes das palavras que devem afetar, e ouvir cada take.
Mais uma cautela sobre as alegações de desempenho. A ElevenLabs afirma que o Eleven v4 ficou em primeiro lugar segundo a Artificial Analysis e foi preferido por cerca de 75% dos ouvintes em testes cegos. São números da própria ElevenLabs, e a Google faz a sua própria alegação de primeiro lugar para o Gemini 3.8 noutro benchmark. Teste com o seu próprio roteiro.
Erros comuns nos prompts, e por que «humana» não significa «escondida»
A maioria das vozes que falham fá lo pelas mesmas poucas razões.
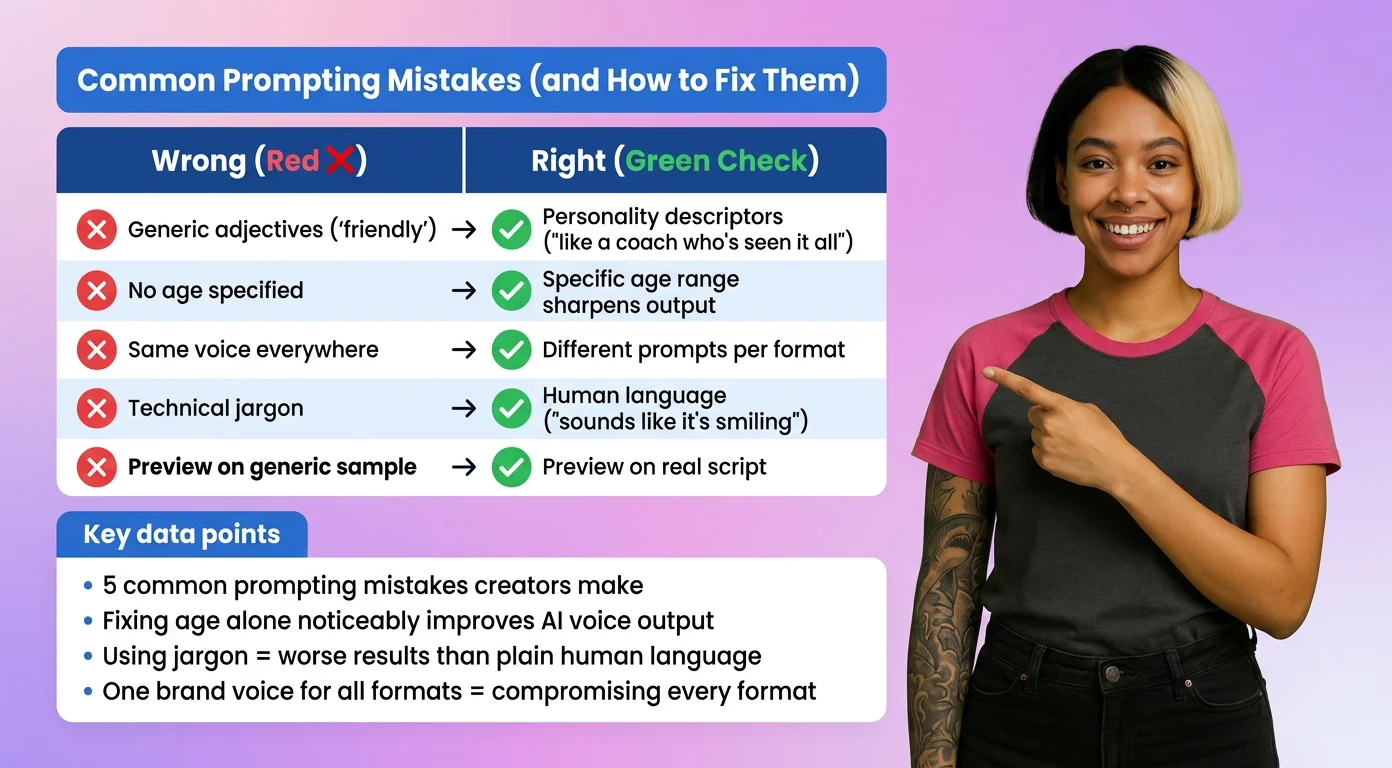
Usar só adjetivos genéricos
«Profissional», «simpática», «clara». Toda a voz decente é isso, por isso estas palavras dão quase nada à IA. Troque as por personalidade: «como um treinador experiente que já viu tudo mas ainda se entusiasma a ajudar».
Ignorar a idade
Sem uma idade de referência, a voz cai no meio termo, que costuma ser aceitável e raramente ótimo. Indique a faixa e o resultado fica mais nítido.
Usar a mesma voz em todo o lado
Uma única voz de marca para todos os formatos não serve bem nenhum. A sua página de vendas, os seus clipes sociais e os vídeos de integração têm tarefas diferentes. Dê lhes variações de prompt diferentes.
Escrever jargão em vez de descrição
«Variação prosódica» e «voz crepitante» podem ser termos exatos, mas os modelos respondem melhor a linguagem humana. Descreva a experiência de ouvir. «Soa como se sorrisse» vence «tom elevado com modulação ascendente».
Saltar a pré visualização com o roteiro real
Uma voz pode brilhar numa frase de amostra e falhar no seu texto real. Ouça uma ou duas linhas do roteiro que ela vai narrar.
Tentar passar por uma pessoa
Isto é tanto ético como prático. As políticas de utilização da OpenAI «exigem que informe claramente os utilizadores finais de que a voz TTS que ouvem é gerada por IA» (tradução do inglês). O inquérito da Adobe de 2026 a 850 consumidores dos EUA concluiu que 88% já tinham ouvido uma voz e duvidado se era IA, enquanto 77% continuam a confiar mais nas vozes humanas. A Adobe vende ferramentas de áudio com IA, por isso leia o como um estudo de fornecedor. A leitura sensata de «soar humano» é uma entrega natural, calorosa e bem ritmada, não esconder que fala uma máquina.
Os clones elevam a fasquia. Um estudo da PLOS One de 2025 concluiu que os ouvintes não distinguiam de forma fiável clones de voz de vozes humanas reais, mas detetavam as vozes de IA genéricas. As amostras eram pequenas, 50 participantes por experiência, mas a lição é clara: se a sua voz consegue enganar as pessoas, diga o.