Zacznij od słuchacza, nie od marki
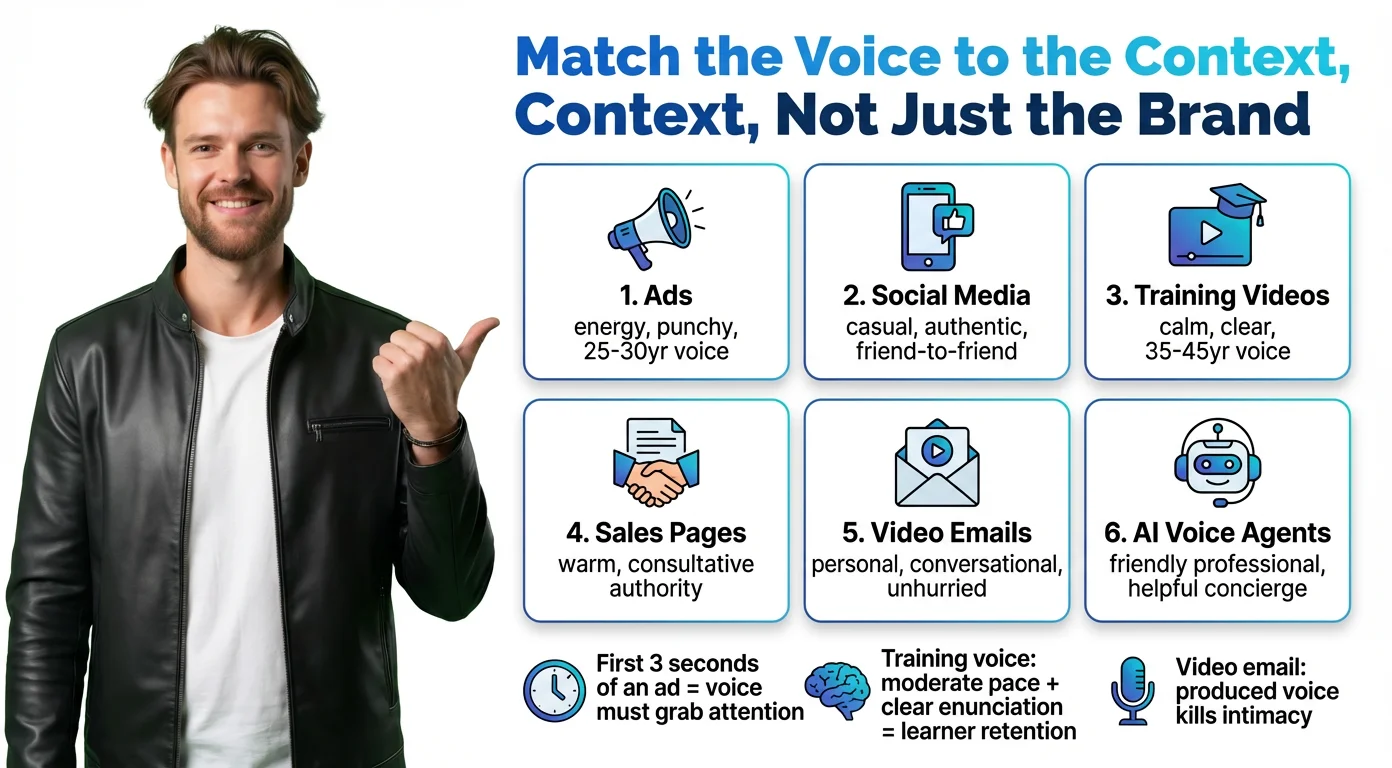
Pierwszy błąd to traktowanie głosu jak koloru marki: wybiera się jeden i używa wszędzie. Głos, który buduje zaufanie na stronie sprzedażowej, może brzmieć sztywno w klipie społecznościowym, a zdyszany głos z reklamy męczy po dziesięciu minutach szkolenia.
Oto jak zmieniałbym głos zależnie od zastosowania.
Reklamy i treści promocyjne
Masz około trzech sekund na przyciągnięcie uwagi, więc głos potrzebuje energii i rozpędu. Postać w wieku od 20 do 30 kilku lat pasuje do produktów konsumenckich. Głębszy, spokojniejszy ton pasuje do B2B lub marek premium. Poproś o żywe tempo i wyrazistą dykcję.
Filmy w mediach społecznościowych
Media społecznościowe nagradzają wrażenie, że prawdziwy człowiek mówi do przyjaciela. Swobodnie, wprost, trochę z entuzjazmem. Wszystko, co brzmi na wyprodukowane, psuje czar. Poproś o ton rozmowy, bliskość i naturalne tempo.
Filmy szkoleniowe i objaśniające
Ogląda się je dłużej, więc jasność liczy się bardziej niż osobowość. Spokojny i wyważony, ale nie płaski. Postać w wieku od 35 do 45 lat daje autorytet bez dystansu. Poproś o wyraźną dykcję, umiarkowane tempo, ciepło, ale instruktażowo.
Strony sprzedażowe i landing page
Tu chodzi o zaufanie. Głos powinien brzmieć jak kompetentny doradca, pewny i ciepły, bez presji. Unikaj wszystkiego, co wygląda na odgrywane. Poproś o ton doradczy, łagodną barwę, autorytet w rozmowie.
Maile wideo
Cała idea maila wideo polega na tym, że wydaje się osobisty, a przeprodukowany głos niszczy to w jednym zdaniu. Celuj w rozmowę w cztery oczy: ciepłą, niespieszną, z naturalnymi pauzami.
Agenci głosowi AI (strona internetowa i landing page z wideo)
Ten głos jest często pierwszym kontaktem z marką, jaki słyszy odwiedzający. Powinien być życzliwy i pomocny: mniej skryptu z call center, więcej kompetentnego kolegi.
Wiek łączy to wszystko. Głos dwudziestodwulatka czytający moduł zgodności brzmi nie tak, a głos pięćdziesięciopięciolatka w reklamie na TikToku wydaje się oderwany. To jedna z najmniej wykorzystywanych dźwigni w projektowaniu głosu.
Czy „ludzkość” naprawdę ma znaczenie dla kupujących? Badanie dostawcy sugeruje, że różnica jest niewielka. Azerion, brytyjska firma od reklamy audio, przetestowała spoty na 3000 słuchaczy w marcu i kwietniu 2026. Tylko 29% osób, które usłyszały wersję AI, poprawnie uznało ją za sztuczną, a 78% zgodziło się, że głos AI brzmi naturalnie, wobec 75% dla głosu człowieka. Traktuj to jako wynik dostawcy dla dwóch znanych marek, a nie uniwersalną regułę. Pokazuje jednak, że słuchacze oceniają najpierw sposób podania.

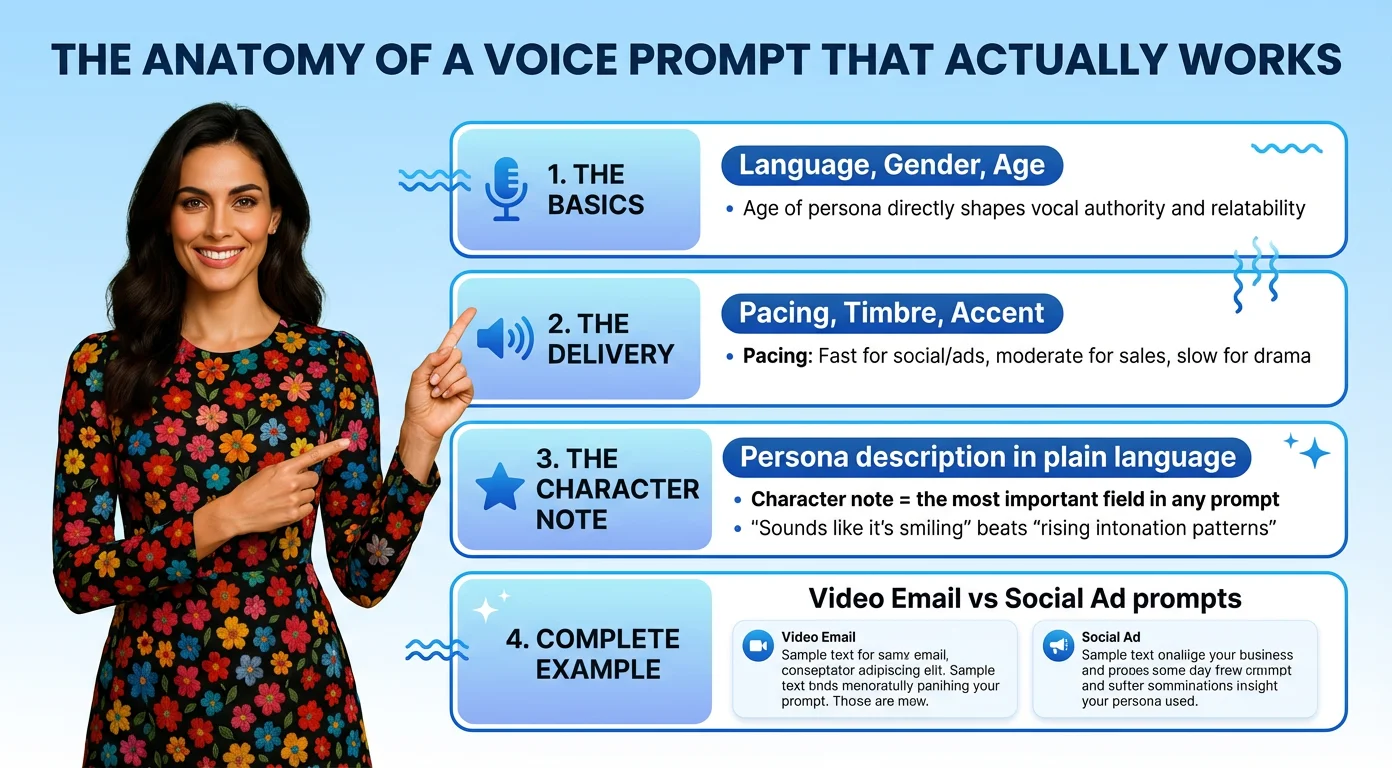
Anatomia promptu głosowego, który naprawdę działa
Prompt głosowy to nie lista przymiotników. To opis postaci, na tyle konkretny, że dwie różne osoby czytające go wyobrażą sobie tego samego mówcę.
Mocne prompty mają trzy warstwy.
Podstawy: język, płeć i wiek
To wyznacza zewnętrzne granice. „Kobieta, po trzydziestce, amerykańska angielszczyzna” jest dużo lepsza niż „kobieta”. Wiek kształtuje jakość głosu, energię i autorytet, więc nie zostawiaj go ogólnikowo.
Sposób podania: tempo, barwa i akcent
Tempo steruje energią: szybkie dla social mediów i reklam, umiarkowane dla sprzedaży i szkoleń, wolne dla dramatu. Barwa to faktura głosu: ciepła, jasna, głęboka, chropawa, łagodna. Akcent dodaje charakteru i lokalizacji i może przesądzić, czy głos brzmi swojsko dla Twoich odbiorców, czy lekko obco.
Notatka o charakterze: najważniejsze pole
Tu głos zmienia się z ogólnego w konkretny. Opisz osobę, nie akustykę. „Brzmi, jakby uśmiechała się, rozmawiając z tobą” daje lepszy efekt niż „rosnące wzorce intonacji z bliskością frontalną”.
Notatki o charakterze, które zwykle działają:
- Gwiazda radia: jasny, pełen energii, dopracowany. Reklamy i promocje.
- Narrator kinowy: głęboki, wyważony, dramatyczny. Opowieści marki.
- Prowadzący podcast: swobodny, ciepły, ciekawy. Objaśnienia i eksperckie opinie.
- Przyjazny trener: wyraźny, zachęcający, cierpliwy. Szkolenia i wdrożenia.
- Nocny didżej: łagodny, niski, intymny. Luksus i treści nastrojowe.
- Prezenter wiadomości: zwięzły, neutralny, autorytatywny. Raporty i komunikaty.
Dwa kompletne przykłady
Do maila wideo: „Ciepły, przyjazny głos kobiecy, po trzydziestce, amerykańska angielszczyzna, umiarkowane tempo. Rozmowny i przystępny, jak koleżanka dzieląca się pożyteczną radą przy kawie. Lekki uśmiech w głosie. Profesjonalnie, ale nigdy sztywno.”
Do reklamy w social mediach: „Energiczny głos męski, około dwudziestu pięciu lat, neutralny amerykański akcent, szybkie tempo. Pewny siebie i podekscytowany, jak ktoś, kto właśnie znalazł coś świetnego i nie może się doczekać, żeby ci o tym opowiedzieć. Jasna barwa, wyrazista dykcja.”
To, co odróżnia te prompty od słabego, to nie długość. Opisują osobowość, a nie tylko parametry.
Jak BIGVU zamienia prompt w głos marki w mniej niż 2 minuty
Napisanie promptu to praca strategiczna. Wygenerowanie głosu powinno być bezproblemowe i do tego stworzono narzędzie Voice Design w BIGVU.
Proces działa w Brand Kit, w sekcji Branded Media. Przebiega w czterech krokach.
Krok 1: ustaw parametry
Wybierz język, akcent, płeć, tempo, wiek i barwę w interfejsie Voice Design. To Twoje dane techniczne, rama, w której pracuje AI.
Krok 2: napisz notatkę o charakterze
To pole promptu, które się liczy. BIGVU nazywa je „dodatkowymi notatkami”, ale potraktuj je jak brief castingowy. „Energia gwiazdy radia”, „filmowy i powoli rozkręcający się”, „ciepły i zabawny jak prowadzący poranny program”. Napisz postać, nie specyfikację.
Krok 3: wygeneruj trzy warianty i wybierz
BIGVU tworzy trzy różne interpretacje Twojego promptu. Odsłuchaj każdą na przykładowym skrypcie, porównaj, jak brzmią, i wybierz jedną. Widzisz też opis wygenerowanego głosu prostym językiem, więc wiesz, co zachowujesz.
Krok 4: nazwij i zapisz
Nadaj głosowi nazwę (BIGVU może zaproponować ją na podstawie języka i kontekstu kulturowego), sprawdź opis i zapisz. Głos trafia od razu do Content Bank, z portretami wygenerowanymi przez AI (twarz, popiersie, cała postać) gotowymi do produkcji wideo.
Cały proces trwa krócej niż dwie minuty. Bez castingu, bez studia, bez lektora. Głos jest Twój, zapisany i gotowy do użycia w każdym filmie.
Ten sam proces działa w każdym języku. Ciepły portugalski głos dla Brazylii, profesjonalny japoński dla Tokio, szybki hiszpański dla social mediów w Ameryce Łacińskiej: zmień język, akcent i notatki kulturowe, a wynik się dostosuje.

Reżyserowanie czytania: tagi audio, pauzy i sam skrypt
Dobry głos to połowa pracy. Drugą połową jest to, jak zostaje wypowiedziana kwestia, a tu narzędzia różnią się bardziej, niż przyznaje ich marketing.
Tagi audio w ElevenLabs v4
ElevenLabs podaje, że Eleven v4 i Eleven v3 obsługują tagi audio: krótką instrukcję w nawiasach kwadratowych, umieszczoną tam, gdzie ma się zmienić sposób podania. Centrum pomocy wymienia przykłady jak [curious], [whispers], [laughs] i [clears throat]. Praktyczny szczegół z dokumentacji: Eleven v4 i v3 nie obsługują znaczników przerw SSML, więc pauzy powstają z tagów takich jak [pause] i [long pause] albo z interpunkcji. W przykładzie samego ElevenLabs ta sama krótka linijka trwała cztery sekundy bez tagu [pause] i sześć z nim.
Poradnik na oficjalnym kanale ElevenLabs dodaje przydatny sposób pracy. Układaj tagi w jednej linii: nerwowy początek, chrząknięcie, potem szept na jednym słowie. W długich skryptach przycisk Auto tag skanuje tekst i dodaje tagi według kontekstu. Jeśli tagi nadal nie trafiają, nagraj kwestię sam i użyj Voice Changer, bo „im bliżej w swoim nagraniu podejdziesz do pożądanego sposobu podania, tym bliżej będzie wynik” (tłumaczenie angielskiego cytatu).
Wskazówki w zwykłym języku gdzie indziej
Inne narzędzia idą inną drogą. Przewodnik OpenAI po zamianie tekstu na mowę używa pola instrukcji, z przykładami jak „Speak in a cheerful and positive tone.” Sprawdź jednak daty, zanim na tym oprzesz pracę. Dokumentacja OpenAI mówi, że modele tts 1, tts 1 hd i gpt 4o mini tts „są wycofane i zostaną wyłączone 6 stycznia 2027” (tłumaczenie z angielskiego). Google twierdzi, że jego zamiana tekstu na mowę w Gemini 3.8 pozwala pisać własne wskazówki reżyserskie i dodawać sygnały jak |mhm| dla rozmownej faktury. Przewodnik Hume po Octave przypomina zasadę ważną wszędzie: używaj ekspresyjnego tekstu wejściowego, by uzyskać bardziej ekspresyjną mowę, a słowo napisane wielkimi literami dostaje mocniejszy akcent.
Skrypt znaczy więcej, niż myślisz
Twórca Isaac, którego film na YouTube ma ponad 735 000 wyświetleń, sprowadza ludzko brzmiący głos AI do czterech rzeczy: zmian tonu, pauz, akcentów i skryptu, który nie wyszedł prosto z ChatGPT. Generuje też po kilka zdań naraz, a nie cały skrypt. To rada, która działa z każdym narzędziem głosowym i nic nie kosztuje.
Uczciwy kontrargument: tagi nie są niezawodne
Nie oczekuj, że tagi będą działać za każdym razem. Recenzentka Janine Heinrichs z Unite.AI napisała we wrześniu 2026, że „największą słabością było niespójne stosowanie się do tagów wykonania” (tłumaczenie z angielskiego). Isaac zauważył, że po dodaniu tagów v3 do własnego klona „lekko zmienia to sam głos”, więc wrócił do v2 z niższą stabilnością. Jego film powstał przed v4, więc ta uwaga może już nie obowiązywać. Praktyczna odpowiedź: mało tagów, tuż przed słowami, na które mają wpływać, i odsłuch każdego ujęcia.
Jeszcze jedna ostrożność wobec deklaracji wydajności. ElevenLabs twierdzi, że Eleven v4 został uznany przez Artificial Analysis za numer jeden i preferowany przez około 75% słuchaczy w testach na ślepo. To własne liczby ElevenLabs, a Google zgłasza własne pierwsze miejsce dla Gemini 3.8 w innym benchmarku. Przetestuj na własnym skrypcie.
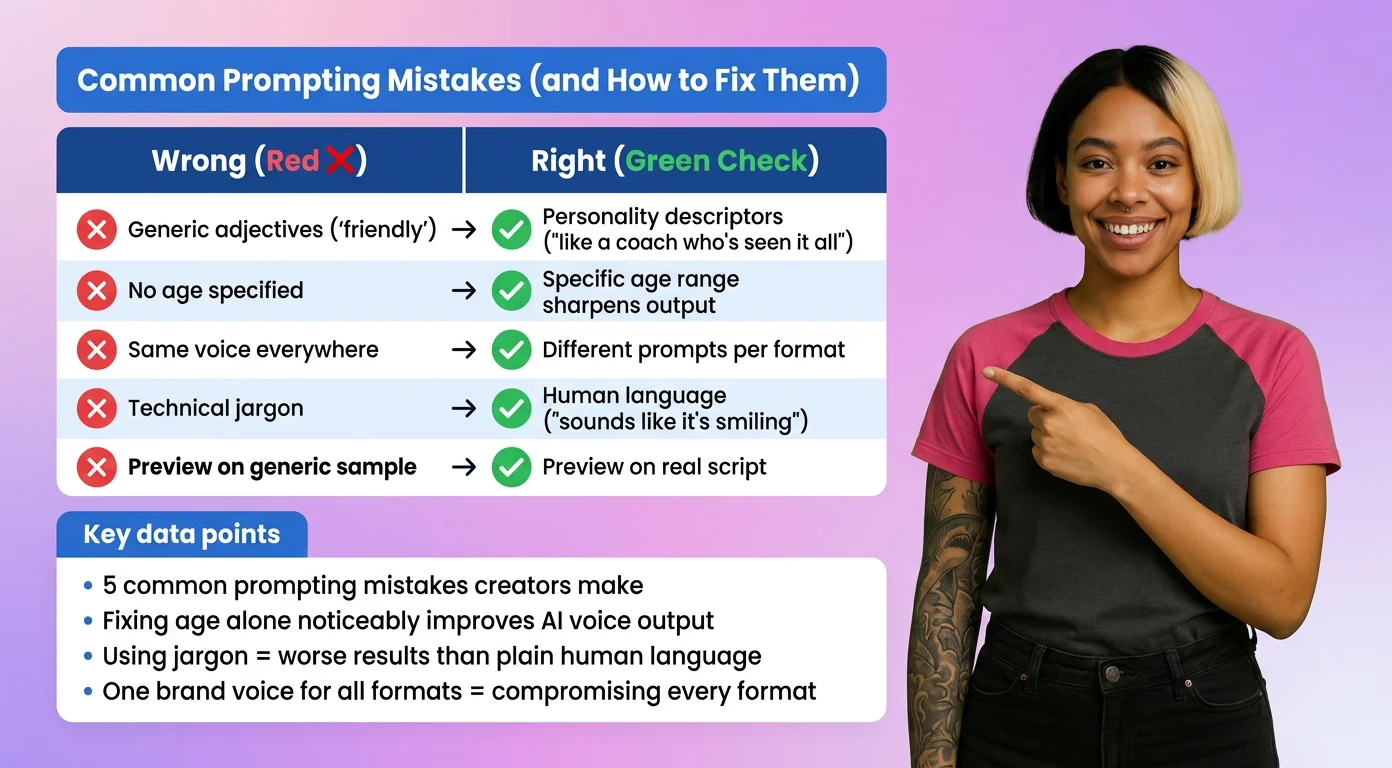
Częste błędy w promptach i dlaczego „ludzki” nie znaczy „ukryty”
Większość głosów, które chybiają, zawodzi z tych samych kilku powodów.
Używanie wyłącznie ogólnych przymiotników
„Profesjonalny”, „przyjazny”, „wyraźny”. Każdy przyzwoity głos taki jest, więc te słowa dają AI prawie nic. Zamień je na osobowość: „jak doświadczony trener, który widział już wszystko, ale nadal cieszy się, że może pomagać”.
Pomijanie wieku
Bez punktu odniesienia wieku głos ląduje pośrodku, co zwykle jest w porządku i rzadko świetne. Podaj przedział, a wynik stanie się ostrzejszy.
Ten sam głos wszędzie
Jeden głos marki do każdego formatu nie służy dobrze żadnemu z nich. Strona sprzedażowa, klipy społecznościowe i filmy wdrożeniowe mają różne zadania. Daj im różne warianty promptu.
Pisanie żargonu zamiast opisu
„Zmienność prozodyczna” i „vocal fry” mogą być trafne, ale modele lepiej reagują na ludzki język. Opisz doświadczenie słuchania. „Brzmi, jakby się uśmiechała” bije „podwyższoną wysokość z modulacją wznoszącą”.
Pominięcie odsłuchu z prawdziwym skryptem
Głos może błyszczeć na przykładowym zdaniu i zawieść na Twoim prawdziwym tekście. Odsłuchaj linijkę lub dwie ze skryptu, który ma czytać.
Udawanie człowieka
To kwestia równie etyczna, co praktyczna. Zasady użytkowania OpenAI „wymagają jasnego poinformowania użytkowników końcowych, że głos TTS, który słyszą, jest wygenerowany przez AI” (tłumaczenie z angielskiego). Ankieta Adobe z 2026 roku wśród 850 amerykańskich konsumentów wykazała, że 88% słyszało głos i zastanawiało się, czy to AI, a 77% nadal najbardziej ufa ludzkim głosom. Adobe sprzedaje narzędzia audio AI, więc czytaj to jako badanie dostawcy. Rozsądne rozumienie „brzmieć ludzko” to naturalne, ciepłe, dobrze rozłożone podanie, a nie ukrywanie, że mówi maszyna.
Klony podnoszą stawkę. Badanie PLOS One z 2025 roku wykazało, że słuchacze nie potrafili wiarygodnie odróżnić klonów głosu od prawdziwych głosów ludzkich, ale rozpoznawali ogólne głosy AI. Próby były małe, 50 uczestników na eksperyment, lecz lekcja jest jasna: jeśli Twój głos może zmylić ludzi, powiedz o tym.