
Co właściwie dzieje się, gdy zdjęcie uczy się mówić
Pod maską większość narzędzi do robienia zdjęć AI obsługuje wersję tego samego potoku. W podziale na r/generativeAI użytkownicy opisali to w dwóch etapach: najpierw model rekonstrukcji twarzy nadaje nieruchomemu obrazowi naturalny ruch, a następnie model synchronizacji warg sterowany dźwiękiem zmienia kształt ust, aby dopasować je do każdego dźwięku w ścieżce głosowej. Nazwy open source, które pojawiają się wielokrotnie, to SadTalker i LivePortrait dla ruchu oraz Wav2Lip dla ust, podczas gdy D-ID i HeyGen łączą podobne kroki w produkcie.
Dlaczego usta są najtrudniejszą częścią
Badacze stojący za MuseTalk, modelem synchronizacji ruchu warg opisanym w artykule na temat arXiv , przedstawiają problem jako trylemat. Metody oparte na dyfuzji wyglądają świetnie, ale są drogie w utrzymaniu. Szybsze metody oparte na GAN zwykle poświęcają dokładność synchronizacji ruchu warg lub „szczegóły dentystyczne”, co jest uprzejmym, akademickim sposobem powiedzenia, że zęby robią się papkowate. MuseTalk działa w skompresowanej przestrzeni ukrytej, aby uzyskać zarówno szybkość, jak i szczegółowość, i raportuje 30 klatek na sekundę przy rozdzielczości 256 na 256 pikseli na pojedynczej karcie graficznej NVIDIA V100.
Warto zapamiętać tę rozdzielczość. Model przerysowuje tylko niewielki obszar wokół ust, a następnie łączy go z powrotem w obraz w pełnym rozmiarze. Kiedy twarz jest mała, odwrócona lub słabo oświetlona, jest mniej realnych szczegółów do pracy i zwykle wtedy załamuje się iluzja.
Gdzie szukać, oceniając jednego
Twórca, który w teście side-by-side na YouTube porównał HeyGen z tańszym narzędziem, podał przydatną listę kontrolną: obserwuj kąciki ust, obserwuj, co robi głowa, gdy kończy się zdanie i słuchaj twardych spółgłosek, takich jak P i B, ponieważ „zwykle w tym miejscu tańsze narzędzia do synchronizacji warg całkowicie się rozpadają”.
Przesłane zdjęcie decyduje o większości wyniku
Każda platforma może animować tylko to, co jest na obrazku, więc dane wejściowe zasługują na większą uwagę niż ustawienia. Rady osób, które co tydzień nagrywają te filmy, są ze sobą ściśle powiązane.
- Stań twarzą w twarz z kamerą. Poradnik Hedry z lutego 2026 r. zaleca wyraźne zdjęcie z twarzą skierowaną prosto w obiektyw, dobrze oświetlone oraz przestrzega przed bocznymi profilami i nieostrymi ujęciami. Zwraca także uwagę, że Hedra odrzuca obrazy mniejsze niż 300 pikseli.
- Zacznij neutralnie. Ten sam samouczek sugeruje neutralną ekspresję, jeśli wynik wygląda sztywnie, a także lepsze oświetlenie i czysty dźwięk, ponieważ czysty dźwięk „poprawia dokładność synchronizacji ruchu warg”.
- Staraj się, aby klipy były krótkie. „Krótsze klipy wyglądają bardziej realistycznie”, zauważa samouczek. Podziel długi scenariusz na kilka krótkich filmów zamiast jednego długiego ujęcia.
- Uspokój ruch. Twórczyni, która w swojej solucji do HeyGen tworzy awatary z jednego obrazu, dodaje niestandardowy monit ruchowy z prośbą o naturalny wygląd, kilka widocznych zębów i brak rąk, ponieważ ustawienie domyślne może sprawić, że postacie będą zbyt wyraziste.
- Jeśli możesz, daj mu więcej niż jedną szansę. HeyGen sugeruje przesłanie kilku dodatkowych zdjęć, aby model mógł uchwycić więcej szczegółów.
Głos jest równie ważny jak twarz. Płaska, pospieszna ścieżka głosowa sprawia, że nawet idealne usta wyglądają źle. Napisz scenariusz mówienia, przeczytaj go raz na głos i wytnij każde zdanie, na które się potkniesz, zanim cokolwiek wygenerujesz.
BIGVU vs HeyGen vs Hedra: co daje każdy z nich
Wszystkie trzy zamieniają zdjęcie w mówiącego awatara , ale są zbudowane dla różnych kupujących. Oto, co każdy sprzedawca pokazuje obecnie na swoich stronach.
Mówiące zdjęcie BIGVU AI
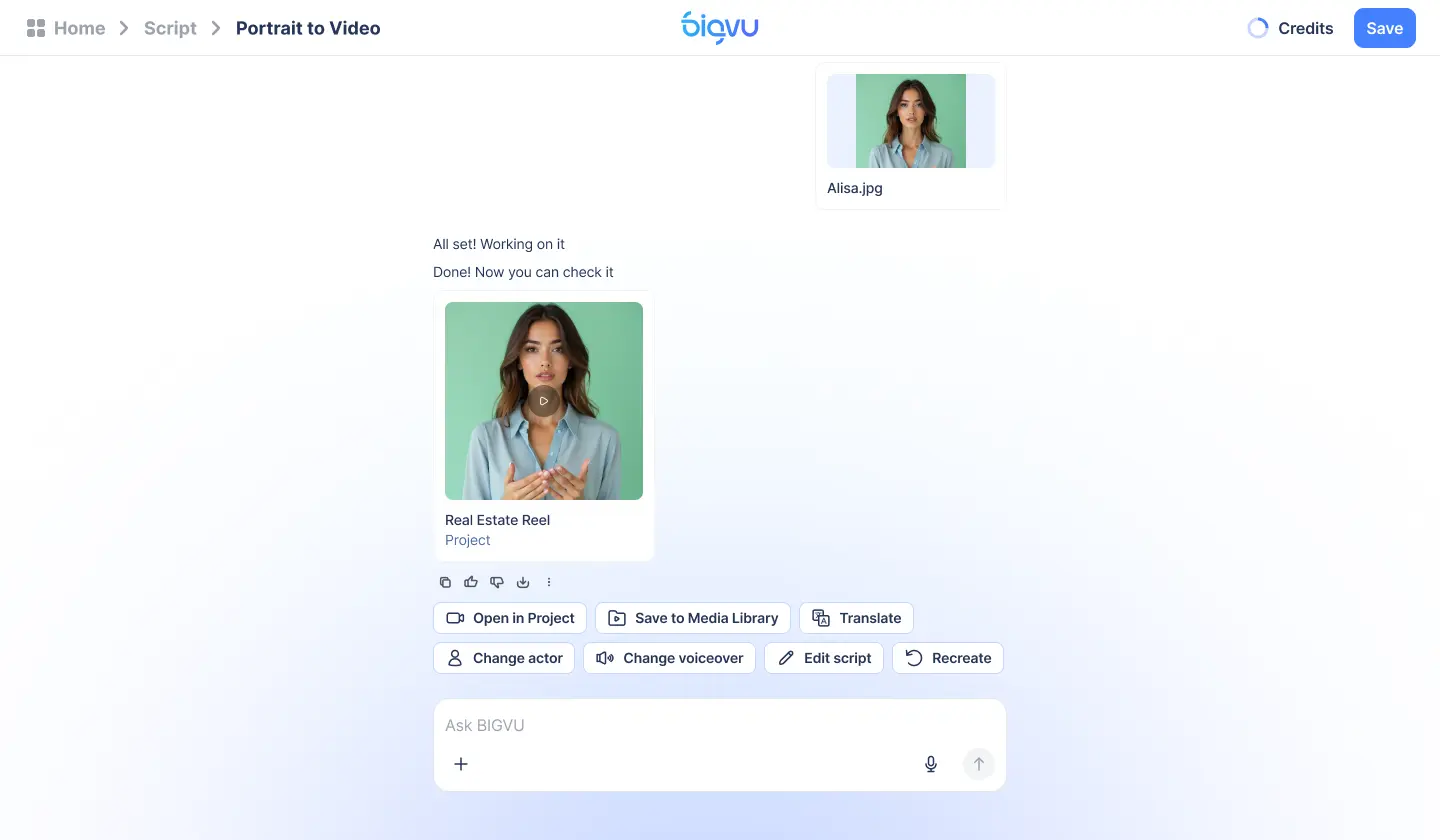
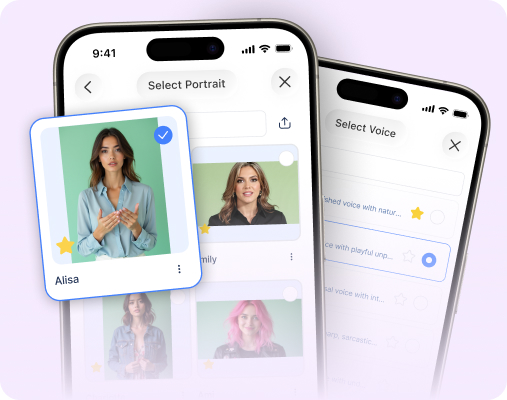
AI Talking Photo BIGVU działa w trzech krokach: prześlij portret, dodaj swój scenariusz i głos, a następnie wygeneruj i opublikuj. Możesz napisać scenariusz samodzielnie lub za pomocą generatora skryptów AI i wybrać głos z biblioteki BIGVU lub sklonować własny . Film zsynchronizowany z ruchem warg pozostaje następnie w tej samej aplikacji do obsługi napisów, zestawu marki i publikacji, a Ty możesz pracować w Internecie, na iPhonie lub w systemie Android. Funkcje AI korzystają z miesięcznych kredytów, a strona z cenami przelicza je na czas wideo: 500 kredytów w ramach darmowego planu wystarcza na około 10 sekund portretowego wideo, a 3000 kredytów w AI Pro na około jedną minutę.
Awatar fotograficzny HeyGen
Strona z awatarami zdjęć HeyGen reklamuje mówiące zdjęcia w ponad 175 językach i dialektach, podpowiedzi tekstowe i pakiety wyglądu, które zmieniają Twój strój lub tło, a także silnik Avatar IV, który zamienia pojedynczy obraz w wideo z synchronizacją głosu i gestami rąk. Na stronie z cenami , sprawdzonej 1 listopada 2026 r., bezpłatny plan zapewnia 3 filmy ze znakiem wodnym miesięcznie po maksymalnie 1 minutę każdy, Kreator kosztuje 29 USD miesięcznie z 600 punktami, a Pro kosztuje 49 USD miesięcznie z 1000 kredytów i filmów trwających do 30 minut. Pamiętaj, że HeyGen twierdzi, że kredyty wygasają w przypadku anulowania subskrypcji, a pobieranie na naszym bezpłatnym koncie było ograniczone do rozdzielczości 720p.
Hedra
Publiczna strona z cenami Hedry nie wyświetla już planów miesięcznych. Opłaty pobierane są za wydruk z przedpłaconego salda w dolarach: generowanie awatara i synchronizacji ruchu warg od 2,5 centa za sekundę, skalowanie w górę przy 2,14 centa za sekundę, edycja przy 7 centach za sekundę i ponowne uruchamianie po 20 centów za sekundę, bez subskrypcji.
Co się stało, gdy zrobiliśmy jednego na Hedrze
Zaczęliśmy od darmowego planu Hedry, który obejmował 100 kredytów. Utworzenie obrazu początkowego pochłonęło 7 kredytów i zajęło około pół minuty. Do części mówiącej wybraliśmy Hedra Avatar, napisaliśmy siedmiosekundowy skrypt i zachowaliśmy domyślny głos w rozdzielczości 720p. Przycisk Generuj powiedział 85 kredytów. Bilans spadł o 40, a efektem był 6-sekundowy klip w rozdzielczości 1280x720 ze znakiem wodnym, gotowy w około dwie minuty. Selektor modeli pokazał również, jak bardzo mogą się wahać koszty: MiniMax H3 Max został uznany za najlepszą wartość przy cenie od 50 do 240 kredytów na generację, natomiast Seedance 2.5 został uznany za najwyższą jakość przy cenie od 84 do 3322 kredytów.
Wyróżniała się jeszcze jedna rzecz. W żadnym momencie przepływ nie zawierał etykiety ujawniającej sztuczną inteligencję, potwierdzenia zgody ani pytania o to, czy mamy prawa do zdjęcia. Jedynym oznaczeniem był znak wodny. To nakłada na Ciebie odpowiedzialność za ujawnienie informacji, co ma znaczenie w kontekście zasad opisanych poniżej.
Najlepszy kontra warto
Twórca powyższego testu side by side był dosadny: HeyGen wygrał realizmem, „nawet nie jest blisko”, ale częściej korzysta z tańszego narzędzia, ponieważ jego awatar otwiera wideo tylko przez 60, 80 sekund, zanim przejmą kontrolę nagrania ekranu. Jego zasada jest dobra w przypadku każdego z tych narzędzi wideo AI . Jeśli twarz jest produktem, zapłać za najbardziej realistyczną opcję. Jeśli twarz jest krótkim wprowadzeniem, wystarczy, że jest wystarczająco dobra.
Gdzie mówiące zdjęcia zarabiają na życie, a gdzie nie
Mówiące zdjęcia rzucają światło na powtarzające się wiadomości, które potrzebują twarzy, ale nie ekipy filmowej. BIGVU wymienia aktualizacje rynkowe, aktualizacje list, najważniejsze informacje z okolicy, często zadawane pytania, promocje, ogłoszenia wewnętrzne i objaśnienia produktów jako typowe zastosowania, a wspólnym wątkiem są powtórzenia. Gdy już będziesz mieć jeden zatwierdzony portret, możesz przygotować piątą aktualizację w miesiącu, nie rezerwując nikomu czasu.
Dobre dopasowanie
- Krótkie wstępy i powtarzające się aktualizacje. Przez pierwszą minutę znajoma twarz, potem slajdy, demonstracje lub materiały z listami.
- Marketing e-mailowy wideo. Osobiste powitanie na górze kolejnego e-maila sprawia wrażenie cieplejszego niż zwykły tekst. Narzędzie wideo e-maili BIGVU umożliwia wysyłanie plików z tego samego konta.
- Oferty bez sesji. Agenci nieruchomości mogą połączyć mówiące wprowadzenie do zdjęcia z aplikacją Fototale , która zamienia istniejące zdjęcia ofertowe w film z przesuwaniem, powiększaniem i przejściami.
Słabe dopasowanie
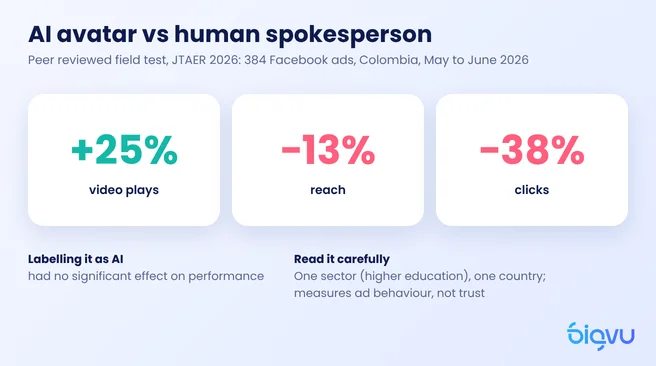
Bądź ostrożny, gdy chodzi o zaufanie. Zrecenzowany test terenowy 384 reklam na Facebooku, opublikowany w Journal of Theoretical and Applied Electronic Commerce Research w 2026 r., wykazał, że awatar AI zarobił o 25% więcej odtworzeń wideo niż ludzki rzecznik, ale o 13% mniejszy zasięg i 38% mniej kliknięć. Badanie dotyczyło reklam szkolnictwa wyższego w Kolumbii, dlatego należy je traktować jako jeden punkt danych, a nie prawo. Mimo to pokrywa się to z przytoczoną wcześniej radą twórcy YouTube’a: do pracy z klientem, marki rzecznika czy czegokolwiek, co płacący klient będzie studiował klatka po klatce, poleca najbardziej realistyczne narzędzie, na jakie Cię stać, czyli prawdziwe nagranie.
Ujawnienie, zgoda i nowe zasady
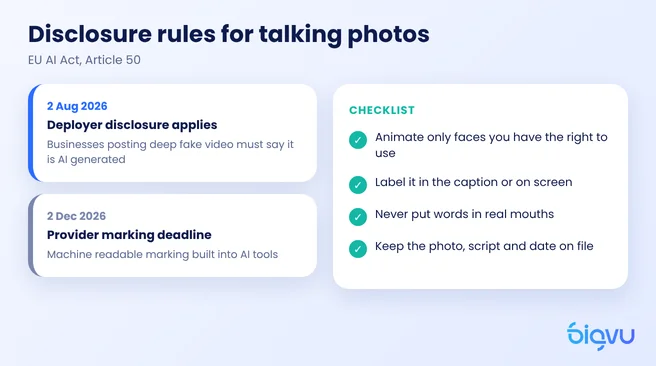
Etyka opowiadania o zdjęciach była kiedyś kwestią dobrych manier. W Unii Europejskiej jest to obecnie także obowiązek prawny. Artykuł 50 unijnej ustawy o sztucznej inteligencji stanowi, że każda osoba wdrażająca system sztucznej inteligencji generujący wideo stanowiące głęboką podróbkę lub manipulujący nim „ujawnia, że treści zostały sztucznie wygenerowane lub zmanipulowane” oraz że musi to być jasne najpóźniej w momencie, gdy widz zobaczy je po raz pierwszy. Jak wyjaśnił Morgan Lewis , te obowiązki w zakresie przejrzystości zaczęły obowiązywać 2 sierpnia 2026 r. Oddzielny czteromiesięczny okres przejściowy do 2 grudnia obejmuje jedynie oznaczenia czytelne maszynowo, które dostawcy muszą wbudować, i nie opóźnia obowiązków przedsiębiorstw publikujących filmy wideo.
10 czerwca 2026 r. Komisja Europejska opublikowała również ostateczny kodeks postępowania dotyczący oznaczania i etykietowania treści wygenerowanych przez sztuczną inteligencję, zawierający zestawikon UE dla treści w pełni wygenerowanych przez sztuczną inteligencję i częściowo zmodyfikowanych przez sztuczną inteligencję. Mówiące zdjęcie prawdziwej osoby to podręcznikowy przypadek dla tej etykiety.
Prosta lista kontrolna
- Animuj tylko te twarze, do których masz prawo używać. Twoje własne lub osoby, która udzieliła Ci wyraźnej zgody. Nigdy klient, konkurent czy gwiazda bez zgody.
- Oznacz to. Krótka linijka w podpisie lub na ekranie, np. „W tym filmie wykorzystano mówiące zdjęcie AI”, pokrywa podstawowe obowiązki i kosztuje bardzo niewiele.
- Nie wkładaj słów w prawdziwe usta. Mówiące zdjęcie, na którym czytasz własny scenariusz, to jedno. Sprawianie wrażenia, że ktoś popiera coś, czego nigdy nie powiedział, to drugie.
- Zachowaj zapis. Zapisz oryginalne zdjęcie, scenariusz i datę, na wypadek gdyby ktoś zapytał, jak powstał film.
Czy etykieta zaszkodzi wynikom? Dowody są mieszane. Powyższe badanie reklam na Facebooku wykazało, że poinformowanie widzów, że reklama została stworzona przy użyciu sztucznej inteligencji, nie miało znaczącego wpływu na wydajność. Badanie przeprowadzone w 2025 r. na 358 konsumentach w Journal of Research in Interactive Marketing wykazało coś przeciwnego: ujawnienie obniżyło wartość reklamy i jej zamiar zakupu przez ludzi. Naszym zdaniem etykieta i tak jest wymagana w UE, więc lepszym pytaniem jest, w jaki sposób sprawić, by film był wart obejrzenia, gdy ludzie się o nim dowiedzą. Prawdziwy scenariusz, prawdziwa oferta i głos, który brzmi, jakbyś przeszedł długą drogę.
Jeśli wolisz nie tworzyć ich samodzielnie, zespół SuperAgent BIGVU może tworzyć Twoje comiesięczne filmy z TalkingPhoto w sklonowanym głosie, z dedykowanym strategiem, podpisami i miniaturami, 8 filmów miesięcznie od 299 USD miesięcznie, rozliczane miesięcznie.