
Co naprawdę się dzieje, gdy zdjęcie uczy się mówić
Od środka większość narzędzi do tworzenia mówiącego zdjęcia AI korzysta z odmiany tego samego procesu. W wątku na r/generativeAI użytkownicy opisali go w dwóch etapach: najpierw model rekonstrukcji twarzy nadaje nieruchomemu zdjęciu naturalny ruch, a potem model synchronizacji ust sterowany dźwiękiem dopasowuje usta do każdej głoski ze ścieżki głosowej. Nazwy open source, które pojawiają się najczęściej, to SadTalker i LivePortrait do ruchu oraz Wav2Lip do ust, a D-ID i HeyGen łączą podobne kroki w gotowy produkt.
Dlaczego usta są najtrudniejsze
Badacze stojący za MuseTalk, modelem synchronizacji ust opisanym w artykule na arXiv, przedstawiają problem jako trylemat. Metody oparte na dyfuzji wyglądają świetnie, ale są drogie w działaniu. Szybsze metody GAN zwykle poświęcają albo dokładność ruchu warg, albo „szczegóły zębów”, co jest uprzejmym akademickim sposobem na powiedzenie, że zęby się rozmywają. MuseTalk działa w skompresowanej przestrzeni ukrytej, by połączyć szybkość ze szczegółem, i podaje 30 klatek na sekundę przy rozdzielczości 256 na 256 pikseli na jednej karcie graficznej NVIDIA V100.
Warto zapamiętać tę rozdzielczość. Model rysuje na nowo tylko mały obszar wokół ust, a potem wtapia go z powrotem w zdjęcie w pełnym rozmiarze. Gdy twarz jest mała, odwrócona albo słabo oświetlona, zostaje mniej prawdziwych szczegółów do pracy i właśnie tam iluzja zwykle się rozpada.
Na co patrzeć, oceniając efekt
Twórca, który porównał HeyGen z tańszym narzędziem w teście obok siebie na YouTube, podał przydatną listę: obserwuj kąciki ust, zwróć uwagę na to, co robi głowa na końcu zdania, i słuchaj twardych spółgłosek, takich jak P i B, bo to „zwykle tam tańsze narzędzia do synchronizacji ust całkowicie się sypią”.
Przesłane zdjęcie decyduje o większości efektu
Każda platforma może ożywić tylko to, co jest na zdjęciu, więc materiał wyjściowy zasługuje na więcej uwagi niż ustawienia. Rady osób, które robią takie filmy co tydzień, są w dużej mierze zgodne.
- Patrz w obiektyw. Poradnik Hedra z lutego 2026 roku zaleca ostre, dobrze oświetlone zdjęcie z twarzą skierowaną prosto w obiektyw i odradza ujęcia z profilu oraz rozmazane kadry. Przypomina też, że Hedra odrzuca obrazy mniejsze niż 300 pikseli.
- Zacznij od neutralnej miny. Ten sam poradnik sugeruje neutralny wyraz twarzy, jeśli efekt wygląda sztywno, a do tego lepsze światło i czysty dźwięk, bo wyraźne audio „poprawia dokładność synchronizacji ust”.
- Rób krótkie klipy. „Krótsze klipy wyglądają bardziej realistycznie”, zauważa poradnik. Podziel długi scenariusz na kilka krótkich filmów zamiast jednego długiego ujęcia.
- Uspokój ruch. Twórczyni, która w swoim poradniku do HeyGen tworzy awatary z jednego zdjęcia, dodaje własny prompt ruchu z prośbą o naturalny wygląd, mało widocznych zębów i brak dłoni w kadrze, bo ustawienia domyślne potrafią sprawić, że postacie są przesadnie ekspresyjne.
- Jeśli możesz, daj więcej niż jedno zdjęcie. HeyGen sugeruje dodanie kilku dodatkowych zdjęć, aby model uchwycił więcej szczegółów.
Głos znaczy tyle samo co twarz. Płaska, pospieszna ścieżka głosowa sprawia, że nawet idealne usta wyglądają źle. Pisz scenariusz do mówienia, przeczytaj go raz na głos i wytnij każde zdanie, na którym się potykasz, zanim cokolwiek wygenerujesz.
BIGVU, HeyGen i Hedra: co daje każde z nich
Wszystkie trzy zamieniają zdjęcie w mówiącego awatara, ale powstały z myślą o różnych klientach. Oto, co każdy dostawca pokazuje dziś na własnych stronach.
BIGVU AI Talking Photo
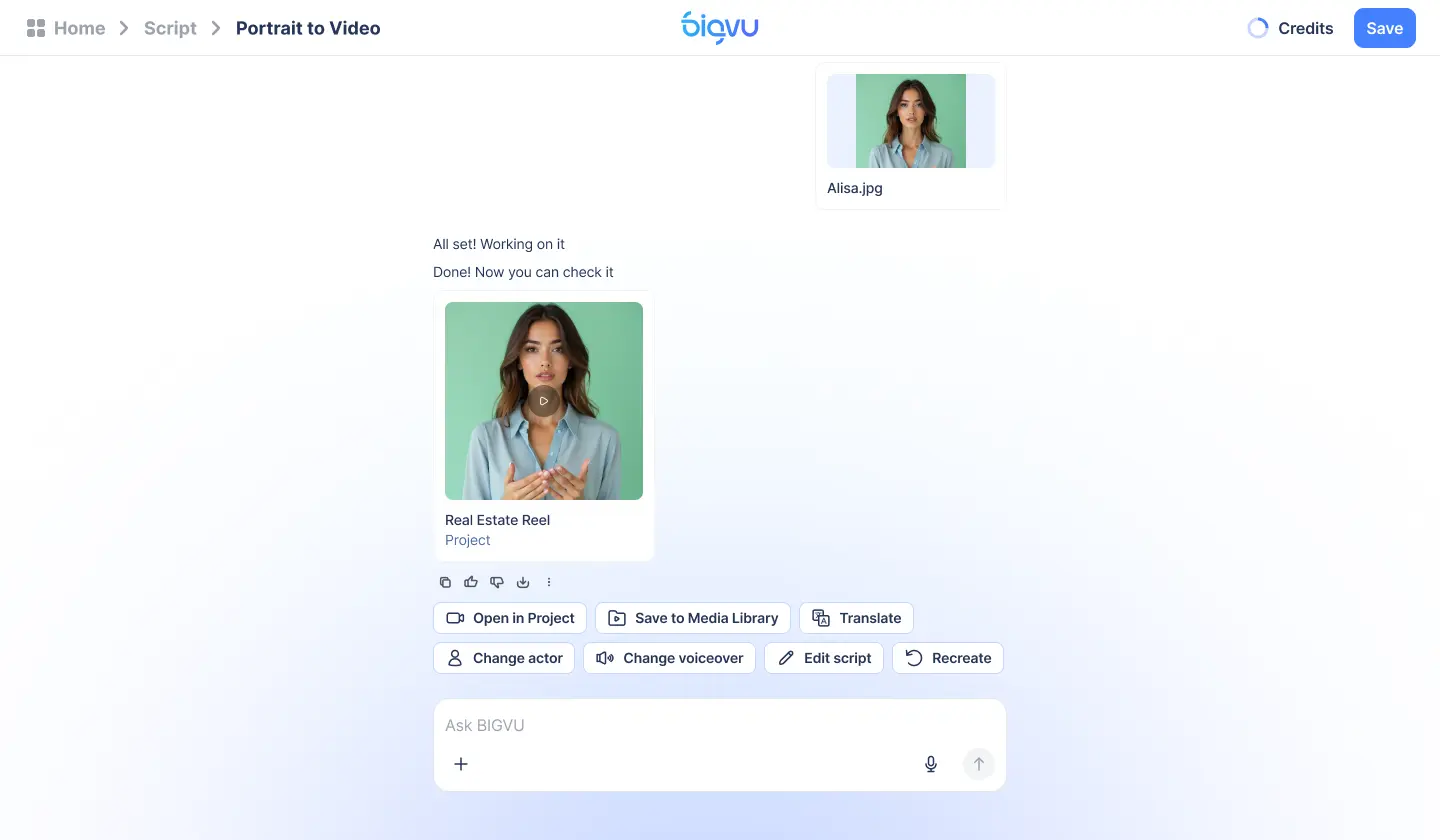
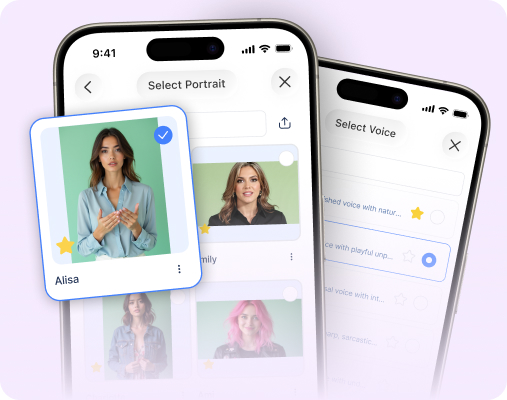
AI Talking Photo od BIGVU działa w trzech krokach: prześlij portret, dodaj scenariusz i głos, a potem wygeneruj i opublikuj. Scenariusz możesz napisać sam albo przygotować w AI Script Generator, a głos wybrać z biblioteki BIGVU lub sklonować własny. Film z synchronizacją ust zostaje w tej samej aplikacji, gdzie dodasz napisy, swój zestaw marki i opublikujesz go, a pracować możesz w przeglądarce, na iPhonie lub na Androidzie. Funkcje AI zużywają miesięczne kredyty, które strona z cennikiem przelicza na czas wideo: 500 kredytów w darmowym planie wystarcza na około 10 sekund filmu portretowego, a 3000 kredytów w AI Pro na mniej więcej minutę.
HeyGen Photo Avatar
Strona awatarów ze zdjęć HeyGen reklamuje mówiące zdjęcia w ponad 175 językach i dialektach, polecenia tekstowe i pakiety stylizacji zmieniające strój lub tło, a także silnik Avatar IV, który z jednego zdjęcia tworzy film z synchronizacją głosu i gestami dłoni. Według cennika darmowy plan daje 3 filmy miesięcznie ze znakiem wodnym, każdy do 1 minuty, Creator kosztuje 29 dolarów miesięcznie z 600 kredytami, a Pro 49 dolarów miesięcznie z 1000 kredytów i filmami do 30 minut.
Hedra
Cennik Hedra jest najbardziej szczegółowy z całej trójki. W API generowanie awatara i synchronizacji ust zaczyna się od 2,5 centa za sekundę z przedpłaconego salda w dolarach, bez subskrypcji, a klonowanie głosu jest darmowe. Jeśli wolisz aplikację Studio, plany zaczynają się od Basic za 20 dolarów miesięcznie z 2000 kredytów, przez Pro za 50 dolarów z 7200 kredytami, po Ultra za 100 dolarów z 18 000 kredytów.
Najlepsze kontra opłacalne
Autor testu obok siebie mówił wprost: HeyGen wygrał pod względem realizmu, „to nawet nie jest blisko”, a mimo to częściej używa tańszego narzędzia, bo jego awatar otwiera film tylko na 60 do 80 sekund, zanim wejdą nagrania ekranu. Jego zasada sprawdza się przy każdym z tych narzędzi wideo AI. Jeśli twarz jest produktem, zapłać za najbardziej realistyczną opcję. Jeśli twarz to krótkie wprowadzenie, wystarczająco dobre naprawdę wystarczy.
Gdzie mówiące zdjęcia się opłacają, a gdzie nie
Mówiące zdjęcia sprawdzają się w powtarzalnych komunikatach, które potrzebują twarzy, ale nie ekipy filmowej. BIGVU wymienia jako typowe zastosowania raporty rynkowe, nowości o ofertach nieruchomości, prezentacje okolicy, odpowiedzi na częste pytania, promocje, ogłoszenia wewnętrzne i objaśnienia produktów, a wspólnym mianownikiem jest powtarzalność. Mając jeden zatwierdzony portret, przygotujesz piątą aktualizację w miesiącu bez rezerwowania czyjegokolwiek czasu.
Dobre zastosowania
- Krótkie wstępy i regularne aktualizacje. Znajoma twarz przez pierwszą minutę, a potem slajdy, prezentacje lub ujęcia nieruchomości.
- Marketing wideo w mailach. Osobiste powitanie na początku maila z przypomnieniem brzmi cieplej niż sam tekst. Narzędzie do wideo maili BIGVU pozwala wysłać je z tego samego konta.
- Oferty bez sesji zdjęciowej. Agenci nieruchomości mogą połączyć wstęp z mówiącym zdjęciem z Fototale, które zamienia istniejące zdjęcia nieruchomości w film z panoramowaniem, zbliżeniami i przejściami.
Słabe zastosowania
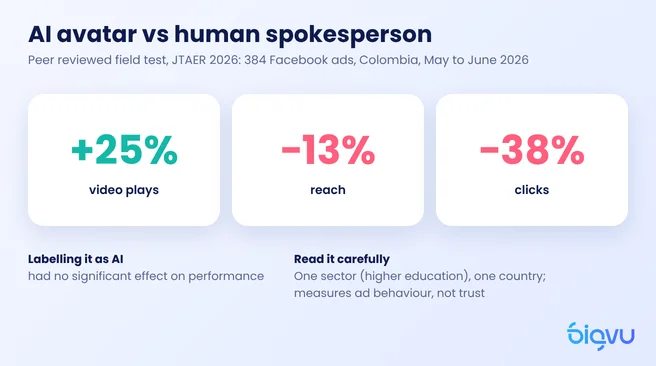
Uważaj tam, gdzie zaufanie jest wszystkim. Recenzowany test terenowy obejmujący 384 reklamy na Facebooku, opublikowany w 2026 roku w Journal of Theoretical and Applied Electronic Commerce Research, wykazał, że awatar AI zdobył o 25% więcej odtworzeń niż ludzki rzecznik, ale o 13% mniejszy zasięg i o 38% mniej kliknięć. Badanie dotyczyło reklam szkolnictwa wyższego w Kolumbii, więc traktuj je jako jeden punkt danych, a nie prawo. Mimo to pasuje do rady cytowanego wcześniej twórcy z YouTube: przy pracy dla klientów, marce opartej na stałej twarzy albo czymkolwiek, co płacący klient obejrzy klatka po klatce, poleca najbardziej realistyczne narzędzie, na jakie cię stać, albo prawdziwe nagranie.
Oznaczanie, zgoda i nowe przepisy
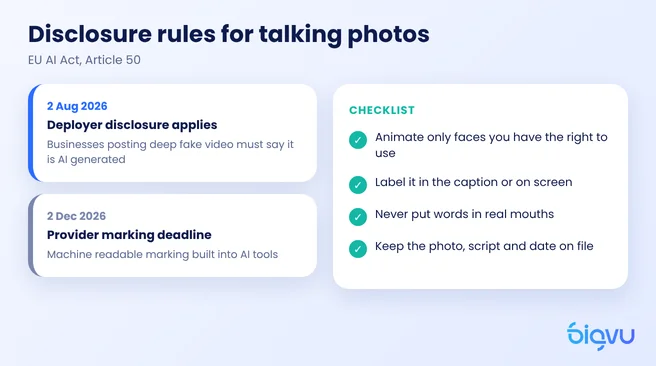
Etyka mówiących zdjęć była kiedyś kwestią dobrych manier. W Unii Europejskiej to teraz także obowiązek prawny. Artykuł 50 unijnego aktu w sprawie sztucznej inteligencji stanowi, że podmiot stosujący system AI, który generuje lub manipuluje wideo stanowiącym deepfake, musi ujawnić, że treść została sztucznie wygenerowana lub zmanipulowana, i to w jasny sposób najpóźniej wtedy, gdy widz zobaczy ją po raz pierwszy. Jak wyjaśniła kancelaria Morgan Lewis, te obowiązki przejrzystości obowiązują od 2 sierpnia 2026 roku. Osobny czteromiesięczny okres przejściowy, do 2 grudnia, dotyczy wyłącznie oznaczania czytelnego maszynowo, które muszą wbudować dostawcy, i nie odracza obowiązków firm publikujących filmy.
Prosta lista kontrolna
- Ożywiaj tylko twarze, do których masz prawo. Swoją albo osoby, która wyraźnie się zgodziła. Nigdy klienta, konkurenta ani celebryty bez zgody.
- Oznacz to. Krótka linijka w opisie lub na ekranie, na przykład „Ten film wykorzystuje mówiące zdjęcie AI”, spełnia podstawowy obowiązek i prawie nic nie kosztuje.
- Nie wkładaj słów w usta prawdziwych ludzi. Twoje mówiące zdjęcie czytające twój własny scenariusz to jedno. Sprawianie, że ktoś pozornie popiera coś, czego nigdy nie powiedział, to zupełnie co innego.
- Prowadź dokumentację. Zachowaj oryginalne zdjęcie, scenariusz i datę na wypadek, gdyby ktoś zapytał, jak powstał film.
Jeśli obawiasz się, że oznaczenie zaszkodzi wynikom, to samo badanie reklam na Facebooku uspokaja: informacja, że reklamę stworzono z pomocą AI, nie miała istotnego wpływu na wyniki. Tutaj uczciwość nic nie kosztuje.