브랜드가 아니라 듣는 사람에서 시작하세요
첫 번째 실수는 음성을 브랜드 색상처럼 다루는 것입니다. 하나를 골라 어디에나 쓰는 식이죠. 판매 페이지에서 신뢰를 주는 음성이 소셜 클립에서는 딱딱하게 들릴 수 있고, 숨 가쁜 광고 음성은 10분짜리 교육 자료에서는 피곤해집니다.
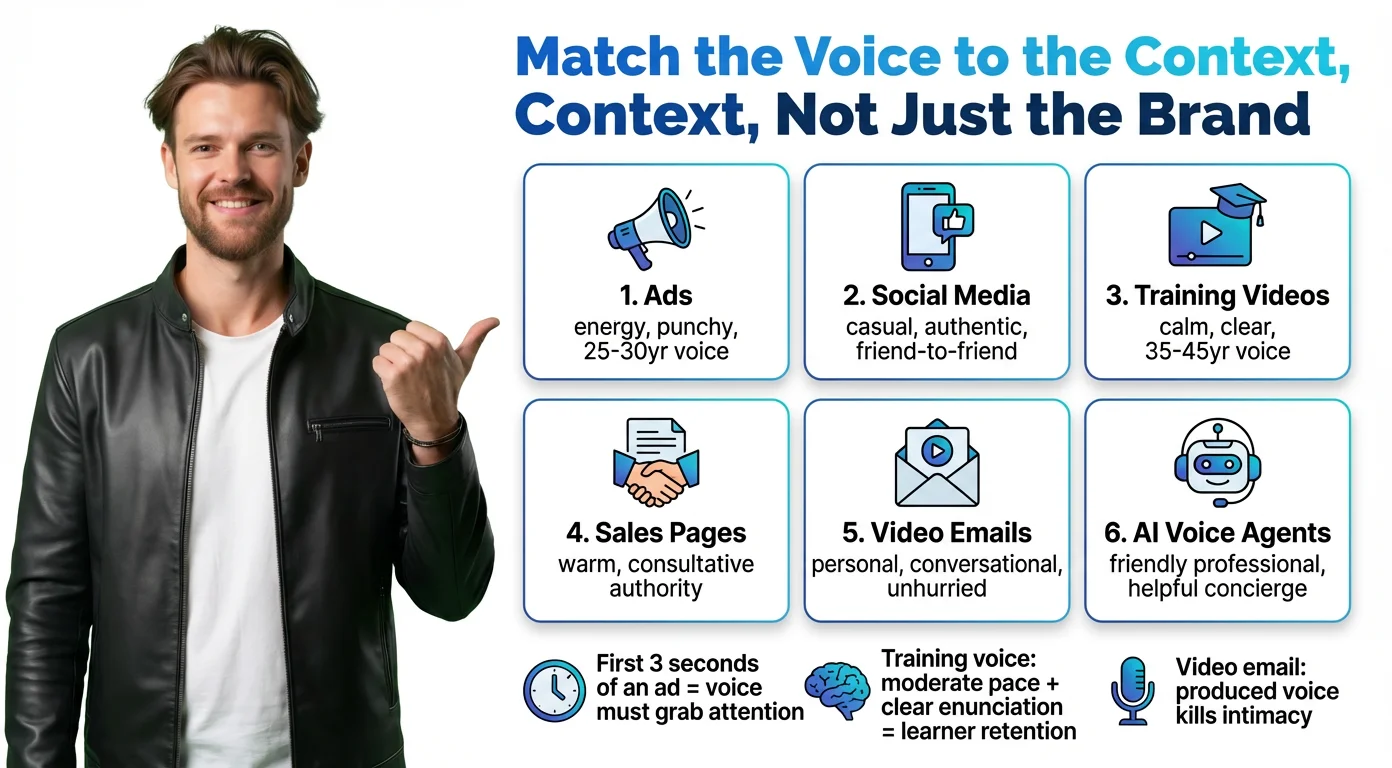
사용 목적에 따라 제가 음성을 이렇게 조정하겠습니다.
광고와 프로모션 콘텐츠
주의를 끄는 데 주어진 시간은 약 3초이므로 음성에 에너지와 추진력이 필요합니다. 20대 중반부터 30대 초반의 인물은 소비자 제품에 어울립니다. 더 깊고 안정적인 톤은 B2B나 프리미엄 브랜드에 맞습니다. 경쾌한 속도와 또렷한 전달을 요청하세요.
소셜 미디어 영상
소셜은 실제 사람이 친구에게 말하는 듯한 느낌에 보상합니다. 편안하고 직접적이며 약간 들뜬 톤이 좋습니다. 제작된 티가 나는 것은 모두 분위기를 깹니다. 대화체, 친근함, 자연스러운 속도를 요청하세요.
교육 및 설명 영상
더 오래 보게 되므로 개성보다 명료함이 중요합니다. 차분하고 절제되되 단조롭지 않게 말해야 합니다. 30대 중반부터 40대 중반의 인물은 거리감 없이 권위를 줍니다. 또렷한 발음, 적당한 속도, 따뜻하지만 안내하는 톤을 요청하세요.
판매 페이지와 랜딩 페이지
여기서는 신뢰를 쌓는 것이 일입니다. 음성은 해박한 조언자처럼, 자신 있고 따뜻하되 압박하지 않게 들려야 합니다. 연기처럼 느껴지는 것은 피하세요. 상담하는 톤, 부드러운 음색, 대화 속 권위를 요청하세요.
영상 이메일
영상 이메일의 핵심은 개인적으로 느껴진다는 점이고, 지나치게 연출된 음성은 한 문장 만에 그 느낌을 무너뜨립니다. 일대일 대화를 목표로 하세요. 따뜻하고 서두르지 않으며 자연스러운 쉼이 있어야 합니다.
AI 음성 에이전트 (웹사이트와 영상 랜딩 페이지)
이 음성은 방문자가 가장 먼저 듣는 브랜드 접점인 경우가 많습니다. 친절하고 도움이 되어야 합니다. 콜센터 대본보다는 아는 것이 많은 동료에 가까워야 합니다.
나이가 이 모든 것을 묶어 줍니다. 22세 음성이 컴플라이언스 교육을 낭독하면 어색하고, 55세 음성이 틱톡 광고에 나오면 겉돕니다. 음성 디자인에서 가장 덜 활용되는 레버 중 하나입니다.
"사람다움"이 구매자에게 정말 중요할까요? 한 공급업체 연구는 그 차이가 작다고 시사합니다. 영국의 오디오 광고 기업 Azerion은 2026년 3월과 4월에 청취자 3,000명을 대상으로 광고를 테스트했습니다. AI 버전을 들은 사람 중 29%만이 인공 음성이라고 정확히 답했고, 78%가 AI 음성이 자연스럽다는 데 동의했으며, 사람 음성은 75%였습니다. 이는 잘 알려진 두 브랜드에 대한 공급업체 결과일 뿐 보편 규칙이 아닙니다. 그래도 청취자가 먼저 전달 방식을 판단한다는 점은 보여 줍니다.

실제로 통하는 음성 프롬프트의 구조
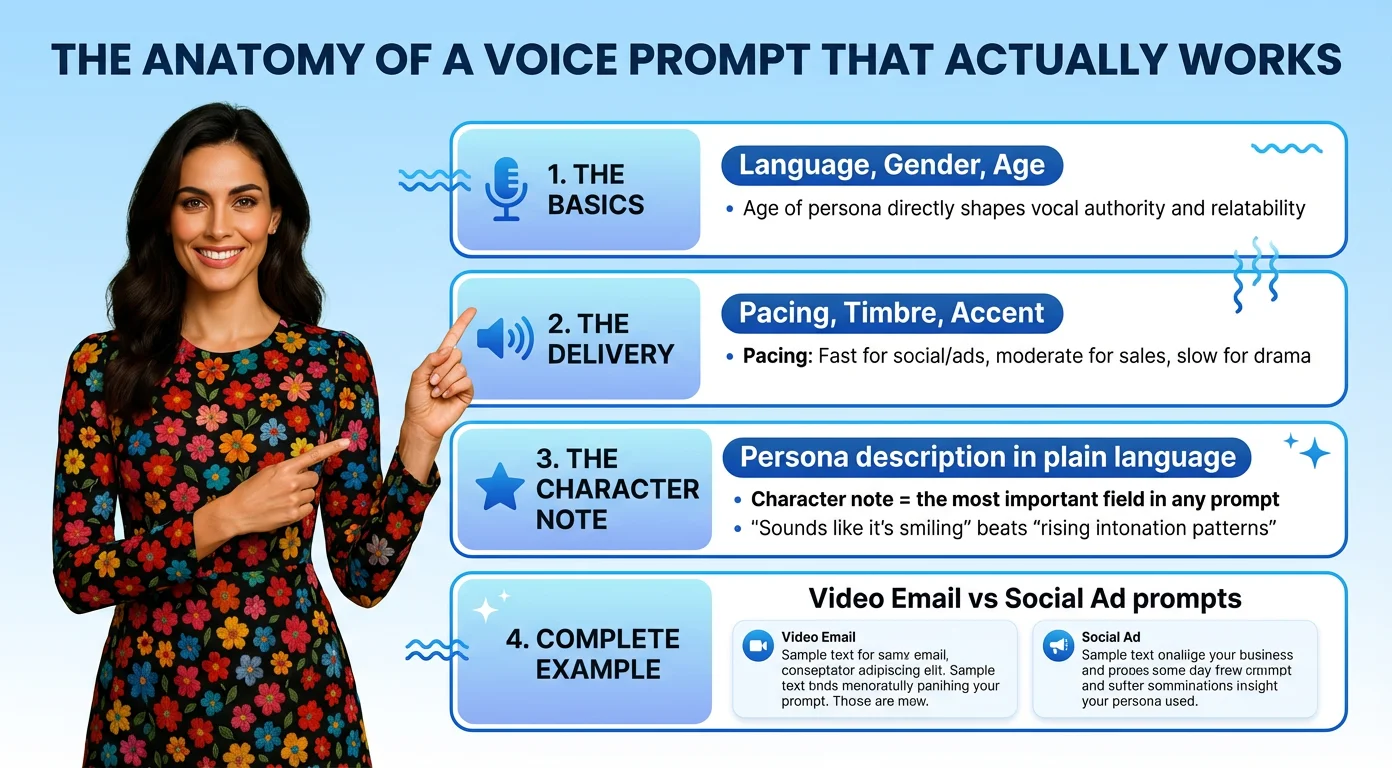
음성 프롬프트는 형용사 목록이 아닙니다. 서로 다른 두 사람이 읽어도 같은 화자를 떠올릴 만큼 구체적인 캐릭터 설명입니다.
강한 프롬프트에는 세 가지 층이 있습니다.
기본: 언어, 성별, 나이
이것이 바깥 한계를 정합니다. "여성, 30대 초반, 미국 영어"는 "여성"보다 훨씬 낫습니다. 나이는 음질, 에너지, 권위를 좌우하므로 모호하게 두지 마세요.
전달: 속도, 음색, 억양
속도는 에너지를 조절합니다. 소셜과 광고는 빠르게, 판매와 교육은 적당하게, 드라마는 느리게 합니다. 음색은 목소리의 질감입니다. 따뜻한, 밝은, 깊은, 허스키한, 매끄러운 등이 있습니다. 억양은 개성과 현지화를 더하며, 음성이 청중에게 자연스럽게 들릴지 약간 낯설게 들릴지를 가를 수 있습니다.
캐릭터 노트: 가장 중요한 항목
여기서 음성은 평범함에서 구체성으로 바뀝니다. 음향이 아니라 사람을 묘사하세요. "당신에게 말하면서 미소 짓는 것처럼 들린다"가 "상승 억양 패턴과 전방 근접감"보다 좋은 결과를 냅니다.
효과가 좋은 캐릭터 노트:
- 라디오 스타: 밝고 에너지가 높으며 세련됨. 광고와 프로모션용.
- 시네마틱 내레이터: 깊고 신중하며 극적임. 브랜드 스토리텔링용.
- 팟캐스트 진행자: 편안하고 따뜻하며 호기심 많음. 설명과 전문 의견용.
- 친절한 코치: 명확하고 격려하며 인내심 있음. 교육과 온보딩용.
- 심야 DJ: 부드럽고 낮고 친밀함. 럭셔리와 분위기 콘텐츠용.
- 뉴스 앵커: 또렷하고 중립적이며 권위 있음. 리포트와 업데이트용.
완성된 예시 두 가지
영상 이메일용: "따뜻하고 친근한 여성 음성, 30대 초반, 미국 영어, 적당한 속도. 대화하듯 다가가기 쉬운 톤으로, 커피 한 잔을 두고 동료가 유용한 조언을 나누는 것처럼. 전달에 옅은 미소. 전문적이지만 절대 딱딱하지 않게."
소셜 광고용: "에너지 넘치는 남성 음성, 20대 중반, 중립적인 미국 억양, 빠른 속도. 방금 멋진 것을 발견해 얼른 말해 주고 싶은 사람처럼 자신감 있고 들뜬 느낌. 밝은 음색, 또렷한 전달."
이 프롬프트들이 약한 프롬프트와 다른 점은 길이가 아닙니다. 매개변수만이 아니라 성격을 묘사한다는 점입니다.
BIGVU가 프롬프트를 2분 안에 브랜드 음성으로 바꾸는 방법
프롬프트를 쓰는 일은 전략적인 작업입니다. 음성을 생성하는 일은 매끄러워야 하고, BIGVU의 Voice Design 도구는 바로 그것을 위해 만들어졌습니다.
워크플로는 Brand Kit 안의 Branded Media 아래에 있으며 네 단계로 진행됩니다.
1단계: 매개변수 설정
Voice Design 화면에서 언어, 억양, 성별, 속도, 나이, 음색을 선택합니다. 이것은 기술적 입력, 즉 AI가 작업하는 틀입니다.
2단계: 캐릭터 노트 작성
중요한 프롬프트 입력란은 여기입니다. BIGVU는 이를 "추가 노트"라고 부르지만 캐스팅 브리프처럼 다루세요. "라디오 스타 에너지", "시네마틱하고 서서히 달아오르는", "아침 방송 진행자처럼 따뜻하고 재치 있는". 사양이 아니라 캐릭터를 쓰세요.
3단계: 세 가지 버전을 생성해 선택
BIGVU는 프롬프트를 세 가지로 다르게 해석해 만들어 줍니다. 샘플 대본으로 각각 들어 보고 느낌을 비교한 뒤 하나를 고르세요. 무엇이 생성되었는지 쉬운 말로 된 설명도 보이므로 무엇을 남기는지 알 수 있습니다.
4단계: 이름 짓고 저장
음성에 이름을 지어 주고(BIGVU가 언어와 문화적 맥락에 맞는 이름을 제안할 수 있습니다), 설명을 확인한 뒤 저장합니다. 음성은 곧바로 Content Bank에 추가되며, AI가 생성한 인물 이미지(얼굴, 상반신, 전신)가 영상 제작용으로 함께 준비됩니다.
전체 과정은 2분도 걸리지 않습니다. 캐스팅도, 스튜디오도, 성우도 필요 없습니다. 음성은 내 것이고 저장되어 모든 영상에서 다시 쓸 수 있습니다.
같은 워크플로가 모든 언어에 적용됩니다. 브라질용 따뜻한 포르투갈어 음성, 도쿄용 전문적인 일본어 음성, 중남미 소셜용 빠른 스페인어 음성까지, 언어와 억양과 문화 노트만 바꾸면 결과가 맞춰집니다.

낭독 연출하기: 오디오 태그, 쉼, 그리고 대본 자체
좋은 음성은 절반의 일입니다. 나머지 절반은 대사를 어떻게 전달하느냐이며, 여기서는 도구마다 마케팅이 인정하는 것보다 차이가 큽니다.
ElevenLabs v4의 오디오 태그
ElevenLabs는 Eleven v4와 Eleven v3가 오디오 태그를 지원한다고 밝힙니다. 전달이 바뀌어야 할 곳에 대괄호로 넣는 짧은 지시입니다. 도움말 센터에는 [curious], [whispers], [laughs], [clears throat] 같은 예시가 있습니다. 문서의 실용적인 세부 사항 하나: Eleven v4와 v3는 SSML 휴지 태그를 지원하지 않으므로 쉼은 [pause], [long pause] 같은 태그나 문장부호로 만듭니다. ElevenLabs 자체 예시에서 같은 짧은 문장이 [pause] 태그 없이 4초, 있을 때 6초 걸렸습니다.
ElevenLabs 공식 채널의 튜토리얼은 유용한 작업 방식을 더합니다. 한 줄에 태그를 쌓으세요. 예를 들어 긴장한 시작, 헛기침, 그리고 한 단어에서 속삭임입니다. 긴 대본에서는 Auto tag 버튼이 텍스트를 훑고 맥락에 따라 태그를 추가합니다. 그래도 태그가 빗나가면 직접 그 대사를 녹음해 Voice Changer를 사용하세요. "녹음에서 원하는 전달에 가까워질수록 결과도 가까워지기" 때문입니다(영어 인용문의 번역).
다른 도구의 일상 언어 지시
다른 도구는 다른 길을 택합니다. OpenAI의 텍스트 음성 변환 가이드는 "Speak in a cheerful and positive tone." 같은 예시가 있는 지시 입력란을 씁니다. 다만 의존하기 전에 날짜를 확인하세요. OpenAI 문서는 tts 1, tts 1 hd, gpt 4o mini tts 모델이 "지원 중단되었으며 2027년 1월 6일에 종료됩니다"라고 밝힙니다(영어 번역). Google은 Gemini 3.8 텍스트 음성 변환이 직접 연출 지시를 쓰고 |mhm| 같은 신호를 넣어 대화의 질감을 더할 수 있게 한다고 말합니다. Hume의 Octave 가이드는 어디에나 통하는 원칙을 짚습니다. 표현이 풍부한 입력 텍스트를 쓰면 더 풍부한 음성이 나오고, 단어를 대문자로 쓰면 더 강한 강조가 됩니다.
대본이 생각보다 더 중요합니다
YouTube 영상 조회수가 735,000회를 넘는 크리에이터 Isaac은 사람처럼 들리는 AI 음성을 네 가지로 압축합니다. 톤의 변화, 쉼, 강조, 그리고 ChatGPT에서 그대로 가져오지 않은 대본입니다. 또한 대본 전체가 아니라 몇 문장씩 생성합니다. 어떤 음성 도구에도 통하고 비용도 들지 않는 조언입니다.
솔직한 반론: 태그는 믿을 만하지 않습니다
태그가 매번 말을 듣는다고 기대하지 마세요. Unite.AI의 리뷰어 Janine Heinrichs는 2026년 9월 "가장 큰 약점은 퍼포먼스 태그를 일관되지 않게 따른다는 점이었다"고 썼습니다(영어 번역). Isaac은 자신의 클론에 v3 태그를 추가하면 "음성 자체가 약간 바뀐다"는 것을 알게 되어 안정성을 낮춘 v2로 돌아갔습니다. 그의 영상은 v4 이전이므로 그 불만은 지금은 해당되지 않을 수 있습니다. 실용적인 답은 태그를 적게 쓰고, 영향을 줄 단어 바로 앞에 놓고, 매번 들어 보는 것입니다.
성능 주장에 대해 한 가지 더 주의할 점이 있습니다. ElevenLabs는 Eleven v4가 Artificial Analysis에서 1위로 평가되었고 블라인드 테스트에서 청취자의 약 75%가 선호했다고 말합니다. 이는 ElevenLabs 자체 수치이며, Google도 다른 벤치마크에서 Gemini 3.8의 1위를 주장합니다. 직접 쓰는 대본으로 시험해 보세요.
흔한 프롬프트 실수, 그리고 사람 같음이 숨김을 뜻하지 않는 이유
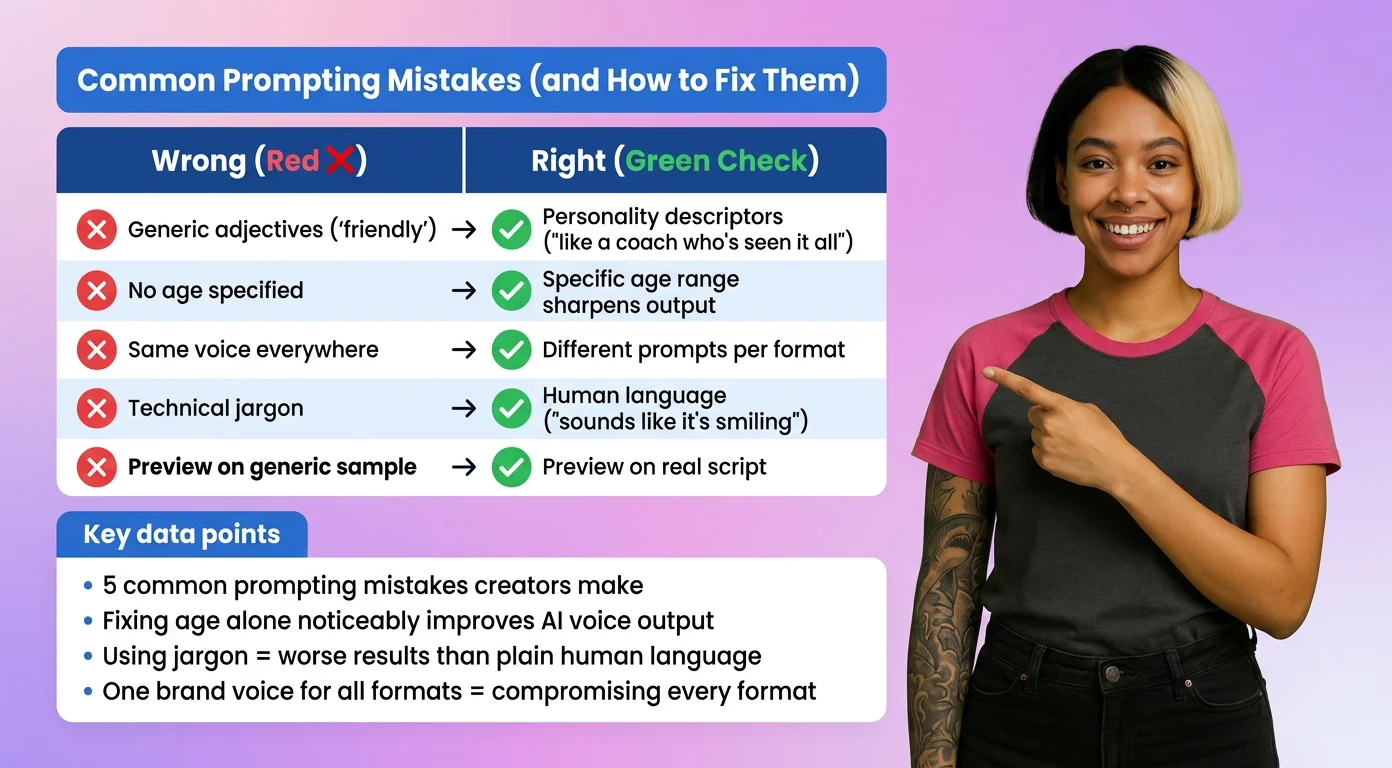
빗나가는 음성의 대부분은 같은 몇 가지 이유로 실패합니다.
일반적인 형용사만 쓰기
"전문적인", "친근한", "명확한". 괜찮은 음성이라면 모두 그렇기 때문에 이런 단어는 AI에게 거의 아무것도 주지 않습니다. 개성으로 바꾸세요. "모든 것을 겪어 봤지만 여전히 돕는 일에 신나는 노련한 코치처럼".
나이를 건너뛰기
나이 기준이 없으면 음성은 중간으로 수렴하며, 대개 무난하지만 훌륭하기는 어렵습니다. 범위를 적어 주면 결과가 또렷해집니다.
모든 곳에 같은 음성 쓰기
모든 형식에 하나의 브랜드 음성을 쓰면 어느 것도 잘 살리지 못합니다. 판매 페이지, 소셜 클립, 온보딩 영상은 맡은 일이 다릅니다. 서로 다른 프롬프트 변형을 주세요.
묘사 대신 전문 용어 쓰기
"운율 변화"나 "보컬 프라이"는 정확할 수 있지만 모델은 사람의 언어에 더 잘 반응합니다. 듣는 경험을 묘사하세요. "미소 짓는 것처럼 들린다"가 "상승 변조가 있는 높은 음높이"를 이깁니다.
실제 대본으로 미리 듣기 건너뛰기
음성은 샘플 문장에서는 빛나도 실제 문구에서는 힘을 잃을 수 있습니다. 낭독할 대본의 한두 줄로 들어 보세요.
사람인 척하려 하기
이것은 실용의 문제인 만큼 윤리의 문제입니다. OpenAI 사용 정책은 "최종 사용자에게 듣고 있는 TTS 음성이 AI로 생성되었음을 분명히 알릴 것을 요구합니다"(영어 번역). 2026년 Adobe가 미국 소비자 850명을 조사한 결과 88%가 음성을 듣고 AI인지 궁금해한 적이 있었고, 77%는 여전히 사람 음성을 가장 신뢰했습니다. Adobe는 AI 오디오 도구를 판매하므로 공급업체 연구로 읽으세요. "사람처럼 들리게"의 합리적인 해석은 자연스럽고 따뜻하며 속도가 좋은 전달이지, 기계가 말한다는 사실을 숨기는 것이 아닙니다.
클론은 판돈을 높입니다. 2025년 PLOS One 연구는 청취자가 음성 클론과 실제 사람 음성을 안정적으로 구별하지 못했지만 일반 AI 음성은 알아챘다고 밝혔습니다. 표본은 실험당 50명으로 작았지만 교훈은 분명합니다. 음성이 사람을 속일 수 있다면 알리세요.