
מה באמת קורה כשתמונה לומדת לדבר
מאחורי הקלעים, רוב הכלים ליצירת תמונה מדברת AI מריצים גרסה של אותו תהליך. בשרשור ב r/generativeAI משתמשים מתארים אותו בשני שלבים: קודם מודל לשחזור פנים מעניק לתמונה הסטטית תנועה טבעית, ואחר כך מודל סנכרון שפתיים שמונע על ידי האודיו מעצב מחדש את הפה כך שיתאים לכל צליל בפסקול. השמות בקוד פתוח שעולים הכי הרבה הם SadTalker ו LivePortrait לתנועה ו Wav2Lip לפה, בעוד D-ID ו HeyGen אורזות שלבים דומים כמוצר.
למה הפה הוא החלק הקשה ביותר
החוקרים שמאחורי MuseTalk, מודל לסנכרון שפתיים שתואר במאמר ב arXiv, מתארים את הבעיה כמשולש של פשרות. שיטות מבוססות דיפוזיה נראות מצוין אבל יקרות להרצה. שיטות GAN מהירות יותר בדרך כלל מקריבות את דיוק השפתיים או את "פרטי השיניים", דרך אקדמית מנומסת לומר שהשיניים נמרחות. MuseTalk עובד במרחב סמוי דחוס כדי להשיג גם מהירות וגם פרטים, ומדווח על 30 פריימים בשנייה ברזולוציה של 256 על 256 פיקסלים בכרטיס גרפי אחד מסוג NVIDIA V100.
כדאי לזכור את נתון הרזולוציה הזה. המודל מצייר מחדש רק אזור קטן סביב הפה, ואז ממזג אותו בחזרה לתמונה בגודל מלא. כשהפנים קטנות, מופנות הצידה או מוארות חלש, יש פחות פרטים אמיתיים לעבוד איתם, ושם האשליה בדרך כלל נשברת.
על מה להסתכל כשבודקים
יוצר תוכן שהשווה את HeyGen לכלי זול יותר במבחן השוואה ביוטיוב נותן רשימה שימושית: הסתכלו על זוויות הפה, שימו לב מה הראש עושה כשמשפט נגמר, והקשיבו לעיצורים חזקים כמו P ו B, כי שם "כלי סנכרון שפתיים זולים בדרך כלל מתפרקים לגמרי".
התמונה שאתם מעלים קובעת את רוב התוצאה
כל פלטפורמה יכולה להנפיש רק את מה שיש בתמונה, ולכן תמונת המקור שווה יותר תשומת לב מההגדרות. העצות של אנשים שמכינים סרטונים כאלה כל שבוע דומות מאוד.
- הביטו ישר למצלמה. מדריך של Hedra מפברואר 2026 ממליץ על תמונה חדה, עם פנים שמופנות ישר אל העדשה ותאורה טובה, ואוסר על תמונות פרופיל ועל תמונות מטושטשות. הוא גם מציין ש Hedra דוחה תמונות קטנות מ 300 פיקסלים.
- התחילו מהבעה ניטרלית. אותו מדריך מציע הבעה ניטרלית אם התוצאה נראית נוקשה, יחד עם תאורה טובה יותר ואודיו נקי, כי אודיו ברור "משפר את דיוק סנכרון השפתיים".
- שמרו על קטעים קצרים. "קטעים קצרים נראים מציאותיים יותר", נכתב במדריך. פצלו תסריט ארוך לכמה סרטונים קצרים במקום טייק ארוך אחד.
- הנמיכו את התנועה. יוצרת שבנתה אווטאר מתמונה אחת במדריך ה HeyGen שלה הוסיפה הנחיית תנועה ייעודית שמבקשת מראה טבעי, מעט שיניים גלויות ובלי ידיים, כי בהגדרות ברירת המחדל הדמות עלולה להיות אקספרסיבית מדי.
- תנו יותר מתמונה אחת אם אפשר. HeyGen ממליצה להעלות עוד כמה תמונות שלכם כדי שהמודל יקלוט יותר פרטים.
הקול חשוב בדיוק כמו הפנים. פסקול שטוח וממהר יגרום גם לפה מושלם להיראות לא נכון. כתבו את התסריט כדי שייאמר בקול, הקריאו אותו פעם אחת, ומחקו כל משפט שנתקעתם בו לפני שאתם מפיקים משהו.
BIGVU מול HeyGen מול Hedra: מה כל אחד נותן לכם
שלושתם הופכים תמונה לאווטאר מדבר, אבל הם נבנו לקונים שונים. הנה מה שכל ספק מציג היום בעמודים שלו.
BIGVU AI Talking Photo
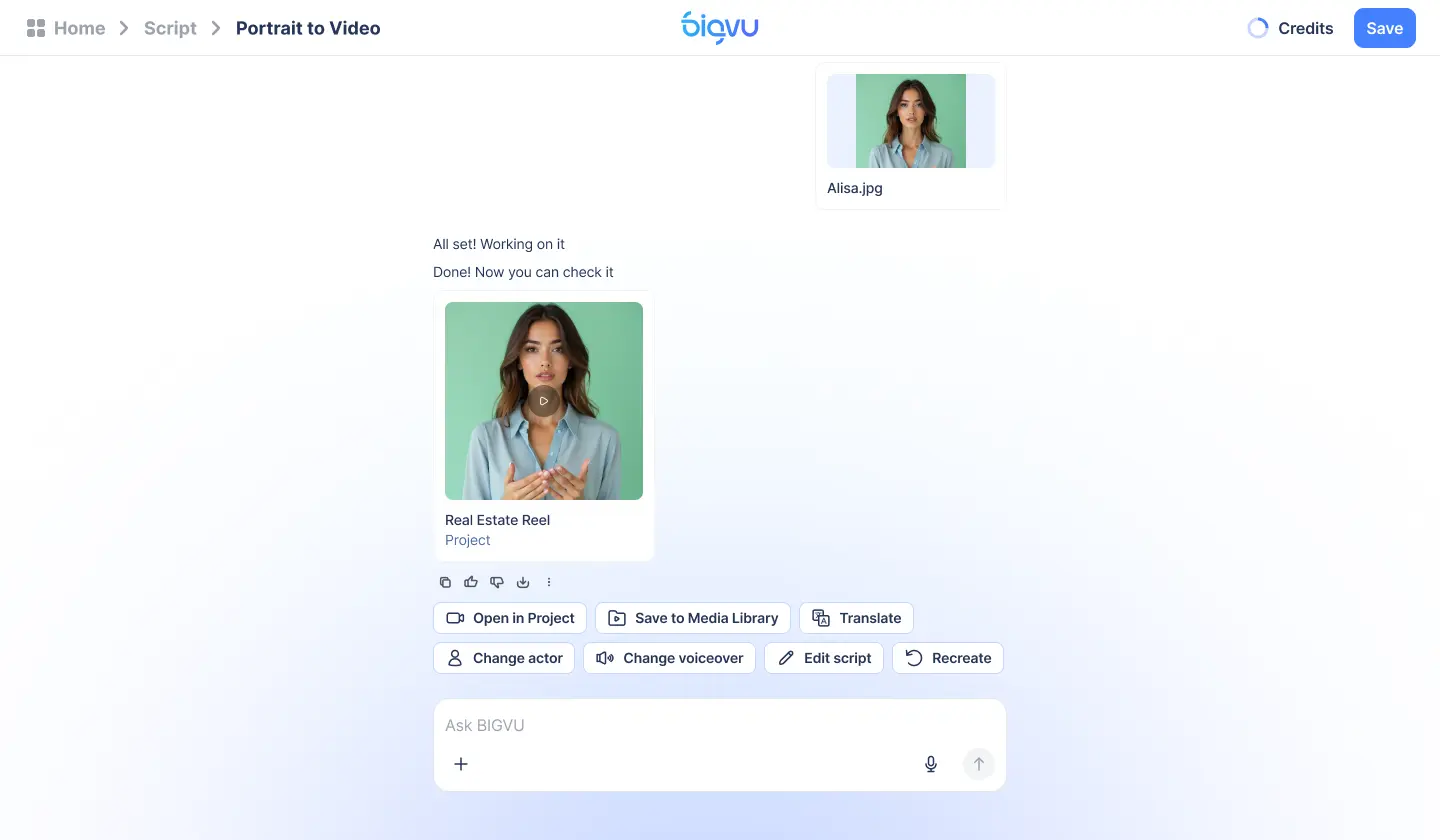
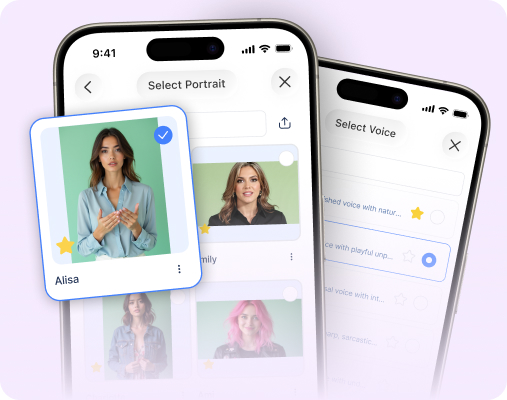
AI Talking Photo של BIGVU עובד בשלושה שלבים: מעלים תמונת פנים, מוסיפים תסריט וקול, ואז מפיקים את הסרטון ומפרסמים. אפשר לכתוב את התסריט בעצמכם או לנסח טיוטה עם AI Script Generator, ואז לבחור קול מהספרייה של BIGVU או לשכפל את הקול שלכם. הסרטון המסונכרן נשאר באותה אפליקציה לכתוביות, לערכת המותג שלכם ולפרסום, ואפשר לעבוד מהדפדפן, מ iPhone או מ Android. יכולות ה AI משתמשות בקרדיטים חודשיים, ועמוד המחירים מתרגם אותם לאורך סרטון: 500 הקרדיטים בתוכנית החינמית מספיקים לסרטון אנכי של כ 10 שניות, ו 3,000 הקרדיטים ב AI Pro מספיקים לכדקה.
HeyGen Photo Avatar
עמוד אווטאר התמונה של HeyGen מציג תמונות מדברות ביותר מ 175 שפות וניבים, הנחיות טקסט וחבילות סגנון שמחליפות את הלבוש או הרקע שלכם, ומנוע Avatar IV שהופך תמונה אחת לסרטון עם קול מסונכרן ותנועות ידיים. בעמוד המחירים התוכנית החינמית נותנת 3 סרטונים בחודש עם סימן מים ועד דקה לסרטון, Creator עולה 29 דולר לחודש עם 600 קרדיטים, ו Pro עולה 49 דולר לחודש עם 1,000 קרדיטים וסרטונים של עד 30 דקות.
Hedra
המחירון של Hedra הוא המפורט מבין השלושה. דרך ה API, יצירת אווטאר וסנכרון שפתיים מתחילים מ 2.5 סנט לשנייה מתוך יתרה דולרית בתשלום מראש, בלי מנוי, ושכפול קול הוא בחינם. אם אתם מעדיפים את אפליקציית Studio, התוכניות נעות בין Basic ב 20 דולר לחודש עבור 2,000 קרדיטים, Pro ב 50 דולר עבור 7,200 קרדיטים ו Ultra ב 100 דולר עבור 18,000 קרדיטים.
הכי טוב או הכי משתלם
היוצר שמאחורי מבחן ההשוואה ישיר: HeyGen מנצחת בריאליזם, "זה אפילו לא קרוב", ובכל זאת הוא משתמש בכלי הזול יותר לעיתים קרובות יותר, כי האווטאר שלו רק פותח את הסרטון ל 60 עד 80 שניות לפני שהקלטות מסך תופסות את מקומו. הכלל שלו נכון לכל כלי וידאו AI כאלה. אם הפנים הן המוצר, שלמו על האפשרות הכי מציאותית. אם הפנים הן רק פתיח קצר, טוב מספיק זה מספיק.
איפה תמונות מדברות מצדיקות את עצמן, ואיפה לא
תמונות מדברות זורחות בהודעות חוזרות שצריכות פנים אבל לא צוות צילום. BIGVU מונה עדכוני שוק, עדכוני נכסים למכירה, סקירות שכונה, שאלות נפוצות, מבצעים, הודעות פנימיות והסברים על מוצרים כשימושים נפוצים, והמכנה המשותף הוא חזרתיות. עם תמונת פנים מאושרת אחת אפשר להפיק את העדכון החמישי החודש בלי לתאם זמן עם אף אחד.
שימושים מתאימים
- פתיחים קצרים ועדכונים קבועים. פנים מוכרות בדקה הראשונה, ואז שקפים, הדגמה או צילומי הנכס.
- שיווק בדוא"ל עם וידאו. ברכה אישית בראש מייל מעקב מרגישה חמה יותר מטקסט בלבד. כלי הווידאו במייל של BIGVU מאפשר לשלוח אותה מאותו חשבון.
- נכסים בלי יום צילום. סוכני נדל"ן יכולים לשלב פתיח של תמונה מדברת עם Fototale, שהופך תמונות קיימות של הנכס לסרטון עם תנועות פאן, זום ומעברים.
שימושים חלשים
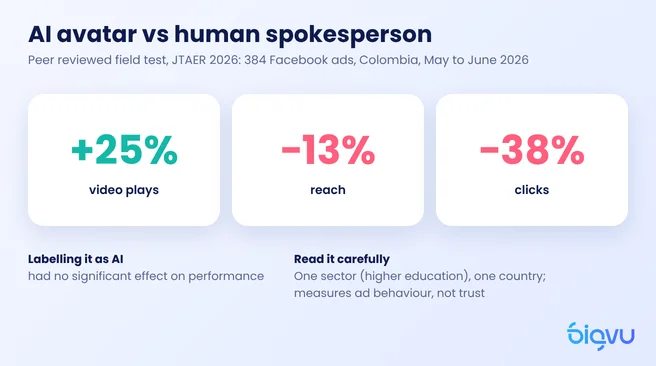
היזהרו במקומות שבהם האמון הוא הכול. ניסוי שטח שעבר ביקורת עמיתים על 384 מודעות Facebook, שפורסם ב 2026 בJournal of Theoretical and Applied Electronic Commerce Research, מצא שאווטארים של AI קיבלו 25% יותר צפיות בווידאו מדובר אנושי, אבל 13% פחות חשיפה ו 38% פחות קליקים. המחקר בחן מודעות של השכלה גבוהה בקולומביה, אז התייחסו אליו כנקודת נתונים אחת ולא כחוק. ובכל זאת, הוא תואם את העצה של יוצר היוטיוב שצוטט קודם: לעבודה עבור לקוחות, למותג עם פנים קבועות או לכל דבר שלקוחות משלמים יבחנו פריים אחר פריים, הוא ממליץ על הכלי הכי מציאותי שאתם יכולים להרשות לעצמכם, או על צילום אמיתי.
גילוי, הסכמה והכללים החדשים
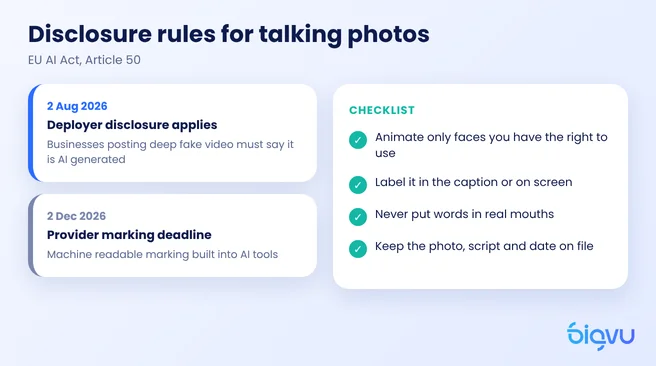
האתיקה של תמונות מדברות הייתה פעם עניין של נימוס. באיחוד האירופי היא עכשיו גם חובה חוקית. סעיף 50 של חוק ה AI של האיחוד האירופי קובע שמי שמשתמש במערכת AI שמייצרת או משנה וידאו המהווה דיפפייק חייב לגלות שהתוכן נוצר או שונה באופן מלאכותי, ושהדבר צריך להיות ברור לכל המאוחר ברגע שהצופה רואה אותו לראשונה. כפי שMorgan Lewis מסבירים, חובות השקיפות האלה חלות מ 2 באוגוסט 2026. תקופת מעבר נפרדת של ארבעה חודשים, עד 2 בדצמבר, חלה רק על הסימון הקריא למכונה שספקים צריכים לבנות, והיא לא דוחה את החובה של עסקים שמפרסמים סרטונים.
רשימת בדיקה פשוטה
- הנפישו רק פנים שמותר לכם להשתמש בהן. הפנים שלכם, או של מי שנתן אישור מפורש. לעולם לא פנים של לקוח, מתחרה או ידוען בלי הסכמה.
- סמנו את זה. שורה קצרה בכיתוב או על המסך, כמו "בסרטון זה נעשה שימוש בתמונה מדברת AI", עומדת בחובה הבסיסית וכמעט לא עולה כלום.
- אל תשימו מילים בפיו של אדם אמיתי. תמונה מדברת שלכם שמקריאה תסריט שלכם זה דבר אחד. לגרום למישהו להיראות כאילו הוא תומך במשהו שמעולם לא אמר זה דבר אחר לגמרי.
- שמרו תיעוד. שמרו את התמונה המקורית, את התסריט ואת התאריך, למקרה שמישהו ישאל איך נוצר סרטון.
אם אתם חוששים שהסימון יפגע בתוצאות, אותו מחקר על מודעות Facebook מרגיע: כשסיפרו לצופים שהמודעה נוצרה עם AI, לא הייתה לכך השפעה מובהקת על הביצועים. כאן, הכנות לא עולה כלום.