מתחילים מהמאזין, לא מהמותג
הטעות הראשונה היא להתייחס לקול כמו לצבע מותג: בוחרים אחד ומשתמשים בו בכל מקום. קול שבונה אמון בדף מכירה עלול להישמע נוקשה בקליפ ברשת חברתית, וקול פרסומת חסר נשימה מתיש אחרי עשר דקות של חומר הדרכה.
כך הייתי משנה את הקול לפי שימוש.
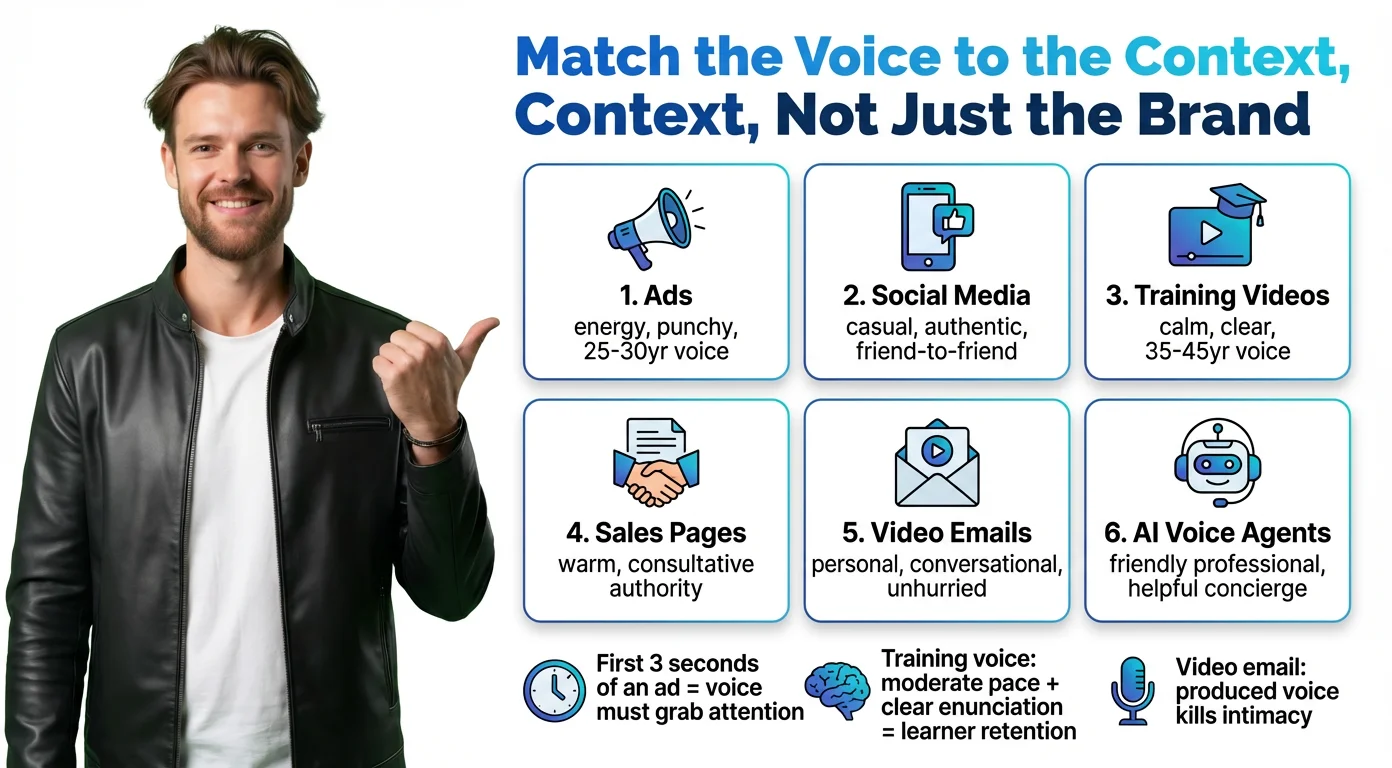
פרסומות ותוכן שיווקי
יש לכם בערך שלוש שניות לרכוש תשומת לב, ולכן הקול צריך אנרגיה ותנופה. דמות בגיל אמצע שנות העשרים עד תחילת שנות השלושים מתאימה למוצרי צריכה. טון עמוק ויציב יותר מתאים ל B2B או למותגי פרימיום. בקשו קצב נמרץ ומסירה חדה.
סרטונים לרשתות חברתיות
הרשתות החברתיות מתגמלות תחושה של אדם אמיתי שמדבר עם חבר. רגוע, ישיר, קצת נלהב. כל מה שנשמע מופק שובר את הקסם. בקשו טון שיחתי, קרוב וקצב טבעי.
סרטוני הדרכה והסבר
עוקבים אחריהם לאורך זמן, ולכן בהירות חשובה יותר מאישיות. רגוע ומאופק בלי להפוך לשטוח. דמות בגיל אמצע שנות השלושים עד אמצע שנות הארבעים נותנת סמכות בלי ריחוק. בקשו דיבור ברור, קצב מתון, חם אך מדריך.
דפי מכירה ודפי נחיתה
כאן העבודה היא לבנות אמון. הקול צריך להישמע כמו יועץ בקיא, בטוח וחם, בלי לחץ. הימנעו מכל מה שמרגיש כמו משחק. בקשו טון ייעוצי, גוון חלק וסמכות שיחתית.
מיילים בווידאו
כל הרעיון של מייל וידאו הוא שהוא מרגיש אישי, וקול מופק יתר על המידה הורס את זה במשפט אחד. כוונו לשיחה אחד על אחד: חמה, לא ממהרת, עם הפסקות טבעיות.
סוכני קול מבוססי AI (אתר ודפי נחיתה עם וידאו)
הקול הזה הוא לעיתים קרובות נקודת המגע הראשונה של מותג שמבקר שומע. הוא צריך להיות ידידותי ועוזר: פחות תסריט של מוקד טלפוני, יותר עמית בקיא.
הגיל מחבר את הכול. קול בן 22 שמקריא מודול ציות מרגיש לא נכון, וקול בן 55 בפרסומת בטיקטוק מרגיש מנותק. זו אחת הידיות הכי פחות מנוצלות בעיצוב קול.
האם ה"אנושי" באמת חשוב לקונים? מחקר של ספק מרמז שהפער קטן. Azerion, חברת פרסום אודיו בריטית, בדקה מודעות עם 3,000 מאזינים במרץ ובאפריל 2026. רק 29% מאלה ששמעו את גרסת ה AI זיהו נכון שהיא מלאכותית, ו 78% הסכימו שהקול הממוחשב נשמע טבעי, לעומת 75% לקול האנושי. התייחסו לזה כתוצאה של ספק עבור שני מותגים מוכרים, לא ככלל אוניברסלי. ובכל זאת, זה מראה שמאזינים שופטים קודם כול את המסירה.

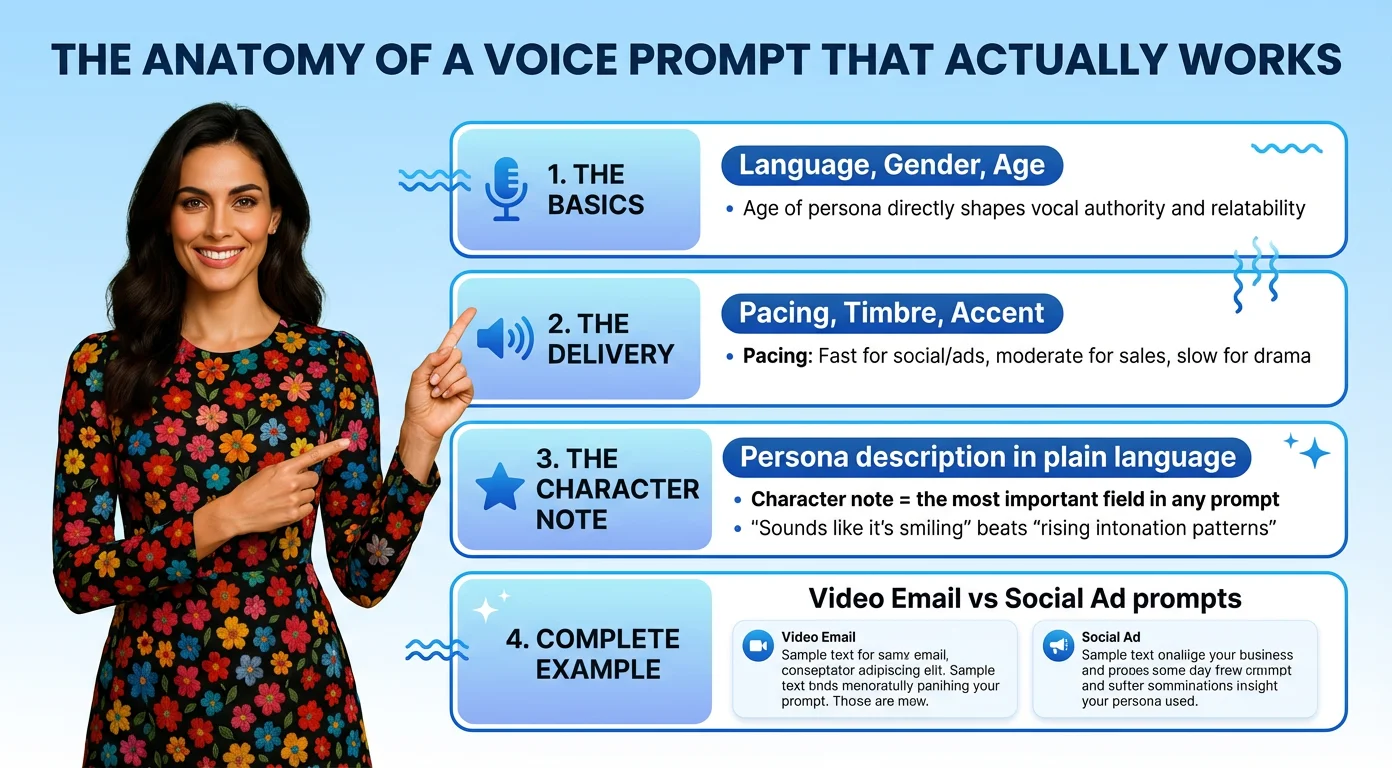
האנטומיה של הנחיה קולית שבאמת עובדת
הנחיה קולית אינה רשימת שמות תואר. היא תיאור של דמות, מספיק מדויק כך ששני אנשים שונים שקוראים אותה ידמיינו את אותו דובר.
להנחיות חזקות יש שלוש שכבות.
הבסיס: שפה, מגדר וגיל
אלה קובעים את הגבולות החיצוניים. "אישה, תחילת שנות השלושים, אנגלית אמריקאית" עדיפה בהרבה על "אישה". הגיל מעצב איכות קול, אנרגיה וסמכות, אז אל תשאירו אותו עמום.
המסירה: קצב, גוון ומבטא
הקצב שולט באנרגיה: מהיר לרשתות ולפרסומות, מתון למכירה והדרכה, איטי לדרמה. הגוון הוא המרקם של הקול: חם, בהיר, עמוק, צרוד, חלק. המבטא מוסיף אופי והתאמה מקומית, ויכול להכריע אם קול מרגיש מקומי לקהל שלכם או מעט זר.
הערת האופי: השדה החשוב ביותר
כאן הקול עובר מגנרי לספציפי. תארו את האדם, לא את האקוסטיקה. "נשמעת כאילו היא מחייכת תוך כדי שהיא מדברת איתך" נותן תוצאה טובה יותר מ"דפוסי אינטונציה עולה עם קרבה חזיתית".
הערות אופי שנוטות לעבוד:
- כוכב רדיו: בהיר, אנרגטי מאוד, מלוטש. פרסומות וקידום.
- מספר קולנועי: עמוק, מכוון, דרמטי. סיפור מותג.
- מגיש פודקאסט: רגוע, חם, סקרן. הסברים ומנהיגות מחשבתית.
- מאמן ידידותי: ברור, מעודד, סבלני. הדרכה וקליטה.
- דיג'יי לילה: חלק, נמוך, אינטימי. יוקרה ותוכן אווירתי.
- קריין חדשות: חד, ניטרלי, סמכותי. דוחות ועדכונים.
שתי דוגמאות שלמות
למייל וידאו: "קול נשי חם וידידותי, תחילת שנות השלושים, אנגלית אמריקאית, קצב מתון. שיחתי ונגיש, כמו עמיתה שחולקת עצה שימושית על כוס קפה. חיוך קל במסירה. מקצועית אבל לעולם לא נוקשה."
למודעה ברשת חברתית: "קול גברי אנרגטי, אמצע שנות העשרים, מבטא אמריקאי ניטרלי, קצב מהיר. בטוח ונלהב, כמו מי שזה עתה גילה משהו נהדר ולא יכול לחכות לספר לך. גוון בהיר, מסירה חדה."
מה שמבדיל בין ההנחיות האלה להנחיה חלשה הוא לא האורך. הן מתארות אישיות, לא רק פרמטרים.
איך BIGVU הופכת הנחיה לקול מותג בפחות מ 2 דקות
כתיבת ההנחיה היא העבודה האסטרטגית. יצירת הקול צריכה להיות חלקה, ולשם כך נבנה כלי Voice Design של BIGVU.
התהליך נמצא בתוך ה Brand Kit, תחת Branded Media. הוא רץ בארבעה שלבים.
שלב 1: קבעו את הפרמטרים
בחרו שפה, מבטא, מגדר, קצב, גיל וגוון בממשק Voice Design. אלה הקלטים הטכניים שלכם, המסגרת שבתוכה ה AI עובד.
שלב 2: כתבו את הערת האופי
זה שדה ההנחיה שחשוב. BIGVU קוראת לו "הערות נוספות", אבל התייחסו אליו כאל בריף ליהוק. "אנרגיה של כוכב רדיו", "קולנועי ובוער לאט", "חם ומצחיק כמו מגישת תוכנית בוקר". כתבו את הדמות, לא את המפרט.
שלב 3: צרו שלוש וריאציות ובחרו
BIGVU מפיקה שלוש פרשנויות שונות להנחיה שלכם. האזינו לכל אחת עם תסריט לדוגמה, השוו איך הן נשמעות ובחרו אחת. תראו גם תיאור בשפה פשוטה של מה שנוצר, כך שתדעו מה אתם שומרים.
שלב 4: תנו שם ושמרו
תנו לקול שם (BIGVU יכולה להציע אחד לפי השפה וההקשר התרבותי), בדקו את התיאור ושמרו. הקול נכנס ישר ל Content Bank שלכם, עם תמונות דיוקן שנוצרו ב AI (פנים, פלג גוף, גוף מלא) מוכנות להפקת וידאו.
כל התהליך לוקח פחות משתי דקות. בלי ליהוק, בלי אולפן, בלי שחקן קול. הקול שלכם, שמור וניתן לשימוש חוזר בכל סרטון.
אותו תהליך חל בכל שפה. קול פורטוגזי חם לברזיל, קול יפני מקצועי לטוקיו, קול ספרדי מהיר לרשתות באמריקה הלטינית: שנו שפה, מבטא והערות תרבותיות, והתוצאה מסתגלת.

לביים את ההקראה: תגיות שמע, הפסקות והתסריט עצמו
קול טוב הוא חצי מהעבודה. החצי השני הוא איך המשפט נמסר, וכאן הכלים נבדלים יותר ממה שהשיווק שלהם מודה.
תגיות שמע ב ElevenLabs v4
ElevenLabs אומרת ש Eleven v4 ו Eleven v3 תומכים בתגיות שמע: הוראה קצרה בסוגריים מרובעים, שממוקמת במקום שבו המסירה צריכה להשתנות. מרכז העזרה שלה מציג דוגמאות כמו [curious], [whispers], [laughs] ו [clears throat]. פרט מעשי מהתיעוד: Eleven v4 ו v3 אינם תומכים בתגיות הפסקה של SSML, ולכן הפסקות נוצרות מתגיות כמו [pause] ו [long pause], או מסימני פיסוק. בדוגמה של ElevenLabs עצמה, אותו משפט קצר ארך ארבע שניות בלי תגית [pause] ושש שניות איתה.
מדריך בערוץ הרשמי של ElevenLabs מוסיף תהליך שימושי. ערמו תגיות על שורה אחת, למשל פתיחה עצבנית, כחכוח, ואז לחישה על מילה אחת. בתסריטים ארוכים, כפתור Auto tag סורק את הטקסט ומוסיף תגיות לפי ההקשר. אם התגיות עדיין מחטיאות, הקליטו את המשפט בעצמכם והשתמשו ב Voice Changer, כי "ככל שתתקרבו בהקלטה שלכם למסירה הרצויה, כך תתקרבו בתוצאה" (תרגום של הציטוט באנגלית).
הנחיות בשפה רגילה בכלים אחרים
כלים אחרים הולכים בדרך אחרת. המדריך של OpenAI להמרת טקסט לדיבור משתמש בשדה הוראות, עם דוגמאות כמו "Speak in a cheerful and positive tone." בדקו את התאריך לפני שאתם בונים על זה. התיעוד של OpenAI אומר שהמודלים tts 1, tts 1 hd ו gpt 4o mini tts "הוצאו משימוש ויכובו ב 6 בינואר 2027" (תרגום מאנגלית). גוגל אומרת שההמרה מטקסט לדיבור של Gemini 3.8 מאפשרת לכתוב הנחיות במה משלכם ולהוסיף רמזים כמו |mhm| למרקם שיחתי. המדריך של Hume ל Octave מציין עיקרון שנכון בכל מקום: השתמשו בטקסט קלט אקספרסיבי כדי לקבל דיבור אקספרסיבי יותר, וכתבו מילה באותיות גדולות להדגשה חזקה יותר.
התסריט משפיע יותר ממה שחשבתם
היוצר Isaac, שסרטון היוטיוב שלו עבר 735,000 צפיות, מצמצם קול AI אנושי לארבעה דברים: שינויי טון, הפסקות, הדגשה, ותסריט שלא נשפך ישר מ ChatGPT. הוא גם מייצר כמה משפטים בכל פעם ולא את כל התסריט. זו עצה שעובדת עם כל כלי קול ולא עולה כסף.
הנקודה הנגדית ההוגנת: תגיות אינן אמינות
אל תצפו שתגיות יתנהגו בכל פעם. הסוקרת Janine Heinrichs מ Unite.AI כתבה בספטמבר 2026 ש"החולשה הגדולה ביותר הייתה היענות לא עקבית לתגיות ביצוע" (תרגום מאנגלית). Isaac גילה שהוספת תגיות v3 לשכפול הקול שלו משמעותה "זה משנה קצת את הקול עצמו", ולכן חזר ל v2 עם יציבות נמוכה יותר. הסרטון שלו קדם ל v4, כך שהטענה הזו אולי כבר לא רלוונטית. התשובה המעשית: מעט תגיות, ממש לפני המילים שהן אמורות להשפיע עליהן, והאזנה לכל טייק.
עוד זהירות אחת לגבי הצהרות ביצועים. ElevenLabs אומרת ש Eleven v4 דורג מספר אחת על ידי Artificial Analysis ועדיף על כ 75% מהמאזינים בבדיקות עיוורות. אלה המספרים של ElevenLabs עצמה, וגוגל מצהירה על מקום ראשון משלה עבור Gemini 3.8 במדד אחר. בדקו עם התסריט שלכם.
טעויות נפוצות בהנחיות, ולמה אנושי אינו אומר מוסתר
רוב הקולות שמחטיאים נכשלים מאותן סיבות מעטות.
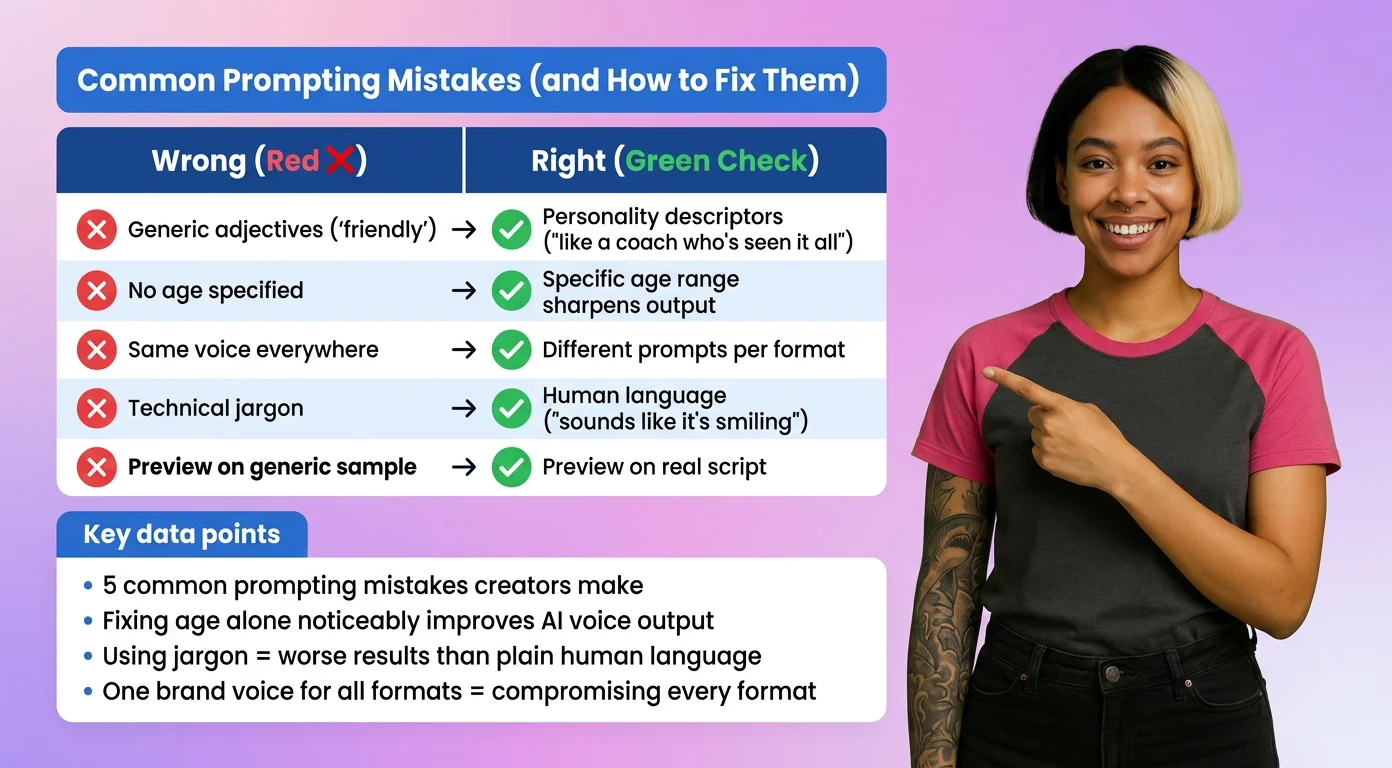
שימוש רק בשמות תואר כלליים
"מקצועי", "ידידותי", "ברור". כל קול הגון הוא כזה, ולכן המילים האלה כמעט לא נותנות ל AI כלום. החליפו אותן באישיות: "כמו מאמן מנוסה שראה הכול אבל עדיין מתלהב לעזור".
דילוג על הגיל
בלי עוגן גיל, הקול נוטה אל האמצע, שבדרך כלל בסדר ולעיתים רחוקות מצוין. ציינו את הטווח והתוצאה תחדד.
שימוש באותו קול בכל מקום
קול מותג אחד לכל פורמט לא משרת אף פורמט היטב. דף המכירה, הקליפים החברתיים וסרטוני הקליטה שלכם נושאים תפקידים שונים. תנו להם גרסאות הנחיה שונות.
כתיבת ז'רגון במקום תיאור
"שונות פרוסודית" ו"vocal fry" אולי מדויקים, אבל מודלים מגיבים טוב יותר לשפה אנושית. תארו את חוויית ההאזנה. "נשמעת כאילו היא מחייכת" מנצח "גובה צליל מוגבה עם אפנון עולה".
דילוג על תצוגה מקדימה עם תסריט אמיתי
קול יכול להבריק במשפט לדוגמה ולהיכשל בטקסט האמיתי שלכם. האזינו לשורה או שתיים מהתסריט שהוא יקריא.
ניסיון לעבור כאדם
זה עניין אתי לא פחות ממעשי. מדיניות השימוש של OpenAI "דורשת שתספקו גילוי ברור למשתמשי הקצה שקול ה TTS שהם שומעים נוצר על ידי AI" (תרגום מאנגלית). סקר של Adobe מ 2026 בקרב 850 צרכנים אמריקאים מצא ש 88% שמעו קול ושאלו את עצמם אם זה AI, בעוד ש 77% עדיין סומכים הכי הרבה על קולות אנושיים. Adobe מוכרת כלי אודיו מבוססי AI, ולכן קראו זאת כמחקר של ספק. הקריאה הסבירה של "להישמע אנושי" היא מסירה טבעית, חמה ובקצב טוב, לא הסתרה שמכונה מדברת.
שכפולי קול מעלים את הסיכון. מחקר של PLOS One מ 2025 מצא שמאזינים לא הצליחו להבדיל באופן אמין בין שכפולי קול לקולות אנושיים אמיתיים, אך זיהו קולות AI גנריים. המדגמים היו קטנים, 50 משתתפים בכל ניסוי, אך הלקח ברור: אם הקול שלכם יכול להטעות אנשים, תגידו זאת.