
Was wirklich passiert, wenn ein Foto sprechen lernt
Unter der Haube arbeiten die meisten Werkzeuge für sprechende Fotos mit KI mit einer Variante desselben Ablaufs. In einer Diskussion auf r/generativeAI beschrieben Nutzer ihn in zwei Stufen: Zuerst verleiht ein Modell zur Gesichtsreanimation dem Standbild natürliche Bewegung, dann formt ein audiogesteuertes Lippensynchronisationsmodell den Mund passend zu jedem Laut der Sprachspur. Die Open Source Namen, die immer wieder fallen, sind SadTalker und LivePortrait für die Bewegung und Wav2Lip für den Mund, während D-ID und HeyGen ähnliche Schritte in ein Produkt packen.
Warum der Mund der schwierigste Teil ist
Die Forscher hinter MuseTalk, einem Modell zur Lippensynchronisation, das in einem Paper auf arXiv beschrieben wird, sehen das Problem als Trilemma. Diffusionsbasierte Verfahren sehen großartig aus, sind aber teuer im Betrieb. Schnellere GAN Verfahren opfern meist entweder die Genauigkeit der Lippen oder die „Zahndetails“, was die höfliche akademische Umschreibung dafür ist, dass die Zähne matschig werden. MuseTalk arbeitet in einem komprimierten latenten Raum, um Tempo und Detail zu verbinden, und meldet 30 Bilder pro Sekunde bei 256 mal 256 Pixeln auf einer einzigen NVIDIA V100 Grafikkarte.
Diese Auflösung sollten Sie sich merken. Das Modell zeichnet nur einen kleinen Bereich um den Mund neu und fügt ihn dann wieder in Ihr Bild in voller Größe ein. Ist das Gesicht klein, abgewandt oder schlecht beleuchtet, gibt es weniger echte Details, mit denen es arbeiten kann, und genau dort bricht die Illusion meist zusammen.
Worauf Sie beim Prüfen achten sollten
Ein Creator, der HeyGen in einem direkten Vergleich auf YouTube mit einem günstigeren Werkzeug verglich, gab eine nützliche Checkliste: Achten Sie auf die Mundwinkel, darauf, was der Kopf am Satzende macht, und hören Sie auf harte Konsonanten wie P und B, denn dort „fallen günstigere Lippensynchronisationstools meist komplett auseinander“.
Das hochgeladene Foto entscheidet über den Großteil des Ergebnisses
Jede Plattform kann nur animieren, was im Bild steckt, deshalb verdient das Ausgangsfoto mehr Sorgfalt als die Einstellungen. Die Tipps von Leuten, die solche Videos jede Woche produzieren, decken sich weitgehend.
- Blicken Sie in die Kamera. Ein Hedra Tutorial vom Februar 2026 empfiehlt ein scharfes, gut beleuchtetes Foto mit direktem Blick ins Objektiv und rät von Profilansichten und unscharfen Aufnahmen ab. Es weist auch darauf hin, dass Hedra Bilder unter 300 Pixeln ablehnt.
- Starten Sie neutral. Dasselbe Tutorial rät zu einem neutralen Gesichtsausdruck, wenn das Ergebnis steif wirkt, dazu besseres Licht und sauberer Ton, denn klares Audio „verbessert die Genauigkeit der Lippensynchronisation“.
- Halten Sie Clips kurz. „Kürzere Clips wirken realistischer“, heißt es im Tutorial. Teilen Sie ein langes Skript lieber in mehrere kurze Videos auf als in eine lange Aufnahme.
- Dämpfen Sie die Bewegung. Eine Creatorin, die in ihrer HeyGen Anleitung Avatare aus einem einzigen Bild erstellt, ergänzt einen eigenen Bewegungsprompt mit der Bitte um einen natürlichen Look, wenig sichtbare Zähne und keine Hände, weil die Standardeinstellung Figuren übertrieben ausdrucksstark machen kann.
- Liefern Sie mehr als ein Foto, wenn möglich. HeyGen empfiehlt, ein paar zusätzliche Fotos von sich hochzuladen, damit das Modell mehr Details erfassen kann.
Die Stimme zählt genauso viel wie das Gesicht. Eine flache, gehetzte Sprachspur lässt selbst einen perfekten Mund falsch wirken. Schreiben Sie das Skript zum Sprechen, lesen Sie es einmal laut vor und streichen Sie jeden Satz, über den Sie stolpern, bevor Sie irgendetwas generieren.
BIGVU, HeyGen und Hedra im Vergleich: was Sie jeweils bekommen
Alle drei machen aus einem Foto einen sprechenden Avatar, richten sich aber an unterschiedliche Käufer. Das zeigt jeder Anbieter derzeit auf seinen eigenen Seiten.
BIGVU AI Talking Photo
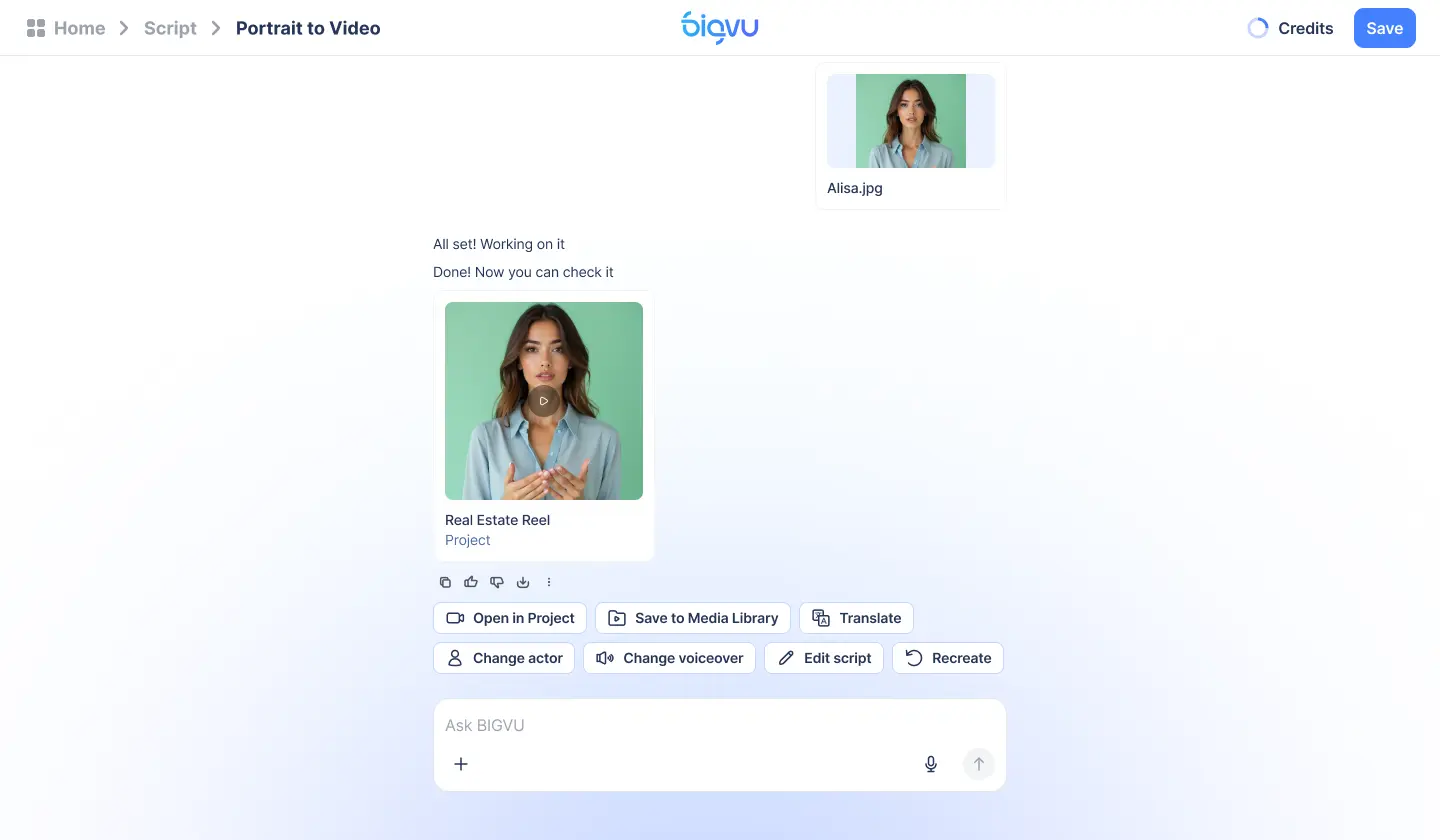
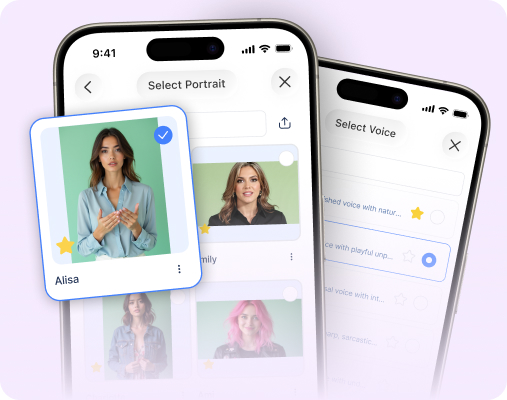
AI Talking Photo von BIGVU funktioniert in drei Schritten: Porträt hochladen, Skript und Stimme hinzufügen, dann generieren und veröffentlichen. Sie können das Skript selbst schreiben oder mit dem AI Script Generator entwerfen und eine Stimme aus der Bibliothek von BIGVU wählen oder Ihre eigene klonen. Das lippensynchrone Video bleibt anschließend in derselben App für Untertitel, Ihr Brand Kit und die Veröffentlichung, und Sie können im Web, auf dem iPhone oder unter Android arbeiten. KI Funktionen verbrauchen monatliche Credits, und die Preisseite übersetzt sie in Videozeit: Die 500 Credits des kostenlosen Tarifs reichen für ein Porträtvideo von etwa 10 Sekunden, die 3.000 Credits von AI Pro für rund eine Minute.
HeyGen Photo Avatar
Die Photo Avatar Seite von HeyGen wirbt mit sprechenden Fotos in mehr als 175 Sprachen und Dialekten, Textprompts und Look Packs, die Outfit oder Hintergrund ändern, sowie mit der Engine Avatar IV, die aus einem einzigen Bild ein Video mit Stimmsynchronisation und Handgesten macht. Laut Preisseite bietet der kostenlose Tarif 3 Videos pro Monat mit Wasserzeichen und jeweils bis zu 1 Minute, Creator kostet 29 Dollar im Monat mit 600 Credits und Pro 49 Dollar im Monat mit 1.000 Credits und Videos bis zu 30 Minuten.
Hedra
Die Preise von Hedra sind die feingliedrigsten der drei. Über die API beginnt die Erstellung von Avataren und Lippensynchronisation bei 2,5 Cent pro Sekunde aus einem vorausbezahlten Dollarguthaben, ohne Abo, und das Klonen von Stimmen ist kostenlos. Wer lieber die Studio App nutzt, findet Tarife von Basic für 20 Dollar im Monat mit 2.000 Credits über Pro für 50 Dollar mit 7.200 Credits bis Ultra für 100 Dollar mit 18.000 Credits.
Das Beste oder das Lohnendste
Der Creator hinter dem direkten Vergleich war deutlich: HeyGen gewann beim Realismus, „es ist nicht einmal knapp“, trotzdem nutzt er das günstigere Werkzeug häufiger, weil sein Avatar ein Video nur 60 bis 80 Sekunden lang eröffnet, bevor Bildschirmaufnahmen übernehmen. Seine Regel passt zu all diesen Videotools mit KI. Ist das Gesicht das Produkt, zahlen Sie für die realistischste Option. Ist das Gesicht nur eine kurze Einleitung, reicht gut genug.
Wo sprechende Fotos sich lohnen und wo nicht
Sprechende Fotos glänzen bei wiederkehrenden Botschaften, die ein Gesicht brauchen, aber kein Drehteam. BIGVU nennt Marktberichte, Updates zu Immobilienangeboten, Viertelporträts, FAQs, Aktionen, interne Ankündigungen und Produkterklärungen als typische Einsätze, und der gemeinsame Nenner ist die Wiederholung. Mit einem freigegebenen Porträt produzieren Sie das fünfte Update des Monats, ohne jemandes Zeit zu blockieren.
Gute Einsätze
- Kurze Intros und regelmäßige Updates. Ein vertrautes Gesicht in der ersten Minute, danach Folien, Demos oder Aufnahmen der Immobilie.
- Marketing per Videomail. Ein persönlicher Gruß zu Beginn einer Nachfassmail wirkt wärmer als reiner Text. Mit dem Video Email Tool von BIGVU verschicken Sie ihn aus demselben Konto.
- Exposés ohne Dreh. Makler können ein Intro als sprechendes Foto mit Fototale kombinieren, das vorhandene Objektfotos in ein Video mit Schwenks, Zooms und Übergängen verwandelt.
Schwache Einsätze
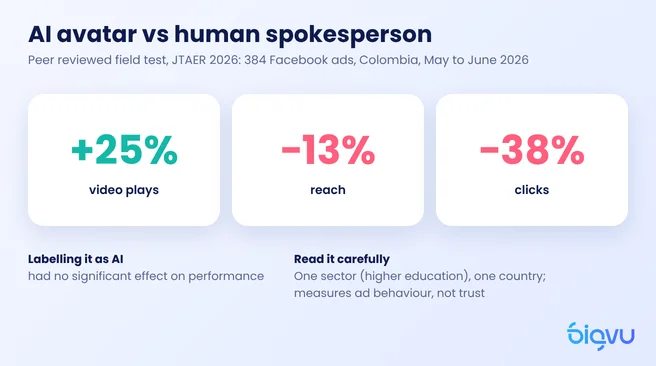
Vorsicht dort, wo Vertrauen alles ist. Ein begutachteter Feldtest mit 384 Facebook Anzeigen, 2026 im Journal of Theoretical and Applied Electronic Commerce Research veröffentlicht, ergab, dass ein KI Avatar 25 % mehr Videowiedergaben erzielte als ein menschlicher Sprecher, aber 13 % weniger Reichweite und 38 % weniger Klicks. Die Studie untersuchte Anzeigen für Hochschulbildung in Kolumbien, sehen Sie sie also als einen Datenpunkt, nicht als Gesetz. Trotzdem passt sie zum Rat des YouTube Creators von oben: Für Kundenprojekte, eine Marke mit festem Gesicht oder alles, was ein zahlender Kunde Bild für Bild prüfen wird, empfiehlt er das realistischste Werkzeug, das Sie sich leisten können, oder eine echte Aufnahme.
Kennzeichnung, Einwilligung und die neuen Regeln
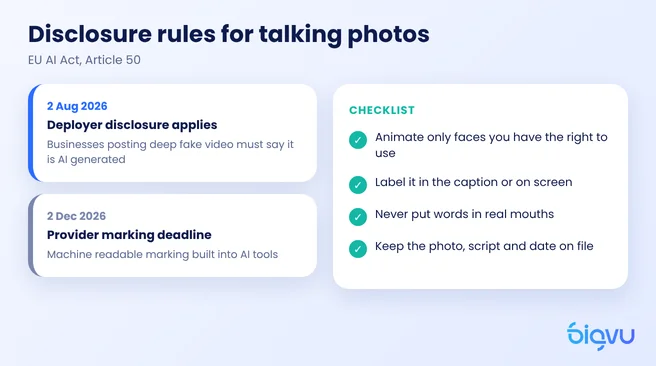
Die Ethik sprechender Fotos war früher eine Frage guter Manieren. In der Europäischen Union ist sie jetzt auch eine rechtliche Pflicht. Artikel 50 der KI Verordnung der EU schreibt vor, dass Betreiber eines KI Systems, das Videoinhalte erzeugt oder manipuliert, die einen Deepfake darstellen, offenlegen müssen, dass die Inhalte künstlich erzeugt oder manipuliert wurden, und zwar spätestens dann, wenn ein Zuschauer sie zum ersten Mal sieht. Wie Morgan Lewis erläuterte, gelten diese Transparenzpflichten seit dem 2. August 2026. Eine separate Übergangsfrist von vier Monaten bis zum 2. Dezember betrifft nur die maschinenlesbare Kennzeichnung, die Anbieter einbauen müssen, und schiebt die Pflichten der Unternehmen, die die Videos veröffentlichen, nicht auf.
Eine einfache Checkliste
- Animieren Sie nur Gesichter, die Sie verwenden dürfen. Ihr eigenes oder das einer Person, die ausdrücklich zugestimmt hat. Nie einen Kunden, einen Wettbewerber oder einen Prominenten ohne Einwilligung.
- Kennzeichnen Sie es. Eine kurze Zeile in der Beschreibung oder im Bild, etwa „Dieses Video nutzt ein sprechendes Foto mit KI“, erfüllt die Grundpflicht und kostet Sie kaum etwas.
- Legen Sie echten Menschen keine Worte in den Mund. Ein sprechendes Foto von Ihnen, das Ihr eigenes Skript vorliest, ist eine Sache. Jemanden scheinbar etwas befürworten zu lassen, das er nie gesagt hat, eine ganz andere.
- Dokumentieren Sie. Bewahren Sie Originalfoto, Skript und Datum auf, falls jemand fragt, wie ein Video entstanden ist.
Falls Sie fürchten, dass ein Hinweis die Ergebnisse schmälert, beruhigt dieselbe Studie zu Facebook Anzeigen: Der Hinweis, dass die Anzeige mit KI erstellt wurde, hatte keinen signifikanten Einfluss auf die Leistung. Ehrlichkeit kostet hier nichts.